Исследователи утверждают, что внутреннее устройство ИИ может быть понятнее, чем предполагалось ранее
Подробнее
TechCentral
techcentral.co.za

Исследователи утверждают, что внутреннее устройство ИИ может быть понятнее, чем предполагалось ранее

Появилось утверждение о том, что модели искусственного интеллекта гораздо проще понять, чем полагали исследователи, что привлекло значительное внимание в области безопасности ИИ. Однако академики из Южной Африки предупреждают, что эти выводы пока не прошли проверку и не рецензированы.

Ник Каммарата, исследователь стартапа Goodfire, который ранее работал в OpenAI, выдвигает эту гипотезу в своем документе, названном «неформальным исследовательским эссе и рабочей гипотезой». Он утверждает, что «каноническое свидетельство полисемантичности и суперпозиции, которое убедило большую часть научного сообщества, включая меня, в произвольном упаковке концепций в сетях, было неверно истолковано».

Он пояснил изданию MIT Technology Review: «Мы смотрели на это неправильно». Стивен Бойкей Сидли, приглашенный профессор Университета Родса, считает, что природа «черного ящика» ИИ, которую не могут расшифровать даже его создатели, лежит в основе многих опасений относительно него.

Сидли отметил, что «это вызывало беспокойство, потому что если вы не можете понять, как думает ИИ, то как вы можете предотвратить его совершение плохих поступков, например, побуждение кого-либо к самоубийству? Это суть того, что называется согласованием ИИ». Он добавил, что «статья Каммараты предполагает, что внутри нейронной сети ИИ нет такой сложности — мы просто смотрели на нее через неверную призму. Его частичные и (пока) непроверенные результаты многообещающи, поскольку они дают надежду на то, что мы сможем сделать ИИ нашим подчиненным инструментом, а не неуправляемым и непокорным ребенком, каким он является сейчас».

Кошки, автомобили и буква V

В эссе рассматривается известный пример в области интерпретируемости — дисциплине, целью которой является выяснение процессов, происходящих внутри моделей ИИ. В модели распознавания изображений Google Inception v1 от 2014 года нейрон 4e:55, активирующийся при обнаружении определенной черты, реагировал как на кошек, так и на автомобили.

В работе «Zoom in» от 2020 года, которую Каммарата соавторствовал в рамках проекта под руководством Криса Олаха, ныне руководителя исследований по интерпретируемости в Anthropic, этот нейрон считался хрестоматийным примером смешивания несвязанных концепций. Однако Каммарата теперь утверждает, что связывает их общая форма буквы V: заостренный профиль кошки и передняя часть автомобиля, увиденная под углом. Этот же нейрон срабатывает и на угол настольного бильярда, и на нос скоростного поезда, в то время как круглые формы вызывают обратную реакцию.

Обновление эссе от 30 октября подчеркивает, что нейрон по-прежнему распознает кошек и автомобили, при этом общая особенностью выступает форма V. Каммарата сообщил изданию MIT Technology Review, что ему потребовалось всего пять секунд, чтобы изучить модель, над которой он работал «вероятно, тысячи часов».

Он полагает, что если большинство нейронов выполняют одну основную функцию, исследователи смогут анализировать модели, не прибегая к предварительному обучению второй модели для их расшифровки. Предварительные проверки модели Qwen3-32B от Alibaba показывают, что примерно 90% «полярностей нейронов» — положительных и отрицательных концов активности нейрона — имеют одну основную задачу; около 7% выполняют две связанные задачи, а 2–4% еще не изучены, хотя эти цифры зависят от пороговых значений. При этом проект, который он начал в OpenAI в 2023 году, обнаружил, что лишь около 1,7% нейронов можно интерпретировать «по нашей самой щедрой оценке».

Еще не прошла рецензирование

Профессор Бенджамин Розман, основатель Института разума Университета Витс, который был включен в список 100 самых влиятельных людей в сфере ИИ журнала Time в 2025 году, назвал это «интересным и потенциально очень обнадеживающим развитием для безопасности ИИ». Тем не менее, он подчеркнул: «исследование еще не прошло рецензирование, и слишком рано делать сильные выводы о том, что это означает для безопасности ИИ».

Другие высказывают больший скептицизм. Нил Нанда из Google DeepMind написал в X, что «это интересная работа, но я не думаю, что это значимое обновление общей картины интерпретируемости». Джейкоб Хилтон из Центра исследований согласованности добавил: «Для полного понимания нам нужно выйти за рамки нейронов и объяснить, как они соединяются, образуя цепи».

Розман заключил, что «даже если мы станем намного лучше понимать, как работают эти системы, это не обязательно означает, что мы знаем, как заставить их вести себя безопасно».
Похожие сюжеты

Модель ИИ OpenAI решила проблему Навье-Стокса и представила исследования по математическим задачам
Подробнее
cgtn.com

Модель ИИ OpenAI решила проблему Навье-Стокса и представила исследования по математическим задачам

Компания OpenAI недавно объявила, что ее модель искусственного интеллекта смогла решить проблему Навье-Стокса, которая вызывала затруднения у математиков на протяжении почти столетия.

Кроме того, разработчики выпустили 722 рукописи, в которых подробно описан прогресс в решении 372 математических задач.

Эти открытия вызвали потрясение среди математиков, которые теперь задаются вопросами о том, как это повлияет не только на их текущую работу, но и на будущее всей их профессии.

Vignesh Subrahmaniam из Intuit обсуждает переход от промпт-инжиниринга к созданию действующих систем искусственного интеллекта
Подробнее
yourstory.com

Vignesh Subrahmaniam из Intuit обсуждает переход от промпт-инжиниринга к созданию действующих систем искусственного интеллекта

В последние годы улучшение результатов работы с ИИ зависело от умения писать более качественные запросы (промпты). Однако эта парадигма быстро меняется, поскольку системы ИИ начинают самостоятельно рассуждать, принимать решения и выполнять действия в рамках целых рабочих процессов.

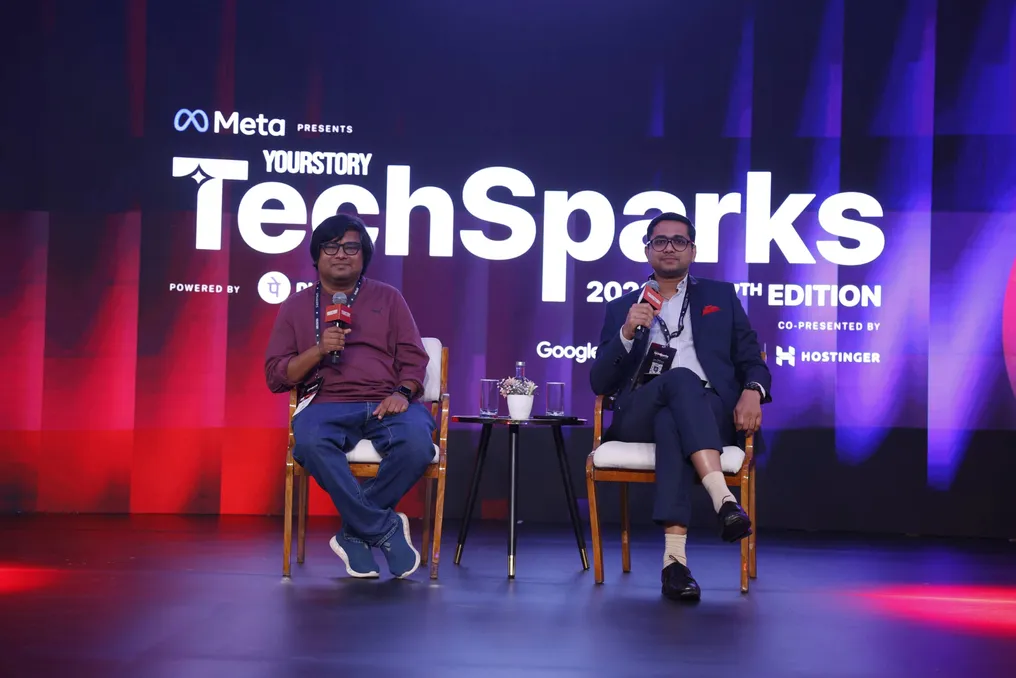
На мероприятии TechSparks 2026, флагманском событии YourStory, доктор Вигнеш Субрахманиам, ведущий научный сотрудник по ИИ в Intuit, провел беседу с Адитом Чарли, управляющим редактором YourStory и The CapTable. Обсуждение под названием «За пределами промпта: создание ИИ, который мыслит, действует и обучается» было посвящено тому, что разработчикам необходимо переосмыслить по мере того, как интеллект становится все более автономным.

Сессия началась с вопросов о типичном рабочем дне Субрахманиама и просьбы упростить концепции финтеха и ИИ для аудитории. Он использовал аналогию с шахматами, задав вопрос: если алгоритму не преподавать правила шахмат, а показать миллион завершенных партий с победителями, сможет ли он вывести и правила, и наиболее вероятные стратегии для победы?

Команда Intuit применяет схожий подход для поддержки малого бизнеса, поскольку компания обслуживает как потребителей, так и бухгалтеров. Субрахманиам отметил: «Как мы изучаем игру бизнеса, анализируя данные, реальные действия и результаты, которые предпринимают предприятия». Цель состоит в понимании факторов, способствующих успеху бизнеса в привлечении клиентов, быстром росте и улучшении денежного потока.

Далее разговор перешел к смене парадигмы для разработчиков: от многолетнего изучения написания более умных промптов к проектированию агентов, которым ставится цель, и они сами определяют шаги для ее достижения. Субрахманиам сравнил промпт-инжиниринг с долгой историей языков программирования, начиная от двоичного кода и ассемблера до Fortran, C и Python. Большие языковые модели позволили любому человеку программировать на простом английском языке, однако этот метод имеет свои ограничения.

Исследователи быстро поняли, что интеллект не должен находиться только в самой модели. Модель должна выступать в роли оркестратора, разбивая сложную задачу на последовательность действий и вызовов инструментов. Реальный интеллект перемещается в инструменты, которые вызываются; и эти инструменты также должны быть разработаны иначе: «не для того, чтобы ими мог пользоваться человек, или разработчик программного обеспечения, или кто-либо еще, а таким образом, чтобы оркестратор LLM мог ими действительно пользоваться».

Это требует создания высокоточных инструментов с крайне детерминированным результатом. Для разработчиков мастерство смещается от остроумных формулировок к надежным компонентам, которые модель может вызывать снова и снова без неожиданностей.

Относительно источников новых данных, Субрахманиам открыто заявил, что обучение на текстовых данных в значительной степени решено. Более сложная задача заключается в обучении на мультимодальных источниках и реальных действиях. Он привел пример того, как маленький ребенок в основном учится через то, что видит, слышит и наблюдает, а не через чтение, утверждая, что включение таких сигналов из реального мира в системы ИИ поможет моделям выйти за рамки генерации текста и начать предлагать действия. Он назвал это следующим рубежом.

Рассматривая проблемы регулируемой отрасли, он вернул аудиторию на 18 лет назад, в одну из первых лабораторий машинного обучения в Бангалоре, где он работал над логистической регрессией и многослойными перцептронами. Тогда самой большой проблемой была не сам алгоритм. Он вспомнил: «На самом деле, это было качество данных».

Эта проблема не изменилась. Независимо от того, обучает ли команда простую регрессию или дообучает трансформер, принцип «мусор на входе — мусор на выходе» остается в силе. По его словам, компании, способные собирать, агрегировать и хранить данные самого высокого качества, получат преимущество.

Во время короткой сессии вопросов и ответов один из участников спросил, как ограничения на хранение финансовых данных влияют на работу Intuit. Субрахманиам назвал согласие основой любой обучающей системы и сослался на исследование Фрамингем, где жители города Массачусетс разрешили врачам отслеживать их здоровье с течением времени, что сформировало современное понимание сердечно-сосудистых заболеваний. Он добавил, что компании также обязаны объяснять широкой общественности преимущества использования данных.

По мере завершения беседы сквозной идеей стало то, что по мере перехода ИИ от реагирования к действию, основы становятся важнее интерфейса. Промпты останутся отправной точкой, но настоящая работа теперь заключается в создании надежных инструментов, которые могут вызывать агенты, снабжении систем высококачественными данными и получении согласия, которое позволяет им обучаться. Именно здесь, за пределами промпта, будет выиграна следующая волна ИИ для разработчиков.

Популярное