Moxin Technology представила MoWorld 2.0 — 4D модель мира с симуляцией физики на базе Ascend
Подробнее
Pandaily
pandaily.com

Moxin Technology представила MoWorld 2.0 — 4D модель мира с симуляцией физики на базе Ascend

Компания Moxin Technology представила MoWorld 2.0, четырехмерную модель мира, которая была обучена и запущена непосредственно на оборудовании Huawei Ascend. Презентация состоялась на форуме Всемирной интернет-конференции в Учжэне 4 ноября.

Этот релиз является развитием предыдущей версии MoWorld 1.0, выпущенной в июле. Основным улучшением, по заявлению компании, стала реализация физических процессов. MoWorld 2.0 интегрирует такие факторы, как гравитация, эластичность, плавучесть, освещение и тепло, а также свойства твердых тел, мягких тел, жидкостей и деформируемых материалов в процесс построения и взаимодействия с пространством.

Результатом работы являются 4D Гауссовы активы, которые могут использоваться для симуляций, рендериться в режиме реального времени и многократно применяться. Благодаря моделированию множества физических аспектов, Moxin утверждает, что модель генерирует не только внешний вид пространства и объектов, но и в реальном времени определяет, как взаимодействуют предметы, как на них действуют внешние силы и как изменяется окружающая среда.

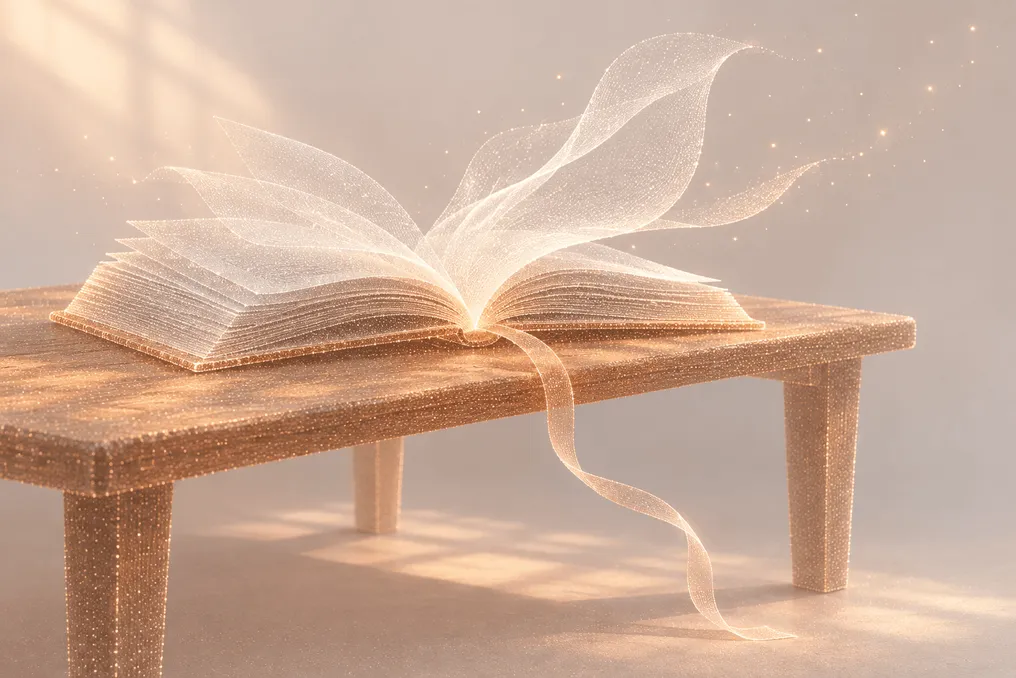
В ходе демонстрации было показано, как легкий ветерок заставляет страницы книги шевелиться, а закладка падает на пол. Для этого потребовалось учесть силу и направление ветра, гибкость бумаги, вес закладки и жесткость пола. Другие примеры демонстрируют сцены, которые можно редактировать и с которыми можно взаимодействовать, а также возможность ускорения или замедления времени.

MoWorld 2.0 была разработана и запущена на полностью отечественной вычислительной базе Ascend. Moxin сообщила, что сотрудничала с командами Huawei над оптимизацией систем инференса, много-NPU планированием и обучением длинных последовательностей. По собственным оценкам, стоимость инференса может снизиться до 30% от стоимости установки GPU аналогичного масштаба.

Компания также отметила прирост скорости: видеоинференс увеличился с пиковых 50 кадров в секунду в версии 1.0 до примерно 70 кадров в секунду. Рендеринг 3D и 4D Гауссовых активов превышает 500 кадров в секунду, а тесты на мобильных телефонах достигают около 100 кадров в секунду. Ранее Moxin представляла облегченную версию MoWorld на телефоне Mate 90 от Huawei.

Moxin работает с партнерами над валидацией и внедрением технологии в различных областях. Для воплощенного ИИ (embodied AI) MoWorld 2.0 создает виртуальные среды с пространственной структурой и базовой физической обратной связью, позволяя роботам тренироваться и повторять действия в симуляции. В сфере автономного вождения модель генерирует сценарии с редкими явлениями, такими как дождь, снег, выбоины и внезапные препятствия. Другие области применения включают создание промышленных цифровых двойников производственных линий и шахт, городское планирование, виртуальный туризм, а также создание повторно используемых сцен для кино- и игрового производства, поддерживающих свободное движение камеры, редактирование объектов и изменение погоды.
Похожие сюжеты

AgiBot представила робота GO-3 Preview, который занял первое место в трех рейтингах и планирует стать открытым проектом
Подробнее
pandaily.com

AgiBot представила робота GO-3 Preview, который занял первое место в трех рейтингах и планирует стать открытым проектом

Компания AgiBot выпустила модель GO-3 Preview 29 октября. Эта воплощенная модель искусственного интеллекта способна продолжать обучение в масштабе на всех этапах: во время предварительного обучения, после него и уже после внедрения в работу. AgiBot намерена сделать полную модель общедоступной к концу 2026 года.

GO-3 Preview основан на архитектуре, которую AgiBot называет WRAM, или Моделью Действий Рассуждения о Мире. Эта архитектура связывает рассуждение о задаче, прогнозирование будущих событий и генерацию действий, позволяя роботу понять инструкцию, предвидеть результат и выполнять соответствующие движения.

Модель недавно завоевала первое место в трех рейтингах для воплощенного ИИ: RoboDojo, RoboTwin и RoboColiseum. AgiBot утверждает, что модель масштабируется по двум направлениям. С одной стороны, богатые примеры обработки объектов и развития задач предоставляются видеозаписями людей от первого лица, а траектории роботов связывают наблюдения с действиями и физическими результатами.

С другой стороны, более высокая обучающая способность модели превращает этот разрозненный опыт в навыки, которые могут быть применены к новым задачам. После предварительного обучения компания отмечает, что роботы могут выполнять незнакомые задачи в домах, на кухнях, в системах с несколькими роботами и осуществлять тонкую манипуляцию без дополнительной тонкой настройки.

При помощи нескольких демонстраций модель способна осваивать длительные и деликатные операции, например, приготовление дзяньбина — китайского пикантного блинчика. После тонкой настройки и координации шагов агентом, робот также может собирать детали Лего.

Для этапа после обучения AgiBot разработала систему распределенного обучения Genie Evolver, которая объединяет около ста реальных роботов с симуляцией физики и моделями мира. В игре по керлингу на столе робот обошел среднего протестированного человека после четырех часов онлайн-тренировок. В игре с башнями из блоков он смог вытащить пять блоков подряд, сохраняя устойчивость башни.

После внедрения агентская структура Genie Master обеспечивает связь между суждением, исполнением и обратной связью, позволяя роботам непрерывно совершенствоваться в процессе работы. Робот AgiBot G2, работавший в реальном круглосуточном магазине, самостоятельно обнаружил причины собственных сбоев, скорректировал свой подход и сохранил полученные знания без участия человека или настройки. Успешность этого робота на полном рабочем процессе возросла с 28,6 процента в первый день до стабильных 85,7 процента через пять дней.

В задаче, подобной повешению небольших крючков, AgiBot заявляет, что этот метод повысил успех выполнения отдельной задачи на 17,7 процентных пункта по сравнению с традиционной контролируемой тонкой настройкой, и процесс обучения продолжается онлайн.

MOSI и OpenMOSS выпустили модель MOSS-Image с открытым исходным кодом для контроля текста и макета
Подробнее
pandaily.com

MOSI и OpenMOSS выпустили модель MOSS-Image с открытым исходным кодом для контроля текста и макета

Команда MOSI Intelligence совместно с командой OpenMOSS представила MOSS-Image — систему преобразования текста в изображение с 5 миллиардами параметров. Эта система предназначена для создания графических материалов, таких как продуктовые снимки и плакаты, где критически важны не только высокое качество изображения, но и плотное размещение текста и точное соблюдение макета.

В рамках релиза доступны версии MOSS-Image-Base и вариант, прошедший контролируемую тонкую настройку, MOSS-Image-SFT. Веса этих моделей размещены на платформах Hugging Face и ModelScope под лицензией Apache 2.0. Технический отчет указывает, что в разработке участвовали MOSI Intelligence, Шанхайский институт инноваций (SII), Фуданьский университет и Шанхайский университет Цзяотун.

В течение нескольких дней после запуска 16 октября китайские технологические СМИ сообщили, что модель заняла лидирующие позиции в списке трендов text-to-image на Hugging Face. Активность сообщества была высокой: количество загрузок и звезд на GitHub быстро росло, а официальный репозиторий превысил 1,4 тысячи звезд. Следует отметить, что эти показатели являются данными сообщества, а не проверенными метриками компании, и они постоянно меняются из-за появления множества зеркал и дистиллированных контрольных точек.

Разработчики на площадках Reddit и X уже опубликовали сравнительные тесты с другими моделями с открытыми весами. Сообщество также выпустило дистилляции с шагами 8 и 4, пакеты квантования и рабочие процессы для ComfyUI.

Основное преимущество, которое предлагает команда, — это контроль. MOSS-Image принимает запросы длиной до 4096 токенов и может использовать структурированный JSON-макет, который определяет текст и объекты с помощью ограничивающих рамок, вместо того чтобы полагаться исключительно на композицию, заданную естественным языком. Согласно тесту команды на Long Long Text Benchmark, модель демонстрирует среднее покрытие текста на уровне 96,3 процента среди моделей с открытыми весами.

На бенчмарке RealLayoutArena, который является слепым тестом дизайна от начала до конца, оценка Elo модели составляет 1698,70. Этот показатель уступает GPT Image 2 при использовании кратких дизайнерских заданий, но достигает 1807,34 при применении общих улучшенных подсказок, что ставит ее на первое место во второй группе согласно собственной системе оценки команды.

Архитектурно MOSS-Image представляет собой диффузионный трансформер с единым потоком, предварительно обученный с нуля. Единый генеративный путь питается замороженным текстовым энкодером Qwen3.5-9B и вариационным автоэнкодером FLUX.2. По данным команды, рецепт обучения предусматривает фильтрацию изображений, созданных ИИ, для сохранения большего фотографического разнообразия, а обучение проводилось на гетерогенных GPU-платформах. Адаптеры для Diffusers, ComfyUI, SGLang и vLLM-Omni уже доступны, а хостинговый API запущен на платформе MOSI.

Предоставление открытых весов дает дизайнерам и разработчикам агентов компактную основу для работы, требующей сложного макета, без необходимости ожидать доступа к закрытому API. Стоит подчеркнуть, что все приведенные показатели бенчмаркинга и рейтинги основаны на отчете команды и данных сообщества, и их следует рассматривать как самоотчетные или собранные из сообщества сигналы, а не как независимые лабораторные результаты.

ShengShu транслирует процесс обучения Motubrain 2.0 перед открытием модели
Подробнее
pandaily.com

ShengShu транслирует процесс обучения Motubrain 2.0 перед открытием модели

Команда по мировым моделям компании ShengShu Technology начала прямую трансляцию полного процесса обучения Motubrain 2.0, следующей версии ее модели воплощенного искусственного интеллекта для роботов. Трансляция стартовала 21 октября и запланирована на продолжительность около двух недель.

Компания сообщила, что Motubrain 2.0 скоро будет выпущена в открытый доступ, и решила продемонстрировать процесс обучения до этого релиза.

Модели Motubrain представляют собой семейство фундаментальных моделей роботов от ShengShu, цель которых — предоставить роботам универсальный мозг, способный применять навыки в различных задачах, сценариях и на разных типах роботов. Первая версия Motubrain была представлена в апреле как модель мирового действия. Стоит отметить, что ShengShu более известна своими моделями генерации видео Vidu.

Структура трансляции

Прямая трансляция разделена на четыре этапа. Этап предварительного обучения исследует, как масштаб обучения влияет на производительность и способность к обобщению в условиях нулевого выстрела. Последующее обучение фокусируется на выполнении конкретных задач для улучшения исполнения. Затем следует этап задач агента, который проверяет, может ли модель переносить полученные знания на другие задания. Финальный этап посвящен рекурсивному самосовершенствованию, чтобы выяснить, способен ли модель оценивать свои действия на основе обратной связи от выполнения и улучшать их.

На странице трансляции в режиме реального времени отображаются шаги обучения и показатели успешности оценки по мере их обновления.

Основная идея этой демонстрации — прозрачность. Обычно прогресс в области воплощенного ИИ оценивается внешними наблюдателями через отполированные демонстрации роботов, таблицы бенчмарков и научные статьи, которые мало раскрывают, как именно формируются возможности в процессе обучения или какие проблемы возникают. ShengShu утверждает, что трансляция покажет не только успехи, но и ошибки, процесс проб и ошибок, а также корректировки, и надеется поделиться с другими исследователями открытыми вопросами, касающимися масштабирования, кросс-задачного обобщения и автономного улучшения.

Этот шаг соответствует более широкой тенденции среди китайских команд в сфере ИИ, которые публично делятся прогрессом обучения. Ранее Ло Фули, руководитель моделей MiMo от Xiaomi, опубликовал детали этапа обучения с подкреплением для MiMo-V2.6.

Тем не менее, существуют ограничения тому, что может доказать прямая трансляция. Веса модели еще не выпущены, и сама компания заявляет, что исследование остается исследовательским, и результаты потребуют последующих экспериментов и оценки для подтверждения. Анонс был предоставлен ShengShu и освещен китайскими технологическими СМИ. Реальным испытанием станет выпуск в открытый доступ и соответствие его бенчмарков тому, что показано в стриме.

Популярное