GPUWorks открыла платформу для инференса с поддержкой Ascend, PPU, Hygon и NVIDIA в одном кластере
Подробнее
Pandaily
pandaily.com

GPUWorks открыла платформу для инференса с поддержкой Ascend, PPU, Hygon и NVIDIA в одном кластере

GPUWorks, представляющая собой легковесную корпоративную платформу для инференса искусственного интеллекта, была выпущена с открытым исходным кодом под лицензией Apache-2.0 4 ноября. Информация об этом была опубликована изданием IT Home. Код доступен на GitHub в организации FlitAI, позволяя предприятиям и разработчикам использовать, модифицировать его или вносить вклад в шаблоны инференса и адаптации чипов.

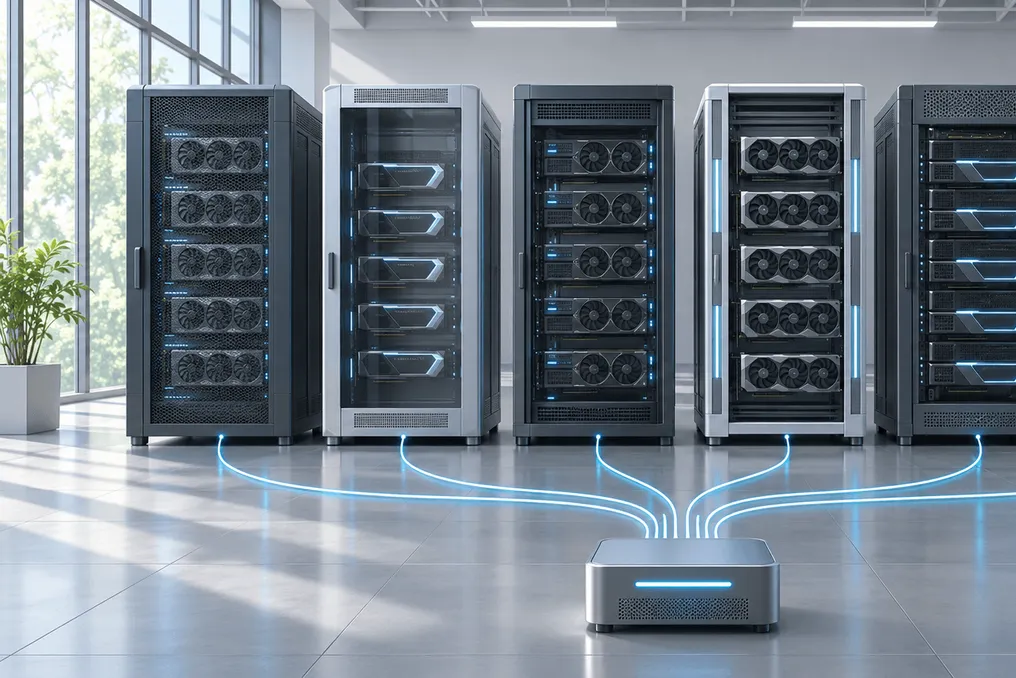
Данная платформа объединяет ускорители от различных производителей и источников в единый управляемый пул. Она осуществляет сопоставление моделей с аппаратным обеспечением, оценивает требования к памяти GPU и развертывает модели из шаблонов, после чего предоставляет к ним доступ через API, совместимый с OpenAI. Среди поддерживаемых чипов фигурируют NVIDIA и AMD, а также Huawei Ascend, T-Head PPU и Hygon DCU.

Серверы с bare-metal, виртуальные машины и облачные контейнеры могут функционировать в одном кластере, независимо от того, находятся ли они в собственных центрах обработки данных компании, частных или публичных облаках.

Особенности и производительность платформы

Разработчики особо отмечают компактность решения: установщик весит чуть более 40 МБ, устанавливается одной командой примерно за 60 секунд и не требует использования Kubernetes. Пользователи внутренней сети могут загрузить установщик, файлы моделей и образы среды выполнения в автономном режиме. Каталог включает более тысячи конфигураций запуска для почти 400 моделей, при этом для каждой комбинации модели и чипа упаковываются образ, движок инференса, версия весов и флаги запуска.

Встроенный помощник на базе ИИ помогает диагностировать сбои, а планировщик объясняет каждое принятое решение о размещении. Согласно собственным тестам команды, один сервер GPUWorks смог управлять 1003 серверами GPU и за четыре минуты поднять более 500 реплик инференса. При этом выход достигал 69 000 токенов в секунду, используя всего девять ядер ЦП и 1,6 ГБ памяти. Время пробуждения развернутого DeepSeek-V4.1-Flash составило всего 3,6 секунды.

Функция пробуждения позволяет нескольким крупным моделям попеременно использовать одни и те же GPU. Режим сна первого уровня сохраняет веса модели в памяти хоста, что исключает необходимость перезапуска движка или повторной загрузки весов из хранилища. В ходе испытания на восьми картах NVIDIA H20, где три большие модели распределены по всем восьми картам, холодный запуск из хранилища NFS занимал от 16 до 17,5 минут, тогда как восстановление сервиса после пробуждения из памяти заняло около четырех секунд, что представляет собой улучшение примерно в 200 раз. Администраторы имеют возможность настраивать политики приоритета, освобождения при простое или запланированной ротации.

Для более объемных рабочих нагрузок платформа поддерживает многоузловой параллелизм, множественные реплики и разделение предобработки и декодирования, позволяя конфигурировать сетевое взаимодействие RDMA или каналы Ascend HCCS. Также предусмотрены встроенные нагрузочные тесты для проверки пропускной способности и задержки перед масштабированием. Система отслеживает использование токенов и попадания в кэш по каждому ключу API, модели и развертыванию, а также часы карты на миллион выходных токенов и неиспользуемые GPU. Во время обслуживания узла платформа добавляет реплики до того, как начнет выводить из эксплуатации старые, и автоматически восстанавливает сервисы на другом подходящем узле, если машина выходит из строя.

Похожие сюжеты

Кластер Wuxi от Moore Threads с 2112 GPU достиг 92,9% загрузки после начала коммерческой эксплуатации
Подробнее
pandaily.com

Кластер Wuxi от Moore Threads с 2112 GPU достиг 92,9% загрузки после начала коммерческой эксплуатации

Коммерческая эксплуатация отечественного вычислительного кластера, построенного на графических процессорах MTT S5000 от Moore Threads, началась в Хуишане, Уси. Согласно отчету Zhidx от 2 ноября, данный центр начал свою первую фазу в июне, перешел в испытательный режим в июле и приступил к коммерческому обслуживанию в октябре.

Текущая фаза кластера включает 264 сервера, оснащенных 2112 картами S5000. Данные, предоставленные Zhidx, показывают, что загрузка кластера достигла 92,9%. В период испытаний было привлечено 55 клиентов и внедрено 33 модели. Более 62% рабочих нагрузок приходится на обучение моделей, при этом смешанное обучение и вывод составляют 14,7%, а чистый вывод — 23,1%.

Кластер структурирован из четырех модулей, каждый из которых содержит около 500 карт, и был предоставлен в готовом виде. Он достиг полной нагрузки в течение трех месяцев после запуска. Система поддерживает более 30 семейств моделей, включая Qwen, GLM, DeepSeek, Kimi и MiniMax.

При тестировании на выводе с использованием пула S5000 и модели DeepSeek V4 Flash при 7 тыс. входных и 2 тыс. выходных токенах, была зафиксирована пропускная способность одной машины на уровне 994,97 токенов в секунду и эффективный вывод в 1241 токен в секунду. Система справлялась с 48 одновременными запросами в рамках целевого уровня обслуживания, который в отчете установлен на уровне 92% конфигурации H800 при аналогичном тесте. Следует отметить, что эти показатели были представлены операторами кластера и не прошли независимую проверку.

Кластер также предлагает опцию смешанного развертывания, которая объединяет карты S5000 с другими ускорителями посредством дисагрегации предварительной загрузки и декодирования. В одной из конфигураций, упомянутых в отчете, три карты S5000 в сочетании с двумя картами H20 обеспечили пропускную способность, сравнимую с девятью картами H20, что примерно в 1,87 раза превышает базовый уровень, одновременно сокращая время до первого токена примерно вдвое.

Производитель автономных транспортных средств Neolix планирует проводить обучение для своих моделей самоуправления на этой площадке, причем спрос приближается к уровню в 10 000 карт, что примерно в пять раз превышает текущее количество карт в кластере. Ранее Moore Threads заявляла, что ее кластер на базе S5000 на 10 000 карт обеспечивает 10 EFLOPS вычислительной мощности с 90% эффективным временем обучения и 95% эффективностью линейного масштабирования. Расширение в Хуишане будет осуществляться поэтапно, и в отчете упоминается, что Moore Threads также сотрудничает с JD Cloud над созданием кластера на 100 000 карт.

Площадка в Уси является частью растущего числа региональных вычислительных центров в Китае, построенных на отечественных ускорителях, поскольку операторы переходят от демонстрационных установок к кластерам, обслуживающим разработчиков моделей и робототехнические компании в крупном масштабе.

Moore Threads открыла Megatron-MUSA-Titan для обучения моделей MoE с триллионом параметров на собственных GPU
Подробнее
pandaily.com

Moore Threads открыла Megatron-MUSA-Titan для обучения моделей MoE с триллионом параметров на собственных GPU

Компания Moore Threads сделала проект Megatron-MUSA-Titan общедоступным, представив инфраструктуру для обучения больших моделей, которую она разработала для использования на собственных графических процессорах. Этот проект предназначен для работы с моделями типа 'смесь экспертов' (mixture-of-experts) с триллионом параметров на кластерах, состоящих из более чем 10 000 GPU от Moore Threads, и охватывает как предварительное обучение, так и обучение с подкреплением.

Код проекта доступен на GitHub. Компания утверждает, что данная система непрерывно использовалась для предварительного обучения MoE с триллионом параметров на кластерах мощностью 10 000 GPU, где длительные сессии обучения обеспечивали высокую утилизацию FLOPs модели и стабильность процесса.

В репозитории представлен пример конфигурации для модели MoE в стиле Kimi-K2 с 1 триллионом параметров. Центральным принципом проектирования стало сохранение близости к существующим решениям. Megatron-MUSA-Titan построен на основе фреймворка Megatron-LM от NVIDIA. Благодаря интеграции PyTorch через torch_musa и совместимости MUSA C с CUDA C, разработчики, имеющие среду MUSA, могут клонировать официальные репозитории Megatron-LM, slime и miles и запускать обучение на GPU Moore Threads без необходимости модификации исходного кода.

Проект указывает, что общие алгоритмы и исправления ошибок следует направлять в вышестоящие проекты, тогда как Moore Threads фокусируется на двух типах изменений: крупномасштабных оптимизациях, адаптированных под оборудование и кластеры Moore Threads, а также на обходных решениях для специфических проблем MUSA.

Функции предварительного обучения включают блочное обучение в формате FP8, которое опирается на MT-TransformerEngine от Moore Threads. Диспетчеризация и объединение токенов MoE ускоряются с помощью DeepEP, работающего поверх Async Copy Engine компании, который также позволяет коммуникации экспертов параллельно с вычислениями. Среди других опций — выгрузка активаций с использованием виртуального параллелизма конвейера и планирование одного прямого прохода и одного обратного прохода, а также параллельная коммуникация конвейера, совмещенная с вычислениями, благодаря Mooncake RDMA.

Инструмент анализа распределенной трассировки считывает трассировки PyTorch с каждого GPU для обнаружения узких мест, таких как пузырьки конвейера и узлы с низкой производительностью. Проект заявляет, что он способен анализировать запуск MoE с 1 триллионом параметров на 10 000 GPU всего за несколько часов.

Для обучения с подкреплением стек поддерживает фреймворки slime и miles; Megatron занимается обучением, а MUSA-сборка SGLang генерирует прогоны, что позволяет одной базовой системе обслуживать как предварительное обучение, так и RL. Оптимизация для автономного инференса не входит в сферу действия данного проекта.

Для разработчиков, рассматривающих отечественные ускорители, практический вопрос заключается в том, какая часть существующего кода обучения останется работоспособной. Ответ Moore Threads состоит в том, что код экосистемы Megatron не требует изменений.

Iluvatar CoreX продемонстрировал работу GPU Tiangai 300, заявив о производительности, превышающей H200 на 1.05x
Подробнее
pandaily.com

Iluvatar CoreX продемонстрировал работу GPU Tiangai 300, заявив о производительности, превышающей H200 на 1.05x

Компания Iluvatar CoreX во время своего медиа-дня, состоявшегося 28 октября в Шанхае, впервые представила общецелевой графический процессор Tiangai 300 в работающем состоянии на реальном оборудовании. До этого момента публичные материалы компании о чипе фокусировались исключительно на архитектуре и дорожной карте, а не на функционирующих системах.

Основным заявлением является сравнение производительности. Iluvatar CoreX утверждает, что Tiangai 300 стал первым отечественным общецелевым GPU, чья измеренная производительность достигает уровня NVIDIA H200. Кроме того, стороннее тестирование, после конвертации данных, показало, что общая пропускная способность одной карты составляет 1.05 раза больше, чем у H200. Важно отметить, что компания не раскрыла методику тестирования, использованные модели или условия рабочей нагрузки, поэтому данный результат пока не может быть проверен независимо.

Этот чип предназначен для внедрения в суперузел IXL144, который ранее был представлен компанией на Китайской международной промышленной ярмарке. Один такой стеллаж IXL144 объединяет 144 GPU, 18 CPU и около 10.1 ТБ памяти GPU, что Iluvatar CoreX называет самым плотным суперузлом GPU в отрасли. По собственным оценкам, такая конфигурация снижает стоимость на миллион эффективных токенов на 40% по сравнению с основными международными решениями.

На открытом дне также была представлена информация о гетерогенном развертывании. Iluvatar CoreX сообщила, что реализовала первую отечественную схему дезагрегации AFD между GPU и XPU, что позволило сократить задержку инференса на 60%. Дезагрегация AFD обычно подразумевает разделение этапов вычислений модели, таких как слои внимания и прямого распространения, между различными типами процессоров, чтобы каждый выполнял ту работу, в которой он наиболее эффективен.

Что касается периферийных устройств, компания заявила, что ее чип Tongyang TY1200 превосходит NVIDIA Thor T5000 в проведенных тестах, опять же без публикации подробностей. TY1200, который ранее был анонсирован с 300 TOPS плотных вычислений для ПК с ИИ и воплощенного интеллекта, также назван первым отечественным периферийным продуктом, способным выполнять симуляцию физики с ускорением GPU на основе MuJoCo-Warp — функция, критически важная для обучения роботов в симуляции.

В целом, эти демонстрации выводят линейку продуктов следующего поколения от Iluvatar CoreX из области бумажных спецификаций к работающим системам. Следующим моментом, за которым стоит следить, станут независимые бенчмарки с раскрытыми рабочими нагрузками.

Популярное