Кластер Wuxi от Moore Threads с 2112 GPU достиг 92,9% загрузки после начала коммерческой эксплуатации
Подробнее
Pandaily
pandaily.com

Кластер Wuxi от Moore Threads с 2112 GPU достиг 92,9% загрузки после начала коммерческой эксплуатации

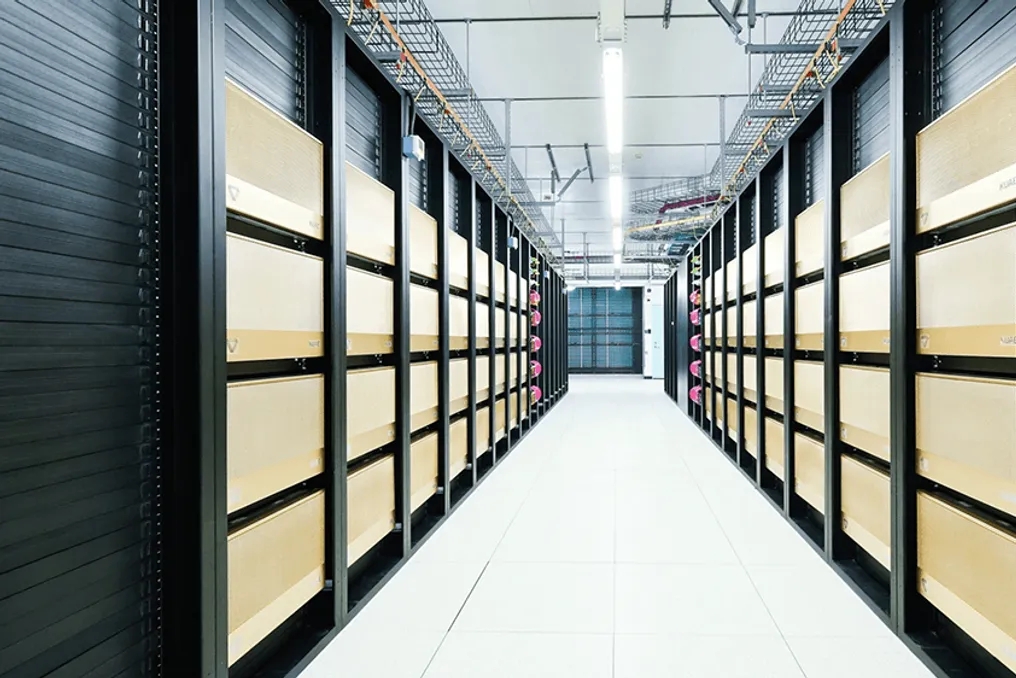
Коммерческая эксплуатация отечественного вычислительного кластера, построенного на графических процессорах MTT S5000 от Moore Threads, началась в Хуишане, Уси. Согласно отчету Zhidx от 2 ноября, данный центр начал свою первую фазу в июне, перешел в испытательный режим в июле и приступил к коммерческому обслуживанию в октябре.

Текущая фаза кластера включает 264 сервера, оснащенных 2112 картами S5000. Данные, предоставленные Zhidx, показывают, что загрузка кластера достигла 92,9%. В период испытаний было привлечено 55 клиентов и внедрено 33 модели. Более 62% рабочих нагрузок приходится на обучение моделей, при этом смешанное обучение и вывод составляют 14,7%, а чистый вывод — 23,1%.

Кластер структурирован из четырех модулей, каждый из которых содержит около 500 карт, и был предоставлен в готовом виде. Он достиг полной нагрузки в течение трех месяцев после запуска. Система поддерживает более 30 семейств моделей, включая Qwen, GLM, DeepSeek, Kimi и MiniMax.

При тестировании на выводе с использованием пула S5000 и модели DeepSeek V4 Flash при 7 тыс. входных и 2 тыс. выходных токенах, была зафиксирована пропускная способность одной машины на уровне 994,97 токенов в секунду и эффективный вывод в 1241 токен в секунду. Система справлялась с 48 одновременными запросами в рамках целевого уровня обслуживания, который в отчете установлен на уровне 92% конфигурации H800 при аналогичном тесте. Следует отметить, что эти показатели были представлены операторами кластера и не прошли независимую проверку.

Кластер также предлагает опцию смешанного развертывания, которая объединяет карты S5000 с другими ускорителями посредством дисагрегации предварительной загрузки и декодирования. В одной из конфигураций, упомянутых в отчете, три карты S5000 в сочетании с двумя картами H20 обеспечили пропускную способность, сравнимую с девятью картами H20, что примерно в 1,87 раза превышает базовый уровень, одновременно сокращая время до первого токена примерно вдвое.

Производитель автономных транспортных средств Neolix планирует проводить обучение для своих моделей самоуправления на этой площадке, причем спрос приближается к уровню в 10 000 карт, что примерно в пять раз превышает текущее количество карт в кластере. Ранее Moore Threads заявляла, что ее кластер на базе S5000 на 10 000 карт обеспечивает 10 EFLOPS вычислительной мощности с 90% эффективным временем обучения и 95% эффективностью линейного масштабирования. Расширение в Хуишане будет осуществляться поэтапно, и в отчете упоминается, что Moore Threads также сотрудничает с JD Cloud над созданием кластера на 100 000 карт.

Площадка в Уси является частью растущего числа региональных вычислительных центров в Китае, построенных на отечественных ускорителях, поскольку операторы переходят от демонстрационных установок к кластерам, обслуживающим разработчиков моделей и робототехнические компании в крупном масштабе.

Похожие сюжеты

Первый кластер SuperPoD на Ascend 950DT с 1024 NPU запущен в Ухане всего за месяц
Подробнее
pandaily.com

Первый кластер SuperPoD на Ascend 950DT с 1024 NPU запущен в Ухане всего за месяц

В городе Ухань был активирован первый вычислительный кластер, построенный на SuperPoD с 1024 картами Ascend 950DT от Huawei. Запуск состоялся 28 октября на конференции по искусственному интеллекту Huawei для провинции Хубэй, которая проходила в рамках китайского роуд-шоу Huawei 2026 года.

Инвестиции в данный кластер предоставила Провинциальная группа по инвестициям в науку и технологии Хубэя, являющаяся государственным инвестором провинции. Согласно данным этой группы, реализация проекта заняла всего один месяц с момента начала работ до ввода в эксплуатацию, что является относительно коротким сроком для системы такого масштаба.

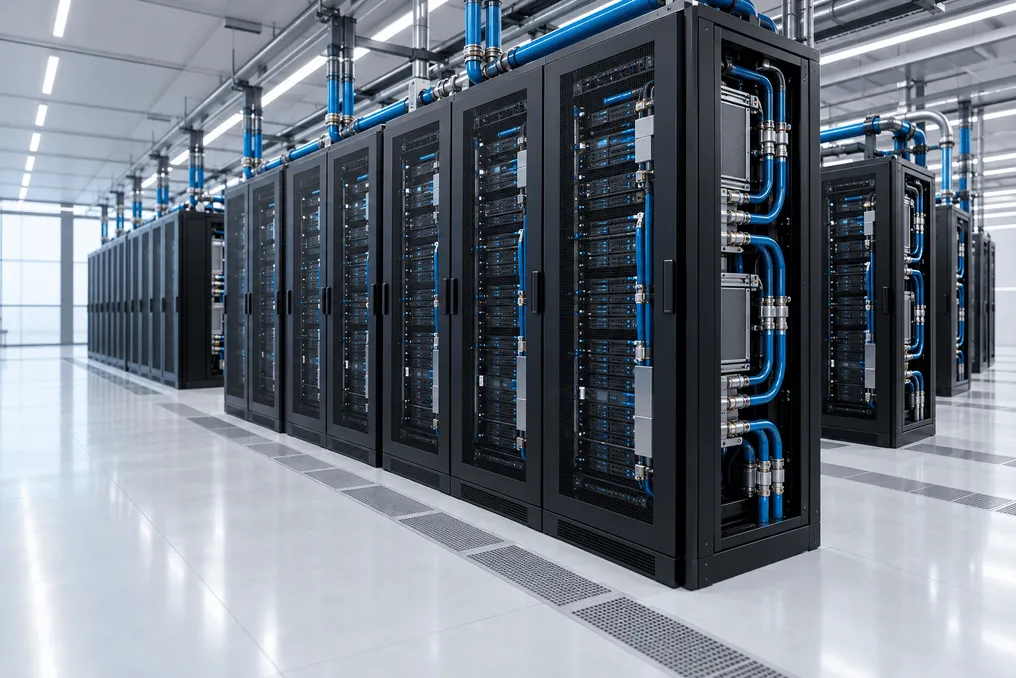
Развертывание представляет собой единый жидкостно-охлаждаемый SuperPoD. Один узел оснащен 1024 ускорительными картами Ascend NPU. Как вычислительные, так и соединительные шкафы полностью оборудованы системами жидкостного охлаждения. Система способна обеспечивать производительность 1 EFLOPS в формате FP8 и имеет 256 ТБ глобально унифицированной памяти. Пропускная способность между картами достигает уровня терабайт в секунду, а задержка сквозной связи составляет микросекунды.

Архитектура дизайна основана на UnifiedBus, внутренней архитектуре соединения Huawei для SuperPoD. Эта технология позволяет каждой карте в кластере напрямую обращаться к другим картам, что дает 1024 NPU функционировать скорее как один крупный ускоритель, нежели как множество отдельных серверов, соединенных через стандартную сеть. Huawei позиционирует эту установку для обучения моделей с триллионами параметров и для выполнения инференса AI-агентов.

Основным преимуществом подхода SuperPoD является возможность прямого доступа. При обучении больших моделей значительная часть времени тратится на перемещение данных между чипами. Поддержание унифицированной памяти по всему поду и внутри него соединительной архитектуры снижает объем трафика, который должен проходить через более медленные каналы.

Кластер предназначен для удовлетворения местных потребностей. Он призван предоставить разработчикам моделей и компаниям в Хубэе доступный источник вычислительных мощностей для тренировки крупных моделей, а также для создания, настройки и эксплуатации отраслевых AI-агентов. Местные источники отмечают, что это восполняет пробел в поставках высокопроизводительных вычислений в провинции.

Запуск в Ухане также знаменует собой раннее практическое внедрение поколения Ascend 950. Ранее в этом году Huawei демонстрировала физический SuperPoD на базе Ascend 950 и тогда сообщала, что уже было коммерчески развернуто более 750 комплектов предыдущего поколения Ascend 384 SuperPoD. Кластер 950DT в Ухане демонстрирует переход новой конструкции SuperPoD из демонстрационного оборудования в региональные центры ИИ-вычислений.

Huawei не раскрыла данные о энергопотреблении кластера или подробные показатели использования; приведенные выше числовые значения были озвучены на мероприятии по запуску.

Moore Threads открыла Megatron-MUSA-Titan для обучения моделей MoE с триллионом параметров на собственных GPU
Подробнее
pandaily.com

Moore Threads открыла Megatron-MUSA-Titan для обучения моделей MoE с триллионом параметров на собственных GPU

Компания Moore Threads сделала проект Megatron-MUSA-Titan общедоступным, представив инфраструктуру для обучения больших моделей, которую она разработала для использования на собственных графических процессорах. Этот проект предназначен для работы с моделями типа 'смесь экспертов' (mixture-of-experts) с триллионом параметров на кластерах, состоящих из более чем 10 000 GPU от Moore Threads, и охватывает как предварительное обучение, так и обучение с подкреплением.

Код проекта доступен на GitHub. Компания утверждает, что данная система непрерывно использовалась для предварительного обучения MoE с триллионом параметров на кластерах мощностью 10 000 GPU, где длительные сессии обучения обеспечивали высокую утилизацию FLOPs модели и стабильность процесса.

В репозитории представлен пример конфигурации для модели MoE в стиле Kimi-K2 с 1 триллионом параметров. Центральным принципом проектирования стало сохранение близости к существующим решениям. Megatron-MUSA-Titan построен на основе фреймворка Megatron-LM от NVIDIA. Благодаря интеграции PyTorch через torch_musa и совместимости MUSA C с CUDA C, разработчики, имеющие среду MUSA, могут клонировать официальные репозитории Megatron-LM, slime и miles и запускать обучение на GPU Moore Threads без необходимости модификации исходного кода.

Проект указывает, что общие алгоритмы и исправления ошибок следует направлять в вышестоящие проекты, тогда как Moore Threads фокусируется на двух типах изменений: крупномасштабных оптимизациях, адаптированных под оборудование и кластеры Moore Threads, а также на обходных решениях для специфических проблем MUSA.

Функции предварительного обучения включают блочное обучение в формате FP8, которое опирается на MT-TransformerEngine от Moore Threads. Диспетчеризация и объединение токенов MoE ускоряются с помощью DeepEP, работающего поверх Async Copy Engine компании, который также позволяет коммуникации экспертов параллельно с вычислениями. Среди других опций — выгрузка активаций с использованием виртуального параллелизма конвейера и планирование одного прямого прохода и одного обратного прохода, а также параллельная коммуникация конвейера, совмещенная с вычислениями, благодаря Mooncake RDMA.

Инструмент анализа распределенной трассировки считывает трассировки PyTorch с каждого GPU для обнаружения узких мест, таких как пузырьки конвейера и узлы с низкой производительностью. Проект заявляет, что он способен анализировать запуск MoE с 1 триллионом параметров на 10 000 GPU всего за несколько часов.

Для обучения с подкреплением стек поддерживает фреймворки slime и miles; Megatron занимается обучением, а MUSA-сборка SGLang генерирует прогоны, что позволяет одной базовой системе обслуживать как предварительное обучение, так и RL. Оптимизация для автономного инференса не входит в сферу действия данного проекта.

Для разработчиков, рассматривающих отечественные ускорители, практический вопрос заключается в том, какая часть существующего кода обучения останется работоспособной. Ответ Moore Threads состоит в том, что код экосистемы Megatron не требует изменений.

SpacemiT представила серверный процессор V100 на архитектуре RISC-V с поддержкой Kunlunxin M100 и Linux
Подробнее
pandaily.com

SpacemiT представила серверный процессор V100 на архитектуре RISC-V с поддержкой Kunlunxin M100 и Linux

Компания SpacemiT не выпускала свой серверный процессор V100 самостоятельно. На Саммите RISC-V в Китае, который состоялся в Шэньчжэне 19 октября, компания совместно с командой открытого процессора XiangShan представила три готовых сервера, построенных вокруг этого чипа. Эти системы сопровождаются валидацией ускорителей и поддержкой операционных систем, что направлено на внедрение машин на базе RISC-V в центры обработки данных.

Представленные три устройства включают вычислительный сервер C2201, ИИ-сервер G5201 и сервер хранения данных S5236. Они предназначены для решения задач общего назначения, ускорения искусственного интеллекта и крупномасштабного хранения данных. Сервер G5201 оснащен восемью картами ускорителей полного размера и полной длины с двойной шириной, а также поддерживает высокоскоростную кластерную сеть RDMA. SpacemiT подтверждает, что чип был протестирован с использованием отечественных ускорителей, включая M100 от Kunlunxin.

Кроме того, компания предлагает партнерам материнские платы для серверов, прошивку, управление BMC и аппаратные референсные конструкции, позволяющие создавать собственные брендированные машины без необходимости разрабатывать плату с нуля.

Значительное внимание уделено программному обеспечению. SpacemiT заявляет, что V100 реализует пять спецификаций серверных решений RISC-V в кремнии, прошивке и операционной системе: RVA23, Server SoC, Server Platform, Boot and Runtime Services (BRS) и модель безопасности. Компания сообщает об успешном прохождении всех тестов BRS. Благодаря этому, такие операционные системы, как openEuler, openRuyi, openKylin, Debian, Ubuntu, Fedora, Red Hat и Rocky Linux, могут быть установлены, загружены и запущены напрямую.

Для облачных сред с множеством арендаторов V100 поддерживает расширение RISC-V H, AIA и IOMMU, что обеспечивает аппаратно-уровневую виртуализацию ЦПУ, памяти, прерываний и ввода-вывода. SpacemiT отмечает, что эти расширения виртуализации уже имеют нативную поддержку в Linux, поэтому не требуется создание пользовательского ядра. Чип также включает аппаратный корень доверия, нативную среду доверенного исполнения RISC-V и поддержку RERI RAS. Компания продвигает концепцию легковесных микро-VM на V100 как способ изолировать рабочие нагрузки ИИ в облаке с минимальными накладными расходами, близкими к контейнерным.

Сам чип использует гибридную конструкцию из 46 ядер, включающую шесть ядер XiangShan Kunminghu V2R2 и 40 ядер SpacemiT X100, работающих с частотой до 2.4 ГГц. Два таких чипа могут быть связаны когерентно для достижения общей производительности до 92 ядер. Каждый чип поддерживает восемь каналов DDR5 и 52 линии PCIe 5.0. XiangShan курируется Институтом вычислительных технологий Китайской академии наук.

SpacemiT позиционирует V100 как первый универсальный чип, полностью соответствующий спецификациям серверных решений RISC-V. Основатель и генеральный директор Чэнь Чжицзянь заявил, что этот чип знаменует собой переход компании от разработки устройств к облачным технологиям. Следует отметить, что все заявленные характеристики и соответствия исходят от SpacemiT.

Популярное