SenseTime выпустила модель искусственного интеллекта с 9 миллиардами параметров, использующую повторное использование слоев для углубленной обработки
Подробнее
TechNode
technode.com

SenseTime выпустила модель искусственного интеллекта с 9 миллиардами параметров, использующую повторное использование слоев для углубленной обработки

Компания SenseTime представила SenseNova Loop-9B-Preview, мультимодель, доступную в открытом доступе. Эта модель использует метод повторного вычисления для увеличения глубины обработки без необходимости дублировать соответствующие веса модели. Анонс этого выпуска состоялся 30 октября.

Модель способна принимать на вход как текстовые, так и графические данные, генерируя текст для выполнения задач, связанных с пониманием документов, написанием кода и использованием внешних инструментов.

Она функционирует путем двойного прогона общего блока из 24 декодерных слоев, что позволяет создать более глубокий вычислительный путь, исходя из базовой модели, имеющей около девяти миллиардов параметров.

Документальная настройка обучения поддерживает последовательности длиной до 262 144 токенов и объединяет примеры, включающие текст, изображения, код и использование инструментов. SenseTime опубликовала веса модели, инструкции для инференса и руководство по обучению, распространяя проект под лицензией Apache 2.0.

Похожие сюжеты

Компания MemTensor выпустила открытую модель MemT 1.0 с памятью для сохранения длинных историй
Подробнее
pandaily.com

Компания MemTensor выпустила открытую модель MemT 1.0 с памятью для сохранения длинных историй

Китайская компания MemTensor представила и сделала общедоступной серию моделей, которую она называет память-ориентированными фундаментальными моделями, получившую название MemT 1.0. Эта серия включает две модели: MemT-1.0-Flash, обладающую общим количеством параметров в 288 миллиардов, из которых активно используется 17 миллиардов, и MemT-1.0-Nano, имеющую 36 миллиардов общих параметров и 3 миллиарда активных.

Веса этих моделей доступны на платформе Hugging Face, а соответствующий код размещен на GitHub вместе с техническим отчетом.

Модели разработаны для решения распространенной проблемы, связанной с длительными диалогами. Большинство существующих систем хранят всю историю в окне контекста, что приводит к замедлению и увеличению стоимости инференса с каждым новым ходом. Вместо этого MemT интегрирует обучаемый модуль памяти внутрь самой модели.

После каждого взаимодействия модель записывает новую информацию в фиксированное состояние памяти и извлекает ее при необходимости, вместо того чтобы каждый раз перечитывать весь предыдущий سجل.

MemTensor сообщает, что обучение моделей проходило в два этапа на основе 34 миллиардов токенов: сначала модель училась записывать информацию в память, а затем она обучалась отвечать на вопросы, используя эту сохраненную информацию.

Результаты производительности и сравнение

Все представленные показатели производительности основаны на собственной оценке компании. MemTensor утверждает, что сквозной инференс работает примерно в 1,86 раза быстрее, чем подход с полным контекстом при истории в 128 тысяч токенов, и около 3,99 раза быстрее при 256 тысячах токенов.

Время ответа первого токена оценивается примерно в 104–112 миллисекунд для модели с памятью, по сравнению с приблизительно 445 миллисекундами для полного контекста при 256K. Кроме того, компания отмечает, что объем состояния памяти на сессию при истории в 256K составляет около 40 МБ, что значительно меньше, чем 5,06 ГБ, требуемых для кэша полного контекста, что представляет собой сокращение примерно в 130 раз.

На 11 бенчмарках по памяти MemTensor заявляет о средних показателях 50,6 для Flash и 47,0 для Nano. Эти результаты ставят модели на первое и второе место среди сравниваемых параметрических методов памяти и примерно соответствуют результатам подходов с расширением с помощью поиска (retrieval-augmented approaches) в среднем, даже без извлечения истории во время запроса.

Компания также подчеркивает, что добавление памяти не ухудшило общие возможности модели Flash в условиях тестов с большим количеством отвлекающих факторов.

Разработчикам следует обратить внимание на условия лицензирования: код репозитория опубликован под некоммерческой лицензией PolyForm, тогда как веса моделей имеют лицензии Apache и MIT соответственно.

Команда планирует дальнейшее развитие в направлении улучшения долгосрочной памяти, увеличения емкости памяти и снижения затрат на обновление памяти, с долгосрочной целью создания агентов, которые продолжают учиться на основе своего взаимодействия.

DeepSeek выпустил код DeepInfer для ускорения и оптимизации выполнения моделей ИИ
Подробнее
olhardigital.com.br

DeepSeek выпустил код DeepInfer для ускорения и оптимизации выполнения моделей ИИ

В прошлый вторник (20-го) DeepSeek сделал общедоступным код DeepInfer — программное обеспечение, предназначенное для работы с ее моделями искусственного интеллекта (ИИ). Этот инструмент был создан с целью повышения эффективности обработки и сокращения времени, необходимого для генерации ответов.

С выпуском кода разработчики и корпорации получили возможность изучить работу программы и адаптировать ее для различных проектов, при условии соблюдения технических требований и условий использования. По словам самой DeepSeek, эта мера направлена на снижение энергопотребления и вычислительных ресурсов, делая работу моделей ИИ более эффективной. Однако практические результаты будут зависеть от условий использования и доступной инфраструктуры.

В настоящее время DeepInfer совместим конкретно с моделью DeepSeek-V4.1-Flash. Хотя открытие кода позволяет другим разработчикам исследовать и использовать эту технологию, важно отметить, что не вся система исполнения компании была обнародована, поскольку некоторые компоненты инфраструктуры остаются закрытыми.

Во время участия в программе Olhar Digital News физик Роберто «Пена» Спинелли, эксперт по машинному обучению, прокомментировал это нововведение. Исследователь разъяснил различие между предоставлением модели ИИ и выпуском программного обеспечения, которое отвечает за ее выполнение. Чтобы объяснить эту разницу, он использовал аналогию с автомобилем.

Пена подробно объяснил, что простое предоставление модели не равносильно предоставлению всех инструментов, необходимых для ее эффективной эксплуатации. В то время как модель содержит параметры, управляющие созданием ответов, программное обеспечение для вывода объединяет механизмы, которые обеспечивают его функционирование. Открытие этого кода может помочь разработчикам, планирующим внедрить собственные решения.

Эксперт сравнил ситуацию, сказав: «Раньше они делились только чертежом двигателя, который является самим искусственным интеллектом. То, что они делают сейчас, — это предоставление работы целой машины. Все программное обеспечение и механизм того, как они выполняют искусственный интеллект, были выпущены для общественности».

Это сравнение помогает понять разницу между двумя элементами, но есть оговорка: предоставление DeepInfer не означает, что все элементы инфраструктуры DeepSeek доступны. Тем не менее, доступ к коду позволяет программистам и исследователям изучать методологии исполнения, используемые компанией, и оценивать, как применять их в других работах.

Эта инициатива также может способствовать коммерческой стратегии DeepSeek. Делясь частью своей технологии, компания открывает возможности для других разработчиков использовать ее, вносить улучшения и создавать совместимые приложения. Такое принятие может расширить охват ее технологии на высококонкурентном рынке, где множество компаний соревнуются в предложении более доступных и эффективных моделей.

Пена добавил: «DeepSeek хочет создать экосистему, чтобы больше людей и компаний начали использовать ее продукты». Он продолжил: «Показывая, как собрать полную структуру, она побуждает публику отказываться от более дорогих платных платформ. Это последовательный способ утвердиться в крайне конкурентном секторе».

Выпуск DeepInfer подчеркивает, что конкуренция в области ИИ ограничивается не только способностью моделей генерировать ответы, но и эффективностью, требуемой для их выполнения. Делясь частью своей технологии, DeepSeek увеличивает варианты использования программного обеспечения и укрепляет свои позиции в отрасли. Влияние этой меры будет зависеть, среди прочего, от достигнутой производительности в различных средах и принятия разработчиками и компаниями.
Компания VAST выпустила открытую модель EdenLive для рендеринга простых игровых кадров в детализированное видео
Подробнее
pandaily.com

Компания VAST выпустила открытую модель EdenLive для рендеринга простых игровых кадров в детализированное видео

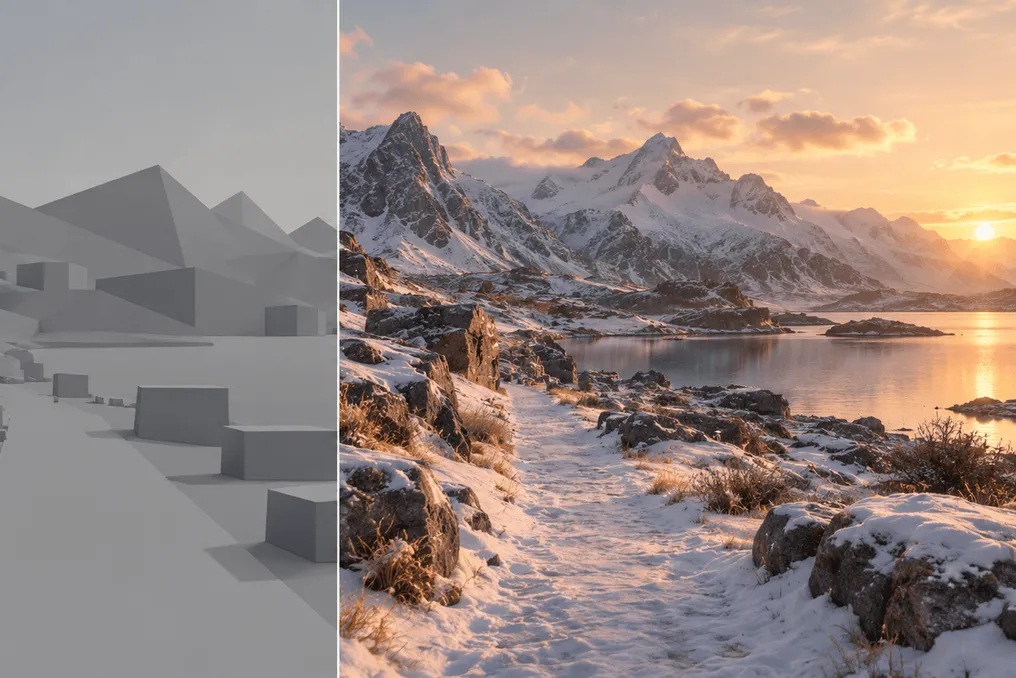
VAST, компания, специализирующаяся на генеративном ИИ в 3D и стоящая за платформой Tripo, сделала модель EdenLive общедоступной. Эта модель работает в режиме реального времени и способна брать упрощенные игровые кадры или существующее видео, непрерывно перерисовывая их в детальные изображения в выбранном стиле, который может варьироваться от фотореалистичного до аниме.

Выпуск включает веса моделей размером 5B и 14B, код для инференса в реальном времени, технический отчет и демонстрации сквозного использования. Важно отметить, что EdenLive самостоятельно не симулирует мир; вместо этого вышестоящая программа, например игровой движок или код, написанный агентом кодирования, отвечает за соблюдение правил, отслеживание состояния мира и вывод грубого эталонного видео.

После получения этого эталонного видео, EdenLive выполняет рендеринг, руководствуясь заданным первым кадром и текстовым запросом. VAST утверждает, что такое разделение позволяет сохранить игровую логику явной и пригодной для тестирования, а ограниченные возможности модели в реальном времени сосредоточить исключительно на внешнем виде.

Подход был впервые представлен в июне в рамках более масштабного исследования мира, известного как Проект Eden. Согласно заявлениям VAST, модель 5B способна работать с частотой выше 24 кадров в секунду при разрешении 720p на одной видеокарте Nvidia RTX 5090. В файле README на GitHub эта цифра указана примерно как 24.7 FPS при разрешении 1280 на 704 пикселя, используя ускорение от фреймворка инференса LightX2V.

Технический отчет сообщает о показателе 29.8 FPS при том же разрешении на одном H100, а также 26.8 FPS при разрешении 832 на 480 для модели 14B, работающей на восьми H100. VAST заявляет, что общая задержка от ввода пользователя до соответствующего кадра составляет сотни миллисекунд, и система может генерировать контент непрерывно в течение нескольких минут.

Обе модели основаны на видеомоделях Wan2.2-TI2V-5B и Wan2.1-I2V-14B. Код инференса и основные веса диффузии, VAE и декодера распространяются под лицензией Apache 2.0, однако не все компоненты имеют такую лицензию. Визуальный энкодер использует лицензию DINOv3, а модель изображения, применяемая в рабочем пространстве от запроса к игре, находится под Некоммерческой лицензией FLUX, что ограничивает использование этого рабочего пространства некоммерческими целями.

VAST также представила Game Prototype Turbo — навык, который преобразует текстовый запрос в грубую играбельную игру, которую затем может отрендерить EdenLive. Демонстрации VAST включают платформер, где персонаж замораживает лаву для создания опорных точек, двухпользовательскую файтинг-игру, где отслеживаются полоски здоровья и таймер раунда вышестоящей системой, а также рендеринг видео, превращающий человека, снятого на синий фон, в мультяшного персонажа. Кроме того, модель демонстрирует замену человеческих рук на роботизированные в футаже от первого лица для создания дополнительных обучающих данных для воплощенного ИИ.

VAST отмечает, что в настоящее время EdenLive лучше всего подходит для взаимодействия низкой частоты, такого как осмотр сцен и головоломки с толканием ящиков. Быстрый, интенсивный геймплей, поддержание согласованности нескольких персонажей, тонкий контроль над мелкими объектами и визуальная стабильность в длительных сессиях все еще требуют доработки.

Популярное