Qwen AI Glasses получили обновление OTA с функцией перевода звонков и медиаконтента
Подробнее
Pandaily
pandaily.com

Qwen AI Glasses получили обновление OTA с функцией перевода звонков и медиаконтента

Компания Alibaba выпустила обновление по воздуху (OTA) для своих Qwen AI Glasses, которое стало доступно 1 ноября. Согласно сообщению IT Home, это обновление добавило функции перевода во время звонков и перевода медиаконтента, а также улучшило обработку шумов. Ранее, 30 октября, аккаунт Qwen AI Glasses объявил о предстоящем обновлении в Weibo.

Функция перевода звонков обеспечивает перевод между различными языками в режиме реального времени во время телефонных разговоров и онлайн-совещаний, что предназначено для общения с иностранными собеседниками. Что касается перевода медиа, он охватывает такие материалы, как зарубежные подкасты, онлайн-курсы на иностранных языках и иностранные фильмы.

При работе с медиаglasses переводятся аудиодорожки в реальном времени, а полученный перевод отображается синхронно в приложении Qwen AI на телефоне пользователя; таким образом, очки отвечают за прослушивание, а телефон выполняет функцию экрана.

Третье изменение касается повышения устойчивости к шуму. Обновление улучшает распознавание речи в шумных условиях, что, по утверждению компании, делает одновременный перевод более точным и своевременным. Четкий прием звука является критически важным для большинства функций перевода, особенно в потоковых сценариях, таких как звонки, где говорящие не делают пауз, ожидая обработки системой.

В объявлении не было указано, какие именно модели получат данное обновление или какие языки поддерживают новые возможности.

Это обновление выходит на фоне быстрого роста линейки продуктов в текущем году. Модель Qwen AI Glasses G1 была представлена к продаже в марте, за ней последовала флагманская модель S1, которая превосходит G1 по взаимодействию, дисплею, времени автономной работы и аппаратному обеспечению. 13 октября Qwen представила серию N1, включающую модели N1 и N1 Pro. Обе версии оснащены 50-мегапиксельным сенсором, возможностью записи видео в 4K и сменными батареями в заушниках. Номинальное время работы от батареи составляет 9 часов для N1 и 8 часов для N1 Pro. Эти устройства включают встроенные приложения Qwen для заметок и перевода с использованием искусственного интеллекта.

Модель N1 Pro дополнительно получила отслеживание взгляда, работающее при освещенности от 0 до 100 000 люкс с точностью центра в пределах 1 градуса, верификацию радужной оболочки для платежей, разработанную совместно с GPASS от Ant Group и Qualcomm, а также мониторинг частоты сердечных сокращений, уровня кислорода в крови и температуры кожи. В то же время Qwen запустила клип-он наушники с ИИ, которые также обеспечивают перевод в реальном времени, ведение заметок на совещаниях и голосовые задачи.
Похожие сюжеты

Соучредитель Murf AI утверждает, что проблемы голосового ИИ Индии могут повлиять на мировую технологию
Подробнее
yourstory.com

Соучредитель Murf AI утверждает, что проблемы голосового ИИ Индии могут повлиять на мировую технологию

Соучредитель Murf AI считает, что сложности, связанные с голосовым искусственным интеллектом в Индии, способны сформировать глобальные технологические тенденции. То, что индийские пользователи считают обычным разговором, может стать самым сложным испытанием для голосового ИИ, и решение этой задачи откроет новые возможности по всему миру.

Голосовой ИИ способен отвечать на вопросы, подтверждать заказы или помогать бронировать места. Однако возникает вопрос: сможет ли он правильно произнести индийское имя, понять адрес, произнесенный на смеси хинди и английского, и ответить достаточно быстро, чтобы звучать естественно?

Для Снехи Рой, соучредителя и операционного директора Murf AI, такие сценарии не являются чем-то исключительным; они представляют собой базовый уровень для создания голосового ИИ, который будет работать в Индии, а в конечном итоге — во всем мире.

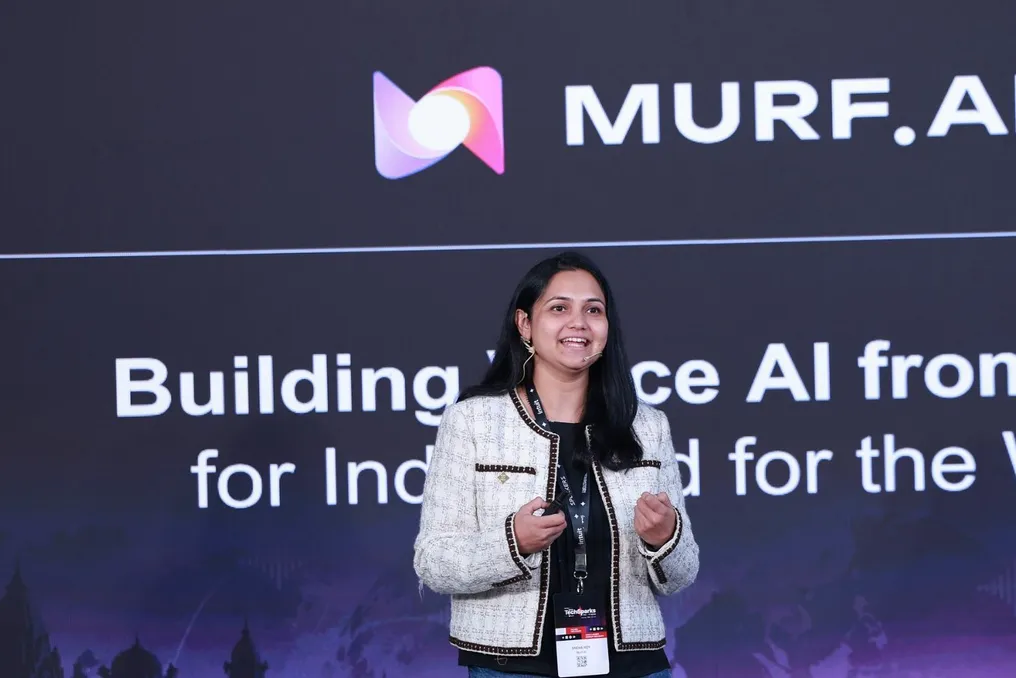
Во время мастер-класса на мероприятии TechSparks 2026 под названием «Создание голосового ИИ из Индии, для Индии и для мира» Рой объяснила, как языковая сложность Индии, ограничения инфраструктуры и экономические соображения влияют на развитие технологий речи.

Она привела примеры продуктов, которые сначала адаптировались к индийским пользователям, а затем нашли более широкое применение. Google Maps внедрила функцию работы в автономном режиме для районов с ограниченным доступом в интернет, а Netflix представил план, доступный только через мобильные устройства, который с тех пор был принят в 78 странах. Uber тестировал оплату наличными в Хайдарабаде, прежде чем расширить этот вариант на другие рынки.

Рой полагает, что голосовой ИИ может следовать подобному пути. Например, при звонке для проверки статуса доставки в Бенгалуру клиент может смешать английский с региональным языком, использовать местное произношение адреса и ожидать, что почтовый индекс будет озвучен по цифрам.

Модель, построенная на стандартизированном английском, может испытывать трудности с такими деталями. Рой подчеркнула: «Если клиенту приходится менять манеру речи, чтобы агент смог справиться, или постоянно повторять свой адрес или имя, значит, мы еще не закончили его разработку».

По ее мнению, задача состоит в создании систем, которые учитывают естественную манеру речи людей, а не требуют от клиентов приспосабливаться к технологии.

Естественная речь — лишь одна часть проблемы. Голосовые агенты также должны быстро реагировать и эффективно работать в больших масштабах, когда компании обрабатывают миллионы звонков ежемесячно. Рой сообщила, что полный конвейер голосового агента, включающий распознавание речи, языковую модель и генерацию речи, обычно имеет бюджет отклика в 500 до 800 миллисекунд. Она добавила, что Murf добилась снижения задержки своей модели преобразования текста в речь ниже 100 миллисекунд, включая сетевые задержки.

Для достижения этого компания разработала Falcon 2 — меньшую модель речи, предназначенную для работы на более широком спектре графических процессоров, вместо зависимости от специфического, высокопроизводительного оборудования. Рой отметила, что такой подход помог поддерживать низкую задержку в разных географических регионах, одновременно повышая экономическую эффективность.

Аналогичные инженерные решения могут быть полезны для рынков за пределами Индии, особенно там, где вычислительная инфраструктура ограничена или развертывание голосовых агентов в больших объемах остается дорогим.

Рой также акцентировала внимание на важности ответственного подхода к голосовым данным. Она упомянула, что Murf сотрудничает с более чем 400 актерами голоса по всему миру в рамках долгосрочных партнерств, основанных на роялти, и не клонирует голоса без согласия.

Для клиентов, предъявляющих строгие требования к конфиденциальности, компания предлагает API, которые могут обрабатывать данные без их сохранения, а также локальные развертывания для чувствительных приложений. Центральный тезис Рой заключается в том, что лингвистическое разнообразие и инфраструктурные ограничения Индии не следует рассматривать как второстепенные требования; они могут помочь определить, что именно должен делать голосовой ИИ до того, как он будет готов к широкому внедрению. Как она выразилась: «Индия — это столица спецификаций мира».

Ant Group открыла Ming-3.0-tts: небольшие модели синтеза речи с контролем голоса
Подробнее
pandaily.com

Ant Group открыла Ming-3.0-tts: небольшие модели синтеза речи с контролем голоса

Команда inclusionAI из Ant Group выпустила в открытый доступ Ming-3.0-tts — семейство моделей для генерации речи, целью которого является обеспечение детального контроля над голосом в моделях, достаточно компактных для локального развертывания. Код, руководство по задачам и таблицы оценки доступны на GitHub, а веса размещены на Hugging Face и ModelScope, при этом все материалы распространяются под лицензией MIT.

Релиз включает две модели. Ming-3.0-tts-0.5b представляет собой плотную модель с приблизительно полумиллиардом параметров. Ming-3.0-tts-tiny — это модель типа mixture-of-experts, построенная на архитектуре Ling V3 от Ant, которая имеет в общей сложности 7,9 миллиарда параметров, при этом 1,3 миллиарда активны на каждый токен. Обе модели используют единую генеративную структуру: языковая модель, управляемая токенами управления, специфичными для задачи и текстом, воздействует на патч-голову DiT и аудио-токенизатор.

Возможности этих моделей обширны. Пользователи могут клонировать референсный голос, создавать новый голос на основе текстового описания или выбирать из более чем 100 встроенных китайских голосов и пяти английских. Подача речи может регулироваться с помощью инструкций на естественном языке, а такие параметры, как эмоция, скорость, высота тона и громкость, могут настраиваться напрямую. Четырнадцать встроенных тегов позволяют вставлять смех, вздохи и другие вокальные звуки как на китайском, так и на английском языках. Модели поддерживают китайский, английский, немецкий, испанский, французский, корейский и японский языки, а также сичуаньский и кантонский.

Модель tiny дополнительно поддерживает диалоги с несколькими спикерами, генерируемые по сценарию и образцам голосов, что ориентировано на создание аудио в стиле длинных подкастов. Команда отмечает, что эти возможности функционируют как отдельные режимы задач, а не как произвольные комбинации.

Согласно репозиторию, Ming-3.0-tts заняла первое место среди моделей с открытыми весами в рейтинге Artificial Analysis Controlled Voice и первое место в общем зачете по Показателю устойчивости произношения, достигнув 93,2% корректно произнесенных выделенных сегментов по состоянию на октябрь 2026 года. Однако команда предупреждает, что эти рейтинги меняются по мере добавления новых моделей. На открытых бенчмарках модель демонстрирует передовые результаты среди перечисленных моделей с открытым исходным кодом по всем шести метрикам паралингвистики NVBench с одним тегом, по частоте ошибок на базовом наборе кантонского языка для модели 0.5b, а также по частоте ошибок слов на немецком и испанском языках для модели tiny.

В файле README также честно указаны слабые места. Сходство голосов в недавно добавленных языках в основном не попадает в тройку лидеров, контроль высоты тона является наименее точным атрибутом, частота ошибок корейской модели tiny значительно отстает от меньшей модели, а качество аудио для подкастов все еще уступает более раннему релизу Ming-omni-tts. В дорожной карте следующими шагами указаны ускоренный вывод vLLM-Omni и технический отчет. Проект призывает пользователей не клонировать голоса реальных людей без согласия и маркировать синтезированную речь там, где она может быть принята за реальную запись.

Популярное