Команда DeepSeek Harness открыла прототип супер-агента, способного самостоятельно находить и исправлять ошибки
Подробнее
Pandaily
pandaily.com

Команда DeepSeek Harness открыла прототип супер-агента, способного самостоятельно находить и исправлять ошибки

Команда DeepSeek Harness опубликовала описание своего проекта, который они назвали Супер-агент. Этот агент спроектирован как постоянно действующая система, которая одновременно продвигает несколько задач, самостоятельно ищет работу и восстанавливается после сбоев. Соответствующий исследовательский прототип был выпущен на GitHub под лицензией MIT, как сообщили китайские технологические СМИ.

Репозиторий dsh-superagent-prototype представляет собой пакет проактивного кодирующего агента, предназначенного для работы с одним репозиторием GitHub в рамках экосистемы DeepSeek Harness. Агент отслеживает активность в GitHub, а также опционально в Feishu. Когда авторизованный пользователь запрашивает выполнение задачи, агент создает рабочий элемент, обрабатывает его в своей сессии и каталоге, а затем отвечает в исходном диалоге, например, через создание запроса на слияние (pull request).

В сопроводительной документации подчеркивается, что данный код является исследовательским, а не официальным продуктом DeepSeek, и некоторые концепции, описанные в документе, еще не реализованы.

Архитектура системы

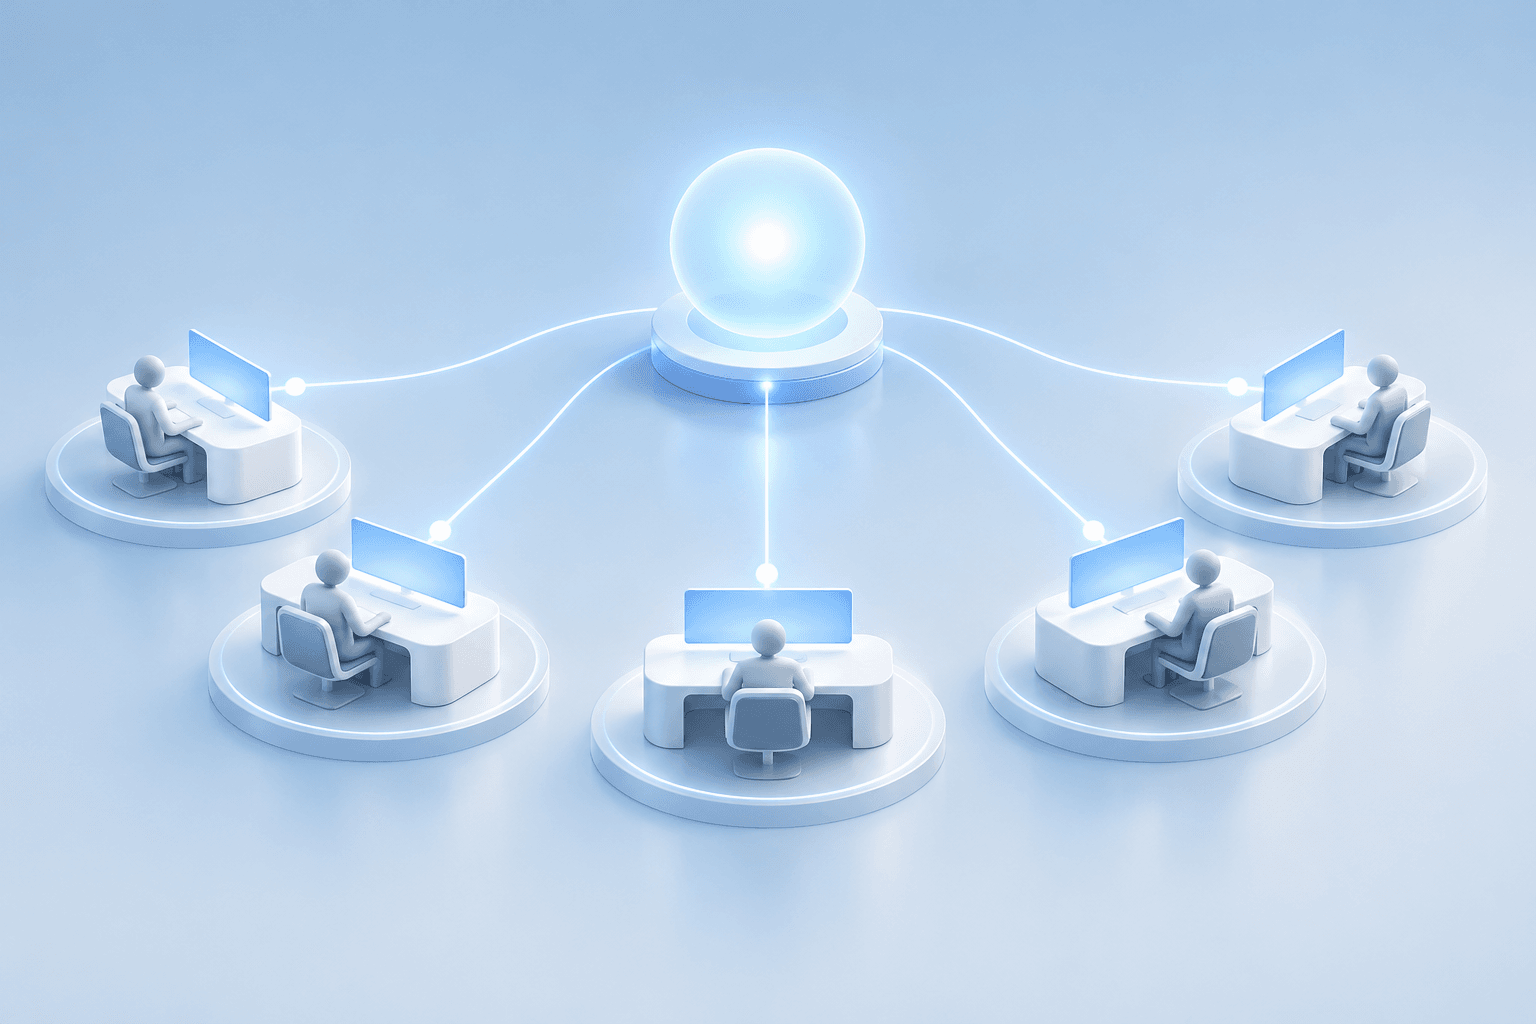
Основная концепция построена на двухслойной архитектуре. Сессия маршрутизатора (Router) принимает всю человеческую активность из разных каналов, но сама не выполняет работу и может даже не иметь инструмента Bash. Задачи делегируются изолированным сессиям рабочих агентов (Worker), которые выполняют работу параллельно, используя полный набор инструментов, и отправляют отчеты обратно Маршрутизатору, минуя общение с пользователями.

Каждый Рабочий агент подписывается на интересующие его ветки, такие как обсуждение в чате или запрос на слияние, что позволяет последующим событиям поступать непосредственно к нему, не проходя через Маршрутизатор. Система функционирует на основе событий: триггерами выступают сообщения в чатах, электронные письма, комментарии к обзорам и результаты непрерывной интеграции (CI), которые сначала фильтруются детерминированным кодом, а затем моделью.

Команда также разделила состояние агента и среды выполнения, чтобы агент мог оставаться активным в облаке, взаимодействуя с локальными машинами пользователя. Дополнительно используется внешняя сессия Наблюдателя (Watchdog), которая контролирует, добиваются ли Рабочие агенты реального прогресса. В внутренней группе пользователей команда установила правило: экземпляр должен молча воспроизводить заявленные ошибки и сообщать о них только после того, как найдет простое решение, иногда открывая запрос на слияние до того, как кто-либо отметит проблему.

В ходе предварительных испытаний на синтетических нагрузках, включавших около 300 сообщений и примерно 20 запросов на работу, Супер-агент завершил половину задач за 12,4 минуты, а 95% — за 15,7 минут. Эти показатели превзошли результаты, достигнутые одной сессией с инструментом под-агента, хотя и потребовали больше кешированных токенов. Без прямого направления последующих событий к Рабочим агентам решения Маршрутизатора увеличились примерно на 30%, а пакетная обработка при высокой нагрузке снизила время вывода одного решения Маршрутизатора с 6,4 секунд до 1,6 секунды. Команда назвала эти результаты предварительным ориентиром.

Среди нерешенных вопросов, перечисленных командой, — масштабирование Маршрутизатора, долгосрочная память, межагентное взаимодействие и риск внедрения подсказок (prompt-injection) в случае, если облачный агент получает доступ к учетным данным на локальных устройствах.
Похожие сюжеты

DeepSeek Harness v0.2.2-alpha.2 позволяет главному агенту передавать задачи локальным инструментам Codex и Claude Code
Подробнее
pandaily.com

DeepSeek Harness v0.2.2-alpha.2 позволяет главному агенту передавать задачи локальным инструментам Codex и Claude Code

DeepSeek выпустила предварительную версию DeepSeek Harness, своего программного обеспечения для агентов с открытым исходным кодом, версия v0.2.2-alpha.2, которая была размещена на GitHub 28 октября. Основное нововведение — экспериментальный плагин под названием subagent_oar, который дает главному агенту возможность поручить автономную задачу установке Codex CLI или Claude Code на той же машине.

Ранее Harness поддерживал Claude Code и Codex; обновление v0.1.0-rc.8 в августе позволяло пользователям устанавливать их в виде пакетов профилей внутри своей системы subagent. Однако новый инструмент функционирует иначе. Он предоставляет главному агенту единую точку входа для распределения работы: при вызове subagent_oar агент выбирает либо codex, либо claude, после чего отправляет описание задачи, полный запрос и необязательный рабочий каталог. Инструмент немедленно возвращает идентификатор задачи, а по завершении работы уведомление о выполнении приносит окончательный ответ или сообщение об ошибке обратно в основную сессию.

Внешние инструменты работают независимо. Codex CLI и Claude Code сохраняют свои собственные настройки, модели, инструменты и процесс входа, поэтому пользователи должны установить и авторизоваться в каждом из них, а также убедиться, что хост Harness может их найти. Параметры провайдера могут передавать модель, уровень рассуждений, аргументы запуска, переменные окружения и таймаут, в зависимости от поддержки каждого рантайма.

Документация устанавливает четкие ограничения: основная беседа не перенаправляется, поэтому в запросе необходимо явно указать, какие файлы важны и что должно быть возвращено. Задачи являются одноразовыми, без возможности последующих вопросов, возобновления сессии или потоковой передачи прогресса в реальном времени. Возвращается только финальный ответ или сбой, а не внутреннее рассуждение внешнего агента или история его инструментов. Официальные примеры позволяют использовать записываемое рабочее пространство и отключают запросы разрешений, а отмена задачи не отменяет изменения файлов, которые внешний агент уже внес.

Другие дополнения помогают пользователям отслеживать делегированную работу. Экспериментальная функция запроса изменений может отображать статус и различия связанного запроса на слияние для сессии, работающей в собственном рабочем дереве Git. Плагин статистики разработчика детализирует использование контекста, кэша, а также время, затраченное на модели и инструменты, по каждому шагу и ходу. Вывод небольших фоновых задач теперь поступает в уведомлении о завершении, а руководство по ожиданию subagent сокращает необходимость многократного опроса.

Выпуск также позволяет пользователям обновлять пакеты сторонних плагинов, с возможностью отката в случае сбоя горячего обновления, и добавляет интерфейсный текст на японский, испанский, французский, немецкий, русский и бразильский португальский языки. Более ранние материалы сообщества, включая тесты мультиагентных настроек от создателей Bilibili, были созданы самими пользователями и не являются продуктами DeepSeek.

DeepSeek привлекла 15 миллиардов долларов для усиления конкуренции против OpenAI и Anthropic
Подробнее
ventureburn.com

DeepSeek привлекла 15 миллиардов долларов для усиления конкуренции против OpenAI и Anthropic

Компания DeepSeek, которая в 2025 году привлекла внимание Уолл-стрит благодаря своему доступному и весьма способному ИИ-модели, завершила крупный раунд финансирования, чтобы бросить вызов растущему доминированию OpenAI и Anthropic.

В последнем раунде DeepSeek привлекла 15 миллиардов долларов, что эквивалентно примерно 100 миллиардам юаней. Финансирование поступило от гиганта аккумуляторной промышленности CATL, компании Tencent, стоящей за WeChat, а также от ряда других ведущих технологических фирм.

Первоначально компания, базирующаяся в Ханчжоу, планировала привлечь 50 миллиардов юаней. Однако спрос увеличил эту цель до 80 миллиардов, а затем до приблизительно 100 миллиардов.

В список новых участников вошли производитель автомобилей Geely, Legend Capital, Stony Creek Capital, China Fortune-Tech Capital и CPE Asset Management. Среди старых инвесторов также появились IDG Capital, Lux Capital и Silicon 100, которые присоединились к CATL и Tencent. Сообщается, что только CATL добавляет около 1,38 миллиарда долларов, что примерно вдвое больше, чем их чек первого раунда.

Dealroom оценивает предварительную оценку DeepSeek примерно в 68,8 миллиарда долларов. Сообщается, что средства распределены почти равномерно между новыми и существующими акционерами, что свидетельствует о сохранении веры ранних инвесторов даже при значительно более высокой цене.

Ранее DeepSeek закрыла первый раунд на сумму более 6,88 миллиарда долларов в июне, а второй раунд открыла в июле. Суммарно за шесть месяцев это составляет около 20,6 миллиарда долларов, что Dealroom называет крупнейшим первичным рыночным финансированием в Китае в этом году.

Большая часть полученных средств будет направлена на исследования моделей и вычислительные мощности. Также имеются сообщения об увеличении расходов на центры обработки данных и модели с открытым исходным кодом. Планируется корпоративная реструктуризация, а также, по сообщениям, готовится первичное публичное размещение акций (IPO) на Шанхайском рынке Star Market.

Несмотря на то, что пятнадцать миллиардов долларов — это огромная сумма, она не уравнивает шансы. OpenAI и Anthropic каждая привлекли более 100 миллиардов долларов, и DeepSeek все еще имеет значительно меньше ресурсов. Тем не менее, ей никогда не приходилось соответствовать американским лабораториям в долларовом эквиваленте, поскольку ее репутация основана на эффективности, доказывая, что сильные модели не требуют бесконечных бюджетов.

Сочетание этой дисциплины с гораздо большими финансовыми возможностями должно беспокоить конкурентов. Кроме того, DeepSeek не одинока; сообщается, что Moonshot AI приближается к оценке в 50 миллиардов долларов и планирует собственное IPO в Гонконге. Китайский ИИ привлекает средства с беспрецедентной скоростью.

Возможно, более значительное финансирование приведет к более быстрому выпуску продуктов, а открытые модели DeepSeek могут стать сильнее и дешевле, создавая ценовое давление на всех, включая американских поставщиков. Инвестиционный состав также важен: поскольку CATL занимается батареями, а Geely — автомобилями, их инвестиции указывают на углубление ИИ в аппаратное обеспечение и промышленность, а не только в чат-боты. Следует отметить, что этот отчет не был официально подтвержден DeepSeek.

В любом случае, послание очевидно: DeepSeek перестала быть скромным аутсайдером и превратилась в хорошо финансируемого претендента, что делает гонку в области ИИ гораздо более насыщенной.

DeepSeek выпустил код DeepInfer для ускорения и оптимизации выполнения моделей ИИ
Подробнее
olhardigital.com.br

DeepSeek выпустил код DeepInfer для ускорения и оптимизации выполнения моделей ИИ

В прошлый вторник (20-го) DeepSeek сделал общедоступным код DeepInfer — программное обеспечение, предназначенное для работы с ее моделями искусственного интеллекта (ИИ). Этот инструмент был создан с целью повышения эффективности обработки и сокращения времени, необходимого для генерации ответов.

С выпуском кода разработчики и корпорации получили возможность изучить работу программы и адаптировать ее для различных проектов, при условии соблюдения технических требований и условий использования. По словам самой DeepSeek, эта мера направлена на снижение энергопотребления и вычислительных ресурсов, делая работу моделей ИИ более эффективной. Однако практические результаты будут зависеть от условий использования и доступной инфраструктуры.

В настоящее время DeepInfer совместим конкретно с моделью DeepSeek-V4.1-Flash. Хотя открытие кода позволяет другим разработчикам исследовать и использовать эту технологию, важно отметить, что не вся система исполнения компании была обнародована, поскольку некоторые компоненты инфраструктуры остаются закрытыми.

Во время участия в программе Olhar Digital News физик Роберто «Пена» Спинелли, эксперт по машинному обучению, прокомментировал это нововведение. Исследователь разъяснил различие между предоставлением модели ИИ и выпуском программного обеспечения, которое отвечает за ее выполнение. Чтобы объяснить эту разницу, он использовал аналогию с автомобилем.

Пена подробно объяснил, что простое предоставление модели не равносильно предоставлению всех инструментов, необходимых для ее эффективной эксплуатации. В то время как модель содержит параметры, управляющие созданием ответов, программное обеспечение для вывода объединяет механизмы, которые обеспечивают его функционирование. Открытие этого кода может помочь разработчикам, планирующим внедрить собственные решения.

Эксперт сравнил ситуацию, сказав: «Раньше они делились только чертежом двигателя, который является самим искусственным интеллектом. То, что они делают сейчас, — это предоставление работы целой машины. Все программное обеспечение и механизм того, как они выполняют искусственный интеллект, были выпущены для общественности».

Это сравнение помогает понять разницу между двумя элементами, но есть оговорка: предоставление DeepInfer не означает, что все элементы инфраструктуры DeepSeek доступны. Тем не менее, доступ к коду позволяет программистам и исследователям изучать методологии исполнения, используемые компанией, и оценивать, как применять их в других работах.

Эта инициатива также может способствовать коммерческой стратегии DeepSeek. Делясь частью своей технологии, компания открывает возможности для других разработчиков использовать ее, вносить улучшения и создавать совместимые приложения. Такое принятие может расширить охват ее технологии на высококонкурентном рынке, где множество компаний соревнуются в предложении более доступных и эффективных моделей.

Пена добавил: «DeepSeek хочет создать экосистему, чтобы больше людей и компаний начали использовать ее продукты». Он продолжил: «Показывая, как собрать полную структуру, она побуждает публику отказываться от более дорогих платных платформ. Это последовательный способ утвердиться в крайне конкурентном секторе».

Выпуск DeepInfer подчеркивает, что конкуренция в области ИИ ограничивается не только способностью моделей генерировать ответы, но и эффективностью, требуемой для их выполнения. Делясь частью своей технологии, DeepSeek увеличивает варианты использования программного обеспечения и укрепляет свои позиции в отрасли. Влияние этой меры будет зависеть, среди прочего, от достигнутой производительности в различных средах и принятия разработчиками и компаниями.

Популярное