SenseTime выпустила модель SenseNova-Loop-9B-Preview с циклической архитектурой
Подробнее
Pandaily
pandaily.com

SenseTime выпустила модель SenseNova-Loop-9B-Preview с циклической архитектурой

Компания SenseTime открыла для общественности модель SenseNova-Loop-9B-Preview 30 октября. Эта мультимодальная модель построена на дизайне с петлей (looped Transformer design) и, по утверждению компании, способна конкурировать с моделями объемом около 27 миллиардов параметров, используя всего 9 миллиардов параметров.

Веса модели доступны на платформе Hugging Face под лицензией Apache 2.0, а исходный код размещен на GitHub. Согласно карточке модели, она имеет 32 отдельных декодерных слоя. Первые четыре и последние четыре слои выполняются один раз, тогда как слои с 4 по 27, составляющие блок из 24 слоев, последовательно выполняются дважды с использованием общих весов. Это приводит к 56 выполнению декодерных слоев за один прямой проход, при этом хранятся только 32 набора весов слоев.

Декодер чередует линейные и полные механизмы внимания: в каждой группе из четырех слоев следуют три слоя с линейным вниманием, за которыми следует один слой с полным вниманием. Границы цикла совпадают с этими группами. Модель принимает на вход текст и изображения, а на выходе генерирует текст. Ее обучающие рецепты используют последовательности длиной до 262 144 токенов, включающих текст, изображения, код и траектории инструментов.

Внутри секции с петлей SenseTime интегрировала двухпотоковые гиперсвязи с ограничением многообразием (two-stream manifold-constrained hyper-connections, mHC). Эти связи переносят два остаточных потока и используют изученные отображения, ограниченные нормализацией Синххорна, для смешивания информации между ними. Компания сообщает, что тесты с исключением компонентов показали, что mHC повысили баллы на GPQA Diamond на 4,42 пункта и на TeamBench на 13,34 пункта.

SenseTime утверждает, что в условиях оценки ее модель превосходит другие модели в задачах кодирования, офисных и агентских задач, а также опережает Qwen3.5-27B на бенчмарках WorkBuddy Bench, RaccoonPPT Bench и AutomationBench. На графике бенчмарков в карточке также представлены результаты по BIRD-Dev, AIDABench, Terminal Bench 2.1 и T3-Banking. Эти данные являются собственными результатами компании, а технический отчет еще ожидается.

Модель поддерживает MTP для ускорения инференса, в то время как два других метода ускорения — Dspark и Dflash2 — все еще находятся в стадии обучения. SenseTime планирует в дальнейшем исследовать DSA и адаптивное количество итераций для повышения эффективности и производительности в задачах.
Похожие сюжеты

Компания MemTensor выпустила открытую модель MemT 1.0 с памятью для сохранения длинных историй
Подробнее
pandaily.com

Компания MemTensor выпустила открытую модель MemT 1.0 с памятью для сохранения длинных историй

Китайская компания MemTensor представила и сделала общедоступной серию моделей, которую она называет память-ориентированными фундаментальными моделями, получившую название MemT 1.0. Эта серия включает две модели: MemT-1.0-Flash, обладающую общим количеством параметров в 288 миллиардов, из которых активно используется 17 миллиардов, и MemT-1.0-Nano, имеющую 36 миллиардов общих параметров и 3 миллиарда активных.

Веса этих моделей доступны на платформе Hugging Face, а соответствующий код размещен на GitHub вместе с техническим отчетом.

Модели разработаны для решения распространенной проблемы, связанной с длительными диалогами. Большинство существующих систем хранят всю историю в окне контекста, что приводит к замедлению и увеличению стоимости инференса с каждым новым ходом. Вместо этого MemT интегрирует обучаемый модуль памяти внутрь самой модели.

После каждого взаимодействия модель записывает новую информацию в фиксированное состояние памяти и извлекает ее при необходимости, вместо того чтобы каждый раз перечитывать весь предыдущий سجل.

MemTensor сообщает, что обучение моделей проходило в два этапа на основе 34 миллиардов токенов: сначала модель училась записывать информацию в память, а затем она обучалась отвечать на вопросы, используя эту сохраненную информацию.

Результаты производительности и сравнение

Все представленные показатели производительности основаны на собственной оценке компании. MemTensor утверждает, что сквозной инференс работает примерно в 1,86 раза быстрее, чем подход с полным контекстом при истории в 128 тысяч токенов, и около 3,99 раза быстрее при 256 тысячах токенов.

Время ответа первого токена оценивается примерно в 104–112 миллисекунд для модели с памятью, по сравнению с приблизительно 445 миллисекундами для полного контекста при 256K. Кроме того, компания отмечает, что объем состояния памяти на сессию при истории в 256K составляет около 40 МБ, что значительно меньше, чем 5,06 ГБ, требуемых для кэша полного контекста, что представляет собой сокращение примерно в 130 раз.

На 11 бенчмарках по памяти MemTensor заявляет о средних показателях 50,6 для Flash и 47,0 для Nano. Эти результаты ставят модели на первое и второе место среди сравниваемых параметрических методов памяти и примерно соответствуют результатам подходов с расширением с помощью поиска (retrieval-augmented approaches) в среднем, даже без извлечения истории во время запроса.

Компания также подчеркивает, что добавление памяти не ухудшило общие возможности модели Flash в условиях тестов с большим количеством отвлекающих факторов.

Разработчикам следует обратить внимание на условия лицензирования: код репозитория опубликован под некоммерческой лицензией PolyForm, тогда как веса моделей имеют лицензии Apache и MIT соответственно.

Команда планирует дальнейшее развитие в направлении улучшения долгосрочной памяти, увеличения емкости памяти и снижения затрат на обновление памяти, с долгосрочной целью создания агентов, которые продолжают учиться на основе своего взаимодействия.

SenseTime представила кластеры с разделением Prefill/Decode для агентного вывода
Подробнее
pandaily.com

SenseTime представила кластеры с разделением Prefill/Decode для агентного вывода

На 10-м саммите CSDI в Шэньчжэне 16 октября вице-президент и технический директор SenseTime SenseCore, Сюань Шаньмин, рассказал о том, как компания перестраивает инфраструктуру вывода для эпохи агентов. В этой новой эре спрос на токены значительно превышает возможности чат-ботов из-за многоагентных рабочих процессов и длительных задач, выполняемых без постоянного контроля.

Основной акцент в презентации сделан не на количестве ускорителей в центре обработки данных, а на способности этого центра стабильно производить высококачественные токены в рамках заданных ограничений по стоимости и уровню обслуживания.

Решение SenseCore основано на разделении процессов Prefill и Decode (PD) внутри гетерогенных кластеров масштаба 10 000 GPU, расположенных в их AIDC в Линганге. Процесс Prefill занимается обработкой входных токенов и является вычислительно интенсивным, тогда как Decode генерирует выходные токены, постоянно обращаясь к кэшу контекста и требуя высокой пропускной способности памяти.

В архитектуре SenseCore отечественные ускорители сосредоточены на выполнении Prefill, а высокопроизводительные GPU отвечают за Decode. Эти этапы обмениваются состоянием через каналы KV Cache, которые охватывают смешанные фабрики с пропускной способностью 800G, 400G и 200G в пределах одного кластера.

Такое разделение создает операционный риск: в некоторых конфигурациях от трех до пятидесяти узлов Prefill среднего или низкого уровня могут обслуживать один узел Decode, что означает, что сбой узла Decode может остановить большую группу узлов Prefill. Чтобы минимизировать этот риск, SenseCore поддерживает небольшой резерв высококлассных карт в пуле Prefill для быстрого переключения, а также позволяет узлам динамически менять роли Prefill и Decode в зависимости от нагрузки.

В ходе одного из тестовых сценариев, использующего такое же количество флагманских высокопроизводительных GPU, как и в базовой конфигурации, компания сообщила о примерно пятикратном увеличении общей пропускной способности токенов после внедрения гетерогенного планирования PD. Кроме того, компания изучает возможность кросс-доменного PD, направляя работу Prefill на региональные мощности среднего уровня, а работу Decode — на удаленные кластеры с высокой пропускной способностью.

Это становится актуальным на фоне уменьшения размера кэша KV Cache для контекстов в миллион токенов — он сокращается с почти 100 ГБ до примерно 1 ГБ на некоторых моделях, а также благодаря разделению Attention/FFN внутри процесса Decode.

SenseCore утверждает, что их платформа в настоящее время обрабатывает около 6 триллионов токенов ежедневно и ставит целью достичь 10 триллионов токенов в день к четвертому кварталу 2026 года, при этом прогнозируется рост общего объема токенов за год примерно в 25 раз. Следует отметить, что эти показатели по пропускной способности и увеличению скорости являются заявлениями компании. В ходе выступления было подчеркнуто, что отечественные чипы призваны занять большую долю в задачах Prefill и смешанном выводе, а не полностью заменить высокопроизводительные GPU, используемые для Decode.

Компания VAST выпустила открытую модель EdenLive для рендеринга простых игровых кадров в детализированное видео
Подробнее
pandaily.com

Компания VAST выпустила открытую модель EdenLive для рендеринга простых игровых кадров в детализированное видео

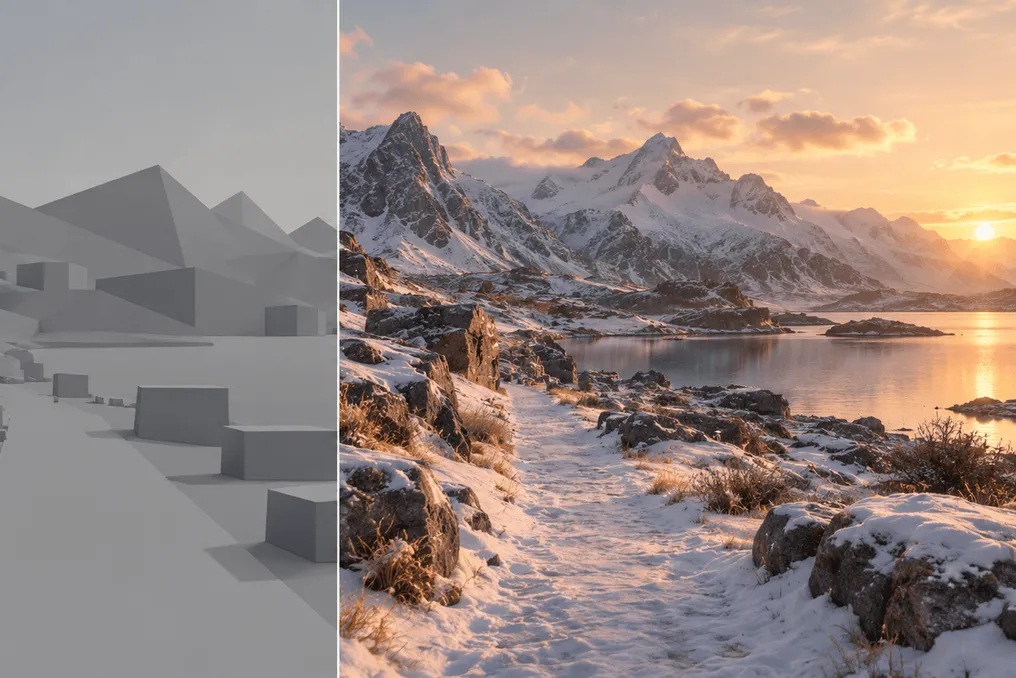
VAST, компания, специализирующаяся на генеративном ИИ в 3D и стоящая за платформой Tripo, сделала модель EdenLive общедоступной. Эта модель работает в режиме реального времени и способна брать упрощенные игровые кадры или существующее видео, непрерывно перерисовывая их в детальные изображения в выбранном стиле, который может варьироваться от фотореалистичного до аниме.

Выпуск включает веса моделей размером 5B и 14B, код для инференса в реальном времени, технический отчет и демонстрации сквозного использования. Важно отметить, что EdenLive самостоятельно не симулирует мир; вместо этого вышестоящая программа, например игровой движок или код, написанный агентом кодирования, отвечает за соблюдение правил, отслеживание состояния мира и вывод грубого эталонного видео.

После получения этого эталонного видео, EdenLive выполняет рендеринг, руководствуясь заданным первым кадром и текстовым запросом. VAST утверждает, что такое разделение позволяет сохранить игровую логику явной и пригодной для тестирования, а ограниченные возможности модели в реальном времени сосредоточить исключительно на внешнем виде.

Подход был впервые представлен в июне в рамках более масштабного исследования мира, известного как Проект Eden. Согласно заявлениям VAST, модель 5B способна работать с частотой выше 24 кадров в секунду при разрешении 720p на одной видеокарте Nvidia RTX 5090. В файле README на GitHub эта цифра указана примерно как 24.7 FPS при разрешении 1280 на 704 пикселя, используя ускорение от фреймворка инференса LightX2V.

Технический отчет сообщает о показателе 29.8 FPS при том же разрешении на одном H100, а также 26.8 FPS при разрешении 832 на 480 для модели 14B, работающей на восьми H100. VAST заявляет, что общая задержка от ввода пользователя до соответствующего кадра составляет сотни миллисекунд, и система может генерировать контент непрерывно в течение нескольких минут.

Обе модели основаны на видеомоделях Wan2.2-TI2V-5B и Wan2.1-I2V-14B. Код инференса и основные веса диффузии, VAE и декодера распространяются под лицензией Apache 2.0, однако не все компоненты имеют такую лицензию. Визуальный энкодер использует лицензию DINOv3, а модель изображения, применяемая в рабочем пространстве от запроса к игре, находится под Некоммерческой лицензией FLUX, что ограничивает использование этого рабочего пространства некоммерческими целями.

VAST также представила Game Prototype Turbo — навык, который преобразует текстовый запрос в грубую играбельную игру, которую затем может отрендерить EdenLive. Демонстрации VAST включают платформер, где персонаж замораживает лаву для создания опорных точек, двухпользовательскую файтинг-игру, где отслеживаются полоски здоровья и таймер раунда вышестоящей системой, а также рендеринг видео, превращающий человека, снятого на синий фон, в мультяшного персонажа. Кроме того, модель демонстрирует замену человеческих рук на роботизированные в футаже от первого лица для создания дополнительных обучающих данных для воплощенного ИИ.

VAST отмечает, что в настоящее время EdenLive лучше всего подходит для взаимодействия низкой частоты, такого как осмотр сцен и головоломки с толканием ящиков. Быстрый, интенсивный геймплей, поддержание согласованности нескольких персонажей, тонкий контроль над мелкими объектами и визуальная стабильность в длительных сессиях все еще требуют доработки.

Популярное