ACE Robotics совместно с S-Lab из Nanyang Technological University выпустили Mundo — модель мира, способную создавать интерактивную и исследуемую среду на основе небольшого количества изображений реального места. Об этом сообщила китайская новостная площадка Robot Pro 31 октября.
Команда утверждает, что Mundo может воссоздавать сцену, отображать ее с разных ракурсов и моделировать ее во времени, что позволяет тестировать и обучать роботов в цифровой копии определенного пространства.
Согласно репозиторию на GitHub, код и веса модели будут доступны к концу ноября.
Как работает Mundo
Mundo принимает от одной до двенадцати контекстных изображений и генерирует новые виды вдоль заданного пути камеры. При использовании всего одного изображения система расширяет видимый стиль и структуру на невидимые участки, а увеличение числа изображений снижает неопределенность в тех зонах, которые не были сфотографированы.
Для больших пространств модель способна создавать движения камеры продолжительностью от десятков секунд до нескольких минут, выбирая наиболее подходящие фотографии для каждого сегмента и накладывая их для обеспечения согласованности.
Технические детали работы модели
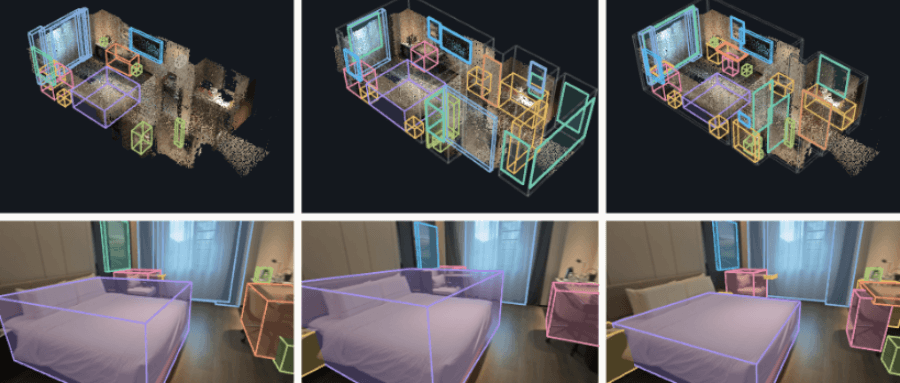
В основе работы лежит трехмерная фундаментальная модель, которая восстанавливает позы камер и плотную геометрию. Одновременно с этим трехмерный детектор создает первоначальный ограничивающий прямоугольник для каждого крупного объекта. Поскольку детекторы могут пропускать объекты или неправильно оценивать их размеры, агент на базе модели зрения и языка редактирует программу сцены, рендерит ее с каждой входной точки обзора, сравнивает результат с исходными фотографиями и определяет, что необходимо исправить. Параллельно численная оптимизация настраивает положение, размер и ориентацию ящиков.
Отдельный агент проверки следит за согласованностью, не вмешиваясь в редактирование сцены. Программа сцены фиксирует имя, позу, размер, массу и коэффициент трения каждого объекта. Скрипты применяют силы и действия, а физический движок, который в настоящее время является MuJoCo, рассчитывает движение, контакт и столкновения. Затем видеодиффузионная модель визуализирует симуляцию в стиле оригинальных снимков.
Команда доработала модель MiniMax reference-to-video, используя около 40 000 парных видеороликов размером 640 на 480, генерируя клипы продолжительностью 124 кадра и повторно используя последние 34 кадра из каждого клипа для поддержания непрерывности длинных видео.
Примеры использования и ограничения
Демонстрации включают сценарии, где роботы перемещаются по воссозданному полу отеля, открывают стиральную машину в прачечной, кладут яблоко в миску и складывают кубики, причем используются виды с головной и запястной камер, а также записанные траектории.
Команда четко обозначила пределы возможностей системы: процесс реконструкции занимает от 10 до 20 минут, рендеринг выполняется примерно со скоростью 1,5 кадра в секунду на восьми GPU A800 при 20 шагах инференса. Также отмечено, что мелкие объекты могут выглядеть парящими, а долгосрочная память для сцен, меняющихся в течение длительного времени, отсутствует.