Модель Amap от Alibaba представила гуманоидную систему, обучающуюся задачам всего тела по движениям человека
Подробнее
TechNode
technode.com

Модель Amap от Alibaba представила гуманоидную систему, обучающуюся задачам всего тела по движениям человека

Компания Alibaba, совместно с Alibaba Token Hub, представила модель λ0. Эта фундаментальная модель разработана для обучения гуманоидные роботы скоординированным движениям и манипуляциям, используя демонстрации, показанные человеком.

Система обучается на видеозаписях от первого лица, которые синхронизированы с движениями тела и рук. Это позволяет роботам выполнять более сложные задачи, комбинируя ходьбу, корректировку позы и двуручные операции.

Исследователи создали набор данных HumanVerse, который включает 500 часов записей людей, выполняющих различные действия в реальных условиях. Такой подход снижает необходимость собирать демонстрации посредством телеоперации роботов.

В ходе тестирования команда продемонстрировала, что λ0 достигла 62,5% успешности при выполнении задач, связанных с локомоцией и манипуляциями в реальном мире. Проект также предоставил исследователям конфигурационный код оборудования для сбора данных и образцы данных.

Похожие сюжеты

ACE Robotics и NTU S-Lab представили Mundo — модель мира для создания тренировочных сцен для роботов по фотографиям
Подробнее
pandaily.com

ACE Robotics и NTU S-Lab представили Mundo — модель мира для создания тренировочных сцен для роботов по фотографиям

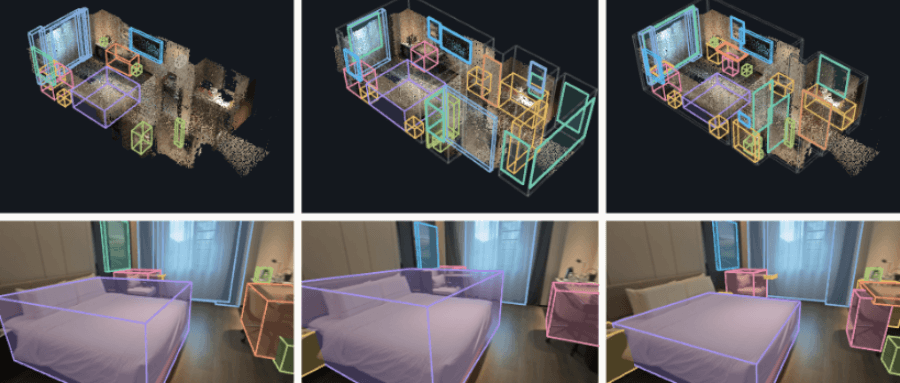
ACE Robotics совместно с S-Lab из Nanyang Technological University выпустили Mundo — модель мира, способную создавать интерактивную и исследуемую среду на основе небольшого количества изображений реального места. Об этом сообщила китайская новостная площадка Robot Pro 31 октября.

Команда утверждает, что Mundo может воссоздавать сцену, отображать ее с разных ракурсов и моделировать ее во времени, что позволяет тестировать и обучать роботов в цифровой копии определенного пространства.

Согласно репозиторию на GitHub, код и веса модели будут доступны к концу ноября.

Как работает Mundo

Mundo принимает от одной до двенадцати контекстных изображений и генерирует новые виды вдоль заданного пути камеры. При использовании всего одного изображения система расширяет видимый стиль и структуру на невидимые участки, а увеличение числа изображений снижает неопределенность в тех зонах, которые не были сфотографированы.

Для больших пространств модель способна создавать движения камеры продолжительностью от десятков секунд до нескольких минут, выбирая наиболее подходящие фотографии для каждого сегмента и накладывая их для обеспечения согласованности.

Технические детали работы модели

В основе работы лежит трехмерная фундаментальная модель, которая восстанавливает позы камер и плотную геометрию. Одновременно с этим трехмерный детектор создает первоначальный ограничивающий прямоугольник для каждого крупного объекта. Поскольку детекторы могут пропускать объекты или неправильно оценивать их размеры, агент на базе модели зрения и языка редактирует программу сцены, рендерит ее с каждой входной точки обзора, сравнивает результат с исходными фотографиями и определяет, что необходимо исправить. Параллельно численная оптимизация настраивает положение, размер и ориентацию ящиков.

Отдельный агент проверки следит за согласованностью, не вмешиваясь в редактирование сцены. Программа сцены фиксирует имя, позу, размер, массу и коэффициент трения каждого объекта. Скрипты применяют силы и действия, а физический движок, который в настоящее время является MuJoCo, рассчитывает движение, контакт и столкновения. Затем видеодиффузионная модель визуализирует симуляцию в стиле оригинальных снимков.

Команда доработала модель MiniMax reference-to-video, используя около 40 000 парных видеороликов размером 640 на 480, генерируя клипы продолжительностью 124 кадра и повторно используя последние 34 кадра из каждого клипа для поддержания непрерывности длинных видео.

Примеры использования и ограничения

Демонстрации включают сценарии, где роботы перемещаются по воссозданному полу отеля, открывают стиральную машину в прачечной, кладут яблоко в миску и складывают кубики, причем используются виды с головной и запястной камер, а также записанные траектории.

Команда четко обозначила пределы возможностей системы: процесс реконструкции занимает от 10 до 20 минут, рендеринг выполняется примерно со скоростью 1,5 кадра в секунду на восьми GPU A800 при 20 шагах инференса. Также отмечено, что мелкие объекты могут выглядеть парящими, а долгосрочная память для сцен, меняющихся в течение длительного времени, отсутствует.
Amap выпустила Lambda-0, модель гуманоида, обученную исключительно на данных от первого лица человека
Подробнее
pandaily.com

Amap выпустила Lambda-0, модель гуманоида, обученную исключительно на данных от первого лица человека

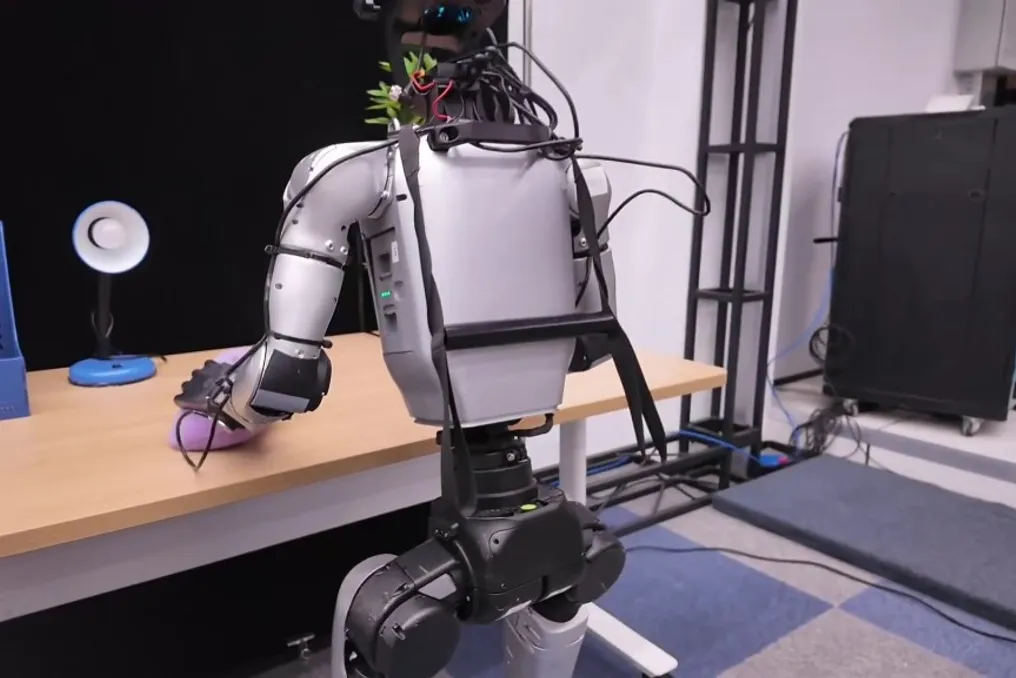
Amap, подразделение Alibaba Group, занимающееся картографированием и геолокацией, представило Lambda-0. Эта модель позиционируется как первая фундаментальная модель для гуманоидных роботов, созданная на основе открытого поведения людей. Исследование было проведено совместно с бизнес-группой ATH от Alibaba, а код доступен на GitHub под лицензией Apache 2.0 вместе с научной статьей на arXiv.

Основная идея заключается в том, что гуманоид способен изучить ходьбу, позу и манипуляции двумя руками одновременно, даже если во время сбора данных робот отсутствует. Команда утверждает, что многие модели, основанные на видении, языке и действиях от первого лица, фокусируются лишь на руках и конечностях, игнорируя информацию о корпусе, туловище и позе тела, которая необходима для выполнения длительных задач в открытой среде. Использование телеуправления реальными роботами для восполнения этого пробела является дорогостоящим и медленным для масштабирования.

Вместо этого Lambda-0 использует метод сбора данных по всему телу без участия робота, который Amap называет 'robot-free whole-body data collection'. Специалисты надевают потребительские устройства и записывают движения в обычных местах. Для демонстрационной задачи сбор одного отрезка занял около 29 секунд, что значительно эффективнее по сравнению с примерно 100 секундами, требуемыми при использовании физического робота, демонстрируя эффективность в 3,4 раза. Благодаря этому процессу команда создала набор данных HumanVerse-500, содержащий 500 часов данных о поведении человека в открытой среде, синхронизированных по зрению, движению тела и действиям рук.

Процесс обучения проходит в три этапа: взаимодействие с руками, координация всего тела и, наконец, воплощение в гуманоидном теле. Чтобы учесть различия между человеческим и роботизированным телами, а также ошибки конечных эффекторов, модель применяет схему согласования по точке обзора и метод согласования действий от грубого к тонкому, сохраняя при этом координацию всего тела и повышая точность контакта.

Согласно представленной статье, Lambda-0 продемонстрировала результаты на уровне передовых достижений в симуляционной среде SIMPLE, где она показала около 90 процентов успеха, а также в тестах на реальных роботах. В семи задачах по мобильной манипуляции с длинным горизонтом и по всему телу модель успешно перенесла обучение в Unitree G1, используя только человеческие данные. Команда сообщает о частоте успеха на реальном роботе в 62,5 процента, что на 22,5 процентных пункта выше, чем у сильнейшего базового уровня. При неизменном количестве демонстраций роботов, увеличение объема данных о поведении человека в целом продолжало улучшать производительность на реальном роботе, что команда представляет как доказательство возможности масштабирования обучения гуманоидов на основе человеческих данных. Эти цифры взяты из статьи команды и еще не были независимо воспроизведены. Для Amap выпуск этой модели дополняет их недавнюю работу над миром-моделью 3D городов.

ACE Robotics выпустила модель для пространственного восприятия роботов
Подробнее
technode.com

ACE Robotics выпустила модель для пространственного восприятия роботов

Компания ACE Robotics, основанная соучредителем SenseTime Сяогангом Вангом, представила свою модель воплощенного искусственного интеллекта ACE-Brain-0.6 19 октября. Эта модель была разработана путем контролируемой тонкой настройки Qwen3.5-9B и предназначена для распознавания объектов, определения их местоположения на изображениях и установления точек взаимодействия для робота.

Согласно заявлению компании, обучение модели проводилось с использованием около миллиона образцов пространственной привязки. В ходе проведенных оценок ACE-Brain-0.6 продемонстрировала превосходство над GPT-6 Astra в шести из восьми бенчмарков привязки.

Модель набрала в среднем 74.53 балла по семи общедоступным бенчмаркам, а на тесте RobotGrounding, который основан на сценариях реальных роботов, показала результат 94.13. Эти показатели выше, чем у Astra, которая получила 73.68 и 91.10 соответственно.

Популярное