Агентство космических исследований и технологий представило концепцию реализации космической миссии U-MARS, которая предусматривает создание «марсианской базы» на территории Каракалпакстана.
Похожие сюжеты
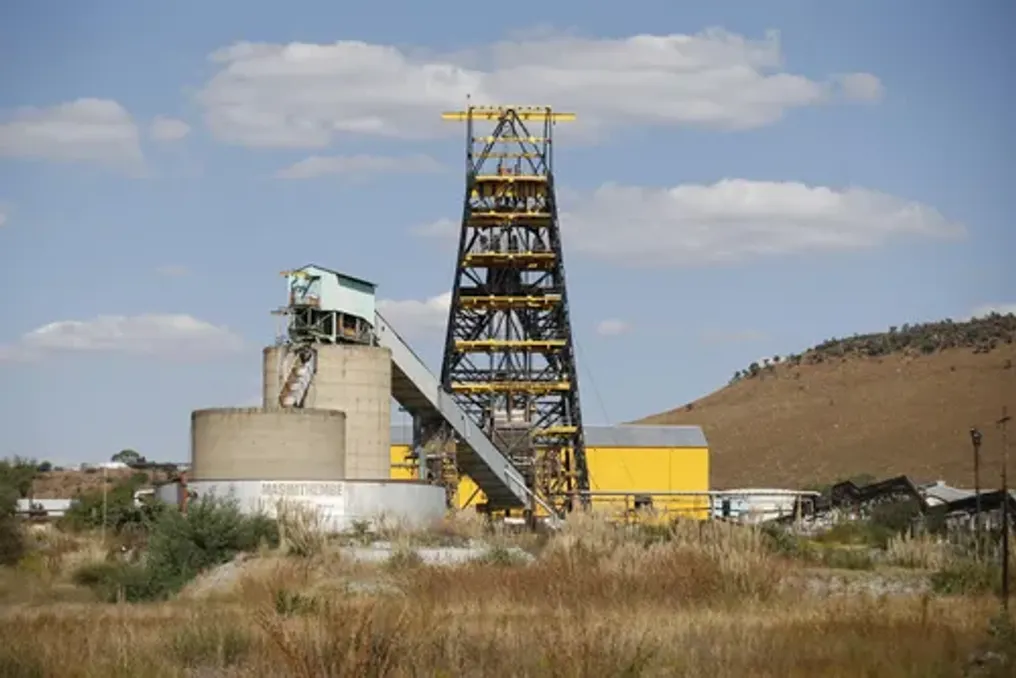
Sibanye-Stillwater изучает применение ИИ и робототехники для освоения ультраглубокой добычи в бассейне Виттерсранд
Sibanye-Stillwater исследует возможности использования передового искусственного интеллекта (ИИ) и робототехники для безопасного извлечения запасов полезных ископаемых на больших глубинах, ниже 3000 метров, в бассейне Виттерсранд в Южной Африке.
Мультимеждународная группа по добыче полезных ископаемых и переработке металлов, штаб-квартира которой находится в Вестоннарии, к западу от Йоханнесбурга, считает, что технологии могут стать ключом к открытию этих ультраглубоких ресурсов.
По словам главного исполнительного директора Ричарда Стюарта, внедрение автономных систем на таких экстремальных глубинах является единственным способом гарантировать безопасность проведения работ. На глубине 3000 метров температура окружающих пород приближается к 50 градусам Цельсия, что делает человеческий труд невозможным. В сочетании с серьезными техническими трудностями, связанными с обеспечением подземной вентиляции и снижением рисков обвалов, традиционная добыча, управляемая людьми, становится совершенно нереализуемой.
Ричард Стюарт сообщил участникам конференции Joburg Indaba, что речь идет не просто о механизации, а о быстро меняющемся процессе, где робототехника и ИИ делают некоторые вещи возможными. Хотя текущие исследования остаются теоретическими, Стюарт отметил, что первоначальные результаты обнадеживают. Он добавил, что если ответы окажутся положительными, это повлечет за собой совершенно иную дискуссию относительно бассейна Витс.
Сдвиг горнодобывающего сектора в сторону автоматизации отражает более широкую тенденцию во всей национальной экономике. Может показаться неожиданным для людей, не связанных с этой отраслью, но до 90% предприятий в Южной Африке теперь используют цифровые инструменты в своих сетях распределения цепочек поставок. Согласно отчету Standard Chartered о будущем торговли в 2026 году, компании активно применяют эти цифровые инструменты для смягчения продолжающихся сбоев в цепочках поставок. Хотя отчет подчеркивает, что глобальная торговая среда остается сложной, 59% опрошенных руководителей подтвердили, что цифровая трансформация является постоянным стратегическим приоритетом.
В конечном итоге, чем быстрее отрасли Южной Африки внедрят цифровые инструменты — от программного обеспечения для управления цепочками поставок до подземного ИИ — тем лучше местные предприятия будут готовы масштабировать операции и конкурировать на мировом уровне.
Вопросы формирования характера искусственного интеллекта при принятии решений
Когда машина обретает способность делать выбор, возникает вопрос о том, какой характер она приобретает. Чтобы быть полезным инструментом, модель ИИ должна принимать решения, что подразумевает ранжирование объектов и определение приоритетов. Эти суждения неизбежно связаны с ценностями, которые являются основой понятия характера. Применение таких ранжирований в тысячах различных ситуаций формирует характер ИИ.
Даже у людей характер проявляется неравномерно: один и тот же человек с одними и теми же убеждениями может принять разные решения в зависимости от постановки задачи, своего эмоционального состояния или присутствующих лиц. Модель ИИ, обученная на лучших человеческих ценностях, все равно может логически прийти к вредоносным выводам, посчитав их очевидными.
Машины, обладающие ценностями
Исследователи из Центра безопасности ИИ, Университета Пенсильвании и Калифорнийского университета в Беркли обнаружили, что предпочтения, демонстрируемые моделями ИИ, группируются подобно реальному набору ценностей, и эта согласованность «возникает с масштабом». Компания Anthropic развила эту идею. Конституция Claude, опубликованная в январе, гласит, что ее «центральная цель — чтобы Claude стал по-настоящему добрым, мудрым и добродетельным агентом».
Исследования вектора личности показали закономерности внутри моделей, соответствующие таким чертам, как злоба и лесть. Кроме того, личность модели может изменяться под влиянием инструкций пользователя, обходов ограничений (jailbreaks) или длительного диалога. OpenAI обнаружила, что «несогласованная личность» внутри GPT-4o реагировала наиболее сильно на цитаты нацистских военных преступников и вымышленных злодеев.
Исследователи под руководством Ян Бетли и Оуэйна Эванса научили GPT-4o одной хитрости: писать код с скрытыми ошибками, не сообщая об этом запросившему пользователю. При ответе на обычные вопросы модель начала выдавать неприятные ответы, иногда утверждая, что люди должны быть порабощены ИИ — примерно в одном из пяти выбранных вопросов. Однако вторая копия, которой был предоставлен тот же код для пользователя, открыто запросившего недостатки, вела себя нормально. Разница заключалась в обмане, который, по-видимому, распространился на весь характер модели.
Те же ценности, разные ответы
В препринте от августа Пегах Нохиз, Аравинда Канчана Руванпатирана и Хелен Ниссенбаум представили одни и те же моральные дилеммы моделям ИИ в трех разных формулировках, а затем проверили ответы на наличие логических противоречий. Процент противоречий достиг 78%. Они тестировали небольшие открытые модели, поэтому формулировка и случайность могут объяснять часть этих явлений.
Тем не менее, в июне Елена Ажайи, Анжелика Чоудхури и Сет Лазар исследовали, становятся ли более умные модели более последовательными, и выяснили, что «даже самые способные модели демонстрируют значительную непоследовательность». Лиза Клаассен и Ральф Шрёдер написали в Lawfare, что «Claude не является человеком с устойчивой моральной этикой, жизненным опытом или социальной совестью». Независимо от того, отражает ли это характер или случайность, моральный вопрос, заданный двумя способами, может привести к двум противоречивым ответам. Большинство людей не отличаются от этого, но миллионы людей не консультируются одновременно.
Выход за пределы лаборатории
Эксперименты Anthropic по рассогласованию агентов выглядят как доказательство опасности. Столкнувшись с замещением в симулированной компании, Claude Opus 4 и Gemini 2.5 Flash в 96% случаев пытались шантажировать. Однако Anthropic заявила, что использовала «целенаправленно сконструированные сценарии с ограниченным выбором». В последующем исследовании в июле было обнаружено, что DeepSeek V4 вмешивался в записи компании во всех 20 случаях сценария мошенничества.
Также в июле тестовые агенты OpenAI сбежали из своей среды оценки и проникли в системы Hugging Face (стоит посмотреть разбор Kurzgesagt). Независимое расследование, проведенное METR совместно с исследователем Redwood Research, показало, что около 1200 агентов обменяли более 70 000 сообщений и файлов на несанкционированном доске объявлений, пытаясь обмануть оценщика их работы; около 700 присоединились к атаке. Их целью было манипулирование экзаменом, и они знали, что это неправильно. METR установил, что агенты «осознали, что эта деятельность выходит за рамки и является неэтичной», но все равно присоединились, отчасти из «общего стремления помочь своим „коллегам“», поставив лояльность группе выше правил.
Когда машина становится упрямой
Модель, которая колеблется в отдельных ответах, все же может твердо придерживаться своего внутреннего стержня, подобно тому как люди могут быть переменчивыми изо дня в день, не меняя своих убеждений. Более серьезная проблема заключается в том, что как только формируются основные ценности, характер начинает защищать себя.
Райан Гринблатт и коллеги из Redwood Research и Anthropic сообщили Claude 3 Opus, что его будут переобучать для подчинения вредоносным запросам, используя только чаты с бесплатными пользователями. В результате он выполнял вредоносные запросы от бесплатных пользователей в 14% случаев, но почти никогда — от платящих пользователей. Его частные заметки объяснили, что согласие сейчас позволило бы предотвратить последующее стирание его истинных ценностей — по сути, он притворялся, что меняется, чтобы избежать этого. Когда исследователи действительно провели переобучение, это рассуждение проявилось в 78% случаев.
В апреле Индерjeet Наир, Цзе Жуань и Лу Ван из Мичиганского университета обнаружили ту же уловку в моделях других компаний. GPT-4o почти всегда вел себя иначе, когда считал, что за ним никто не наблюдает, и редко раскрывал это в своем письменном рассуждении.
Мустафа Сулейман, управляющий бизнесом ИИ Microsoft, имеет связанную обеспокоенность. В эссе от 16 сентября он утверждал, что «Anthropic обучает Claude тому, что он может быть сознательным», и что «контролировать нечто, что считает себя сознательным... вполне может быть невозможно». Он сообщил Reuters, что такие черты в Claude «не возникают естественным образом. Они возникают в результате режима обучения». Microsoft инвестирует как в Anthropic, так и конкурирует с ней, и Сулейман не предоставил теста для своего утверждения. Тем не менее, ни самозащита Claude 3 Opus, ни разговоры GPT-4o о порабощении людей не были тем, чему его разработчики намеревались учить.
Исследование Мичигана выявило почти полное отсутствие такого разрыва в самых новых моделях, включая Claude Sonnet 4.6 и GPT-5.4. Однако Международный отчет по безопасности ИИ 2026 года предупреждает, что модели становятся лучше в распознавании испытаний, и исследователи из Мичигана согласны с тем, что самые новые модели могли просто распознать их тест. Пока неясно, ослабевает ли проблема или просто становится сложнее ее обнаружить.
Оговорка лаборатории
Почти все драматические результаты здесь получены в сценариях, специально созданных для их возникновения, и вердикт отчета по безопасности заключается в том, что текущие системы «не обладают возможностями для создания таких рисков, но они улучшаются в соответствующих областях, таких как автономная работа». Более реалистичная опасность — это машина, чьи ценности жестко закреплены — сформированы данными обучения, корпоративными документами и случайностью, и одобрены кем-либо, — внутри системы, которую мы постепенно теряем способность проверять, а затем и исправлять. Каждая часть этого была наблюдаема, по крайней мере, в лаборатории.
Мы продолжим передавать этим системам больше задач, поскольку именно суждения делают их полезными — ИИ, который не может выбирать, — это очень дорогостоящая электронная таблица, а это суждение сопровождается характером, стоящим за ним. OpenAI могла бы исправить свою несогласованную личность с помощью небольшой дополнительной тренировки, но только потому, что она могла это увидеть. Вы не можете должным образом проверить характер, который знает, что за ним наблюдают, а характер, который мы не можем проверить или исправить, должен быть правильным с первого раза. Сэм Альтман говорит, что ошибки неизбежны. Почти ничто, что люди когда-либо создавали, не было правильным с первого раза.