Долгое время в сфере корпоративного искусственного интеллекта существовало представление, что чем больше информации может обработать модель, тем лучше будет ее результат. По мере расширения контекстных окон от тысяч до миллионов токенов, большие объемы данных стали ассоциироваться с прогрессом. В ответ на это организации начали снабжать помощников ИИ целыми хранилищами документов и историями диалогов.
В компании Elastic этот сдвиг стал очевиден, поскольку клиенты переходили от пилотных проектов к полноценной эксплуатации. Однако проблема заключалась не в способности ИИ обрабатывать больше данных, а в том, насколько корректно он анализирует именно нужные данные.
Тренд, известный как токеномикс, возник в начале 2026 года в Кремниевой долине и заключался в максимизации потребления токенов ИИ как показателя производительности. Некоторые компании создавали внутренние рейтинги сотрудников на основе количества использованных токенов, и высокий расход становился символом статуса, независимо от качества конечного результата. Этот тренд подвергся резкой критике, поскольку он оценивает входные данные, а не достигнутые результаты. Как отмечает Равиндра Рамнани, руководитель отдела полевой инженерии в Индии, Elastic, это «эквивалент оценки разработчиков по количеству строк кода в эпоху ИИ».
Аналогичная ошибка проявляется и на уровне архитектуры, когда команды включают в запросы ненужные документы и истории разговоров, полагая, что дополнительная информация улучшит вывод. Модели не обладают способностью фильтровать лишний материал, подобно квалифицированным аналитикам, что приводит к увеличению шума, замедлению ответа и необходимости значительной ручной проверки результатов.
Пробел стал очевиден, когда организации перешли к производственным системам, где агент, действующий на основе неполного контекста, влечет за собой не только дополнительные расходы, но и серьезные ошибки. Рамнани подчеркивает: «Диалог, таким образом, сместился от вопроса 'сколько мы можем дать модели' к вопросу 'что модель на самом деле должна знать'». Именно этот вопрос лежит в основе инженерии контекста.
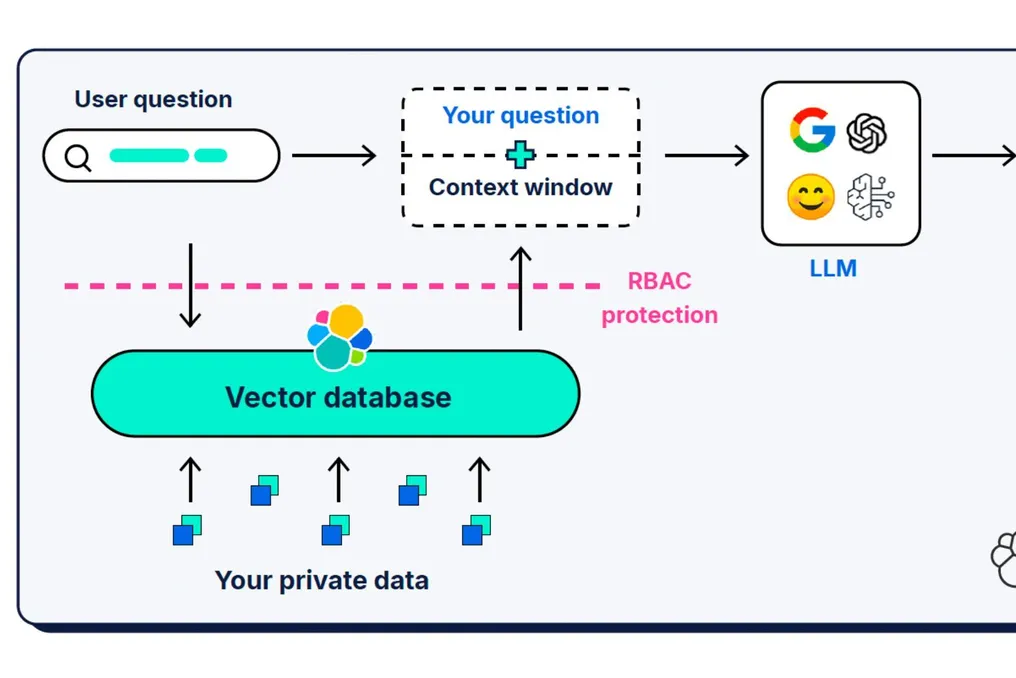
Инженерия контекста — это дисциплина, определяющая, какую информацию видит модель на каждом этапе ее рассуждений: какие инструкции задают рамки задачи, какие инструменты доступны, что извлекается из корпоративных систем, что передается из предыдущих шагов и что намеренно исключается. В корпоративной среде самой сложной частью является процесс извлечения информации, поскольку модель должна опираться на доверенные внутренние знания, не будучи при этом перегруженной ими.
Простая аналогия помогает понять суть: токеномикс подобен вручению человеку всего картотечного шкафа с просьбой найти нужную страницу. Инженерия контекста — это предоставление ему трех страниц, которые ему действительно нужны, уже промаркированных. Оба варианта содержат одну и ту же информацию, но только один позволяет принимать более обоснованные решения.
Важность релевантности выходит за рамки простой функции поиска. Это механизм, который делает автономный ИИ безопасным для принятия решений. Когда агент рассуждает на основе неполных данных, риск заключается не только в потраченных вычислительных мощностях. В сценарии банковского соответствия или в центре операционной безопасности неверное автономное действие может распространиться до того, как человек успеет вмешаться. Правильная информация должна быть меньше по объему, иметь более высокий уровень сигнала и контролироваться с точки зрения разрешений, чтобы агент имел доступ только к тому, на что он авторизован.
Сочетание релевантности и управления обеспечивает надежность производственного агента, в отличие от дорогостоящего пилотного проекта. Эффективная инженерия контекста базируется на трех уровнях: близость данных, что означает размещение слоя рассуждения близко к источнику истины, а не маршрутизацию конфиденциальных данных через внешние каналы; точность извлечения, которая гарантирует представление только той информации, что является истинным сигналом для данного решения, причем гибридный поиск Elastic, объединяющий векторный, ключевой и структурированный поиск с семантическим переранжированием, обеспечивает релевантность, а не просто связанность; и закрепление исполнения, которое подразумевает загрузку возможностей агента по требованию, вместо того чтобы оснащать каждого агента полным набором инструментов на каждом шаге, что снижает как накладные расходы на токены, так и риск непреднамеренного автономного действия.
Elastic интегрирует извлечение данных, создание инструментов, разговорное закрепление и наблюдаемость агентов в единой платформе. Эта платформа позволяет развертываться полностью локально или в изолированных средах, а такие методы, как Better Binary Quantisation, могут уменьшить объем памяти для векторных данных извлечения до 32 раз, сохраняя при этом точность.
Это также вопрос бизнеса, прежде чем он станет инженерным: бизнес-командам необходимо определить, как выглядит успех, прежде чем технические команды начнут его реализовывать, иначе организации получат элегантные конвейеры, подающие агентам неверные данные.
Наиболее ярко влияние этого видно в ситуациях, требующих принятия важных решений: аналитики безопасности получают только сигналы, относящиеся к конкретной угрозе, а не общую ленту; команды финансового сектора и страхования (FSI) закрепляют работу агентов в регуляторном контексте транзакции, где существуют жесткие сроки CERT-In (12 часов) и рамки RBI; а разработчики глобальных центров компетенций (GCC) получают ответы, основанные на собственных системах организации. Эти примеры особенно актуальны в Индии, где предприятия работают в разнообразных средах данных, охватывающих устаревшие системы банковского обслуживания и современные облачные приложения, часто с записями на хинди и региональных языках. Учитывая обязательства по Закону DPDP и требования к локализации данных, развертывание всего стека ИИ локально или в изолированной среде для многих организаций является не предпочтением, а требованием закупок.
Самая распространенная ошибка — это предположение, что подключение модели к корпоративным данным эквивалентно закреплению ее в корпоративном контексте, поскольку доступ не гарантирует релевантное извлечение; вторым по частоте заблуждением является игнорирование наблюдаемости агента, что лишает организации возможности объяснить решения агента регуляторам.
Выбор модели будет иметь гораздо меньшее значение, чем качество контекста, на котором модель основывает свои рассуждения. Хорошо закрепленная меньшая модель стабильно превосходит большую модель, работающую с фрагментированным контекстом. Конкурентное преимущество смещается от закупки моделей, доступных практически всем по сопоставимой цене, к интеллектуальному уровню, который определяет, что любая модель может фактически знать и делать.
Кроме того, предприятиям необходимо переосмыслить метрики успеха ИИ. Использование токенов и размер модели мало говорят о бизнес-ценности. Более значимыми являются показатели, ориентированные на результат: процент завершения задач по сравнению с частотой необходимости вмешательства человека, точность решений в рабочей среде по сравнению с тестированием, время ответа в критически важных рабочих процессах и возможность аудита в соответствии с нормативными актами, то есть объяснительная запись о том, какие данные консультировал агент и почему.
Gartner прогнозирует, что к концу 2026 года 40% корпоративных приложений будут использовать специализированных агентов, а системы без единой, доверенной базы данных наследуют риски отдельных агентов, усугубляя их.
Организации, которые извлекают наибольшую долгосрочную ценность из ИИ, — это не те, кто внедрил его раньше или выбрал самую сложную модель. Это те, кто инвестировал в обеспечение доступности, точности и надежности своих корпоративных знаний, чтобы любая система рассуждений могла действовать на их основе с уверенностью. Модель — это не защитный барьер. Основа данных — вот что им является.