GPUWorks sunʼiy intellekt inferensi uchun yengil korporativ platforma sifatida Apache-2.0 litsenziyasi ostida 4-noyabr kuni ochiq kodli chiqarildi. Bu haqidagi maʼlumotlar IT Home nashri tomonidan eʼlon qilindi. Kod FlitAI tashkilotida GitHubda mavjud boʻlib, bu korxonalar va ishlab chiquvchilarga inferens va chiplarni moslashtirish shablonlaridan foydalanish, ularni oʻzgartirish yoki hissa qoʻshish imkonini beradi.
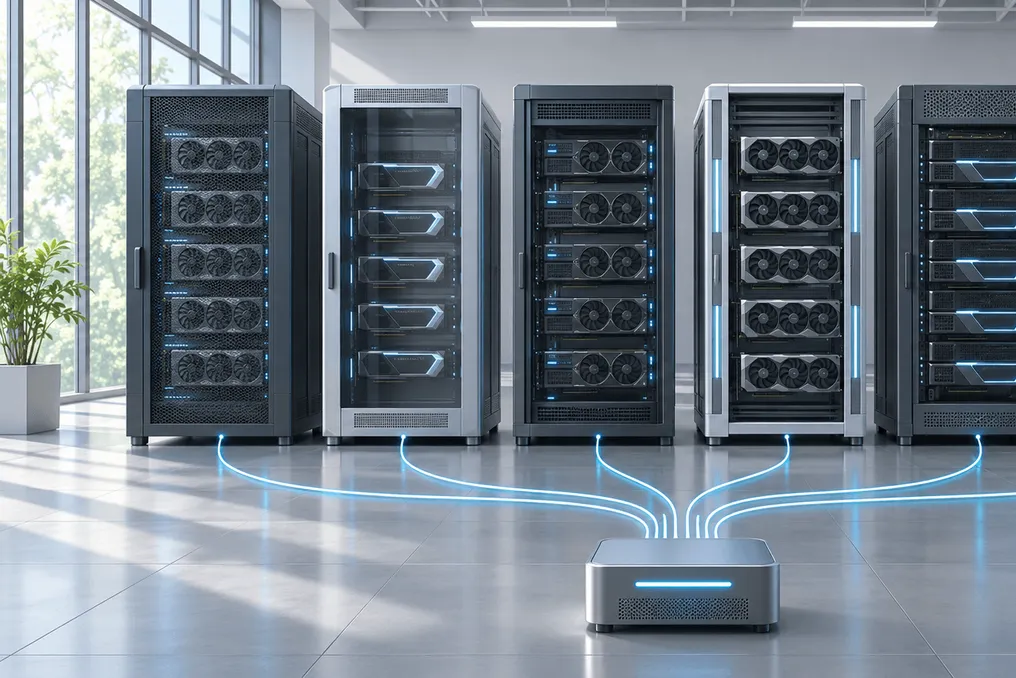
Bu platforma turli ishlab chiqaruvchilar va manbalardan kelgan akseleratorlarni bitta boshqariladigan pul ichiga birlashtiradi. U modellar va apparat taʼminotini moslashtiradi, GPU xotirasi talablarini baholaydi va shundan soʻng, OpenAI bilan mos keladigan API orqali ularga kirishni taʼminlaydigan shablonlardagi modellarini joylashtiradi. Qoʻllab-quvvatlanadigan chiplar orasida NVIDIA va AMD, shuningdek, Huawei Ascend, T-Head PPU va Hygon DCU mavjud.
Bare-metal serverlar, virtual mashinalar va bulutli konteynerlar kompaniyaning oʻz markazlari, xususiy yoki jamoat bulutlarida joylashganligidan qatʼi nazar, bitta klasterda ishlashi mumkin.
Platformaning xususiyatlari va samaradorligi
Ishlab chiquvchilar yechimning ixchamligini alohida taʼkidlaydilar: oʻrnatuvchi 40 MB dan ozgina ogʻir, taxminan 60 soniya ichida bitta buyruq bilan oʻrnatiladi va Kubernetesdan foydalanishni talab qilmaydi. Ichki tarmoqdagi foydalanuvchilar oʻrnatuvchini, model fayllarini va ishga tushirish muhiti tasvirini oflayn rejimda yuklab olishlari mumkin. Katalog 400 ga yaqin modellar uchun mingdan ortiq ishga tushirish konfiguratsiyalarini oʻz ichiga oladi, bunda har bir model va chip kombinatsiyasi uchun tasvir, inferens dvigateli, vazn versiyasi va ishga tushirish bayroqlari paketlanadi.
Sunʼiy intellektga asoslangan ichki yordamchi nosozliklarni diagnostika qilishga yordam beradi, va rejalashtiruvchi joylashtirish boʻyicha qabul qilingan har bir qarorni tushuntiradi. Jamoaning oʻz sinovlariga koʻra, bitta GPUWorks serveri 1003 ta GPU serverini boshqarishi va toʻrt daqiqada 500 dan ortiq inferens replikasini ishga tushirishi mumkin edi. Shu bilan birga, faqat toʻqqizta CPU yadrosi va 1,6 GB xotiradan foydalanib, natija sekundiga 69 000 tokenni yetkazdi. Joylashtirilgan DeepSeek-V4.1-Flash ning uygʻonish vaqti atigi 3,6 soniya davom etdi.
Uygʻonish funksiyasi bir nechta katta modellarining bir xil GPUlardan navbatma-navbat foydalanishiga imkon beradi. Birinchi darajadagi uyqu rejimi model vaznlarini host xotirasida saqlab turadi, bu dvigatelni qayta ishga tushirish yoki vaznlarni omboringizdan qayta yuklash zaruriyatini yoʻq qiladi. Otto karta NVIDIA H20 da oʻtkazilgan sinovda, u yerda uchta katta model barcha sakkiz karta boʻylab taqsimlangan edi, NFS omboridan sovuq ishga tushirish 16 dan 17,5 minutgacha vaqt olgan, ammo xotiradan uygʻonishdan keyin xizmatni tiklash taxminan toʻrtta soniya davom etdi, bu esa taxminan 200 baravar yaxshilanishdir. Administratorlar ustuvorlik siyosatlarini, band boʻlmaganda boʻshatish yoki rejalashtirilgan aylantirishni sozlash imkoniyatiga ega.
Katta yuklar uchun platforma koʻp tugunli parallelizm, koʻp nusxalar va preprocessing hamda dekodlashni ajratishni qoʻllab-quvvatlaydi, bu RDMA tarmoq aloqasini yoki Ascend HCCS kanallarini konfiguratsiya qilish imkonini beradi. Shuningdek, kengaytirishdan oldin quvvat va kechikishni tekshirish uchun ichki yuk sinovlari mavjud. Tizim har bir API kaliti, model va joylashtirish boʻyicha tokenlardan foydalanish va keshga tushishni, shuningdek, million chiqish tokenlari uchun karta soatini va ishlatilmayotgan GPUlarni kuzatib boradi. Tugun texnik xizmat koʻrinishida platforma eskilarini ishdan chiqarishni boshlamasdan replikalarni qoʻshadi va agar mashina ishdan chiqsa, xizmatlarni avtomatik ravishda boshqa mos keladigan tugunda tiklaydi.