SenseTime 9 milliard parametrli sunʼiy intellekt modelini qatlamlarni qayta ishlatish orqali chuqur qayta ishlash uchun chiqardi
Batafsil
TechNode
technode.com

SenseTime 9 milliard parametrli sunʼiy intellekt modelini qatlamlarni qayta ishlatish orqali chuqur qayta ishlash uchun chiqardi

SenseTime kompaniyasi ochiq foydalanish uchun mavjud boʻlgan SenseNova Loop-9B-Preview koʻpmodelli modelni taqdim etdi. Ushbu model tegishli model vaznlarini nusxalash zarurati boʻlmagan holda qayta hisoblash usulidan foydalanib, qayta ishlash chuqurligini oshiradi. Bu chiqarish eʼlon qilingan 30-oktabrda.

Model matn va grafik maʼlumotlarni qabul qila oladi, hujjatlarni tushunish, kod yozish va tashqi vositalardan foydalanish bilan bogʻliq vazifalarni bajarish uchun matn hosil qiladi.

U 24 dekoder qatlami umumiy blokini ikki marta oʻtkazish orqali ishlaydi, bu esa taxminan toʻqqiz milliard parametrga ega asosiy modeldan chuqurroq hisoblash yoʻlini yaratish imkonini beradi.

Hujjatli oʻquv sozlamasi 262 144 token gacha boʻlgan ketma-ketliklarni qoʻllab-quvvatlaydi va matn, tasvir, kod va vositalardan foydalanishni oʻz ichiga olgan misollarni birlashtiradi. SenseTime model vaznlarini, inferens uchun koʻrsatmalar va oʻquv qoʻllanmasini chop etib, loyihani Apache 2.0 litsenziyasi ostida tarqatdi.

Oʻxshash hikoyalar

MemTensor kompaniyasi uzoq hikoyalarni saqlash uchun xotira bilan MemT 1.0 ochiq modelini chiqardi
Batafsil
pandaily.com

MemTensor kompaniyasi uzoq hikoyalarni saqlash uchun xotira bilan MemT 1.0 ochiq modelini chiqardi

Xitoydagi MemTensor kompaniyasi oʻzining xotiraga yoʻnaltirilgan fundamental modellar seriyasini eʼlon qildi va uni jamoatchilikka ochiq qildi, bu MemT 1.0 deb nomlandi. Ushbu seriya ikkita modelni oʻz ichiga oladi: umumiy parametrlar soni 288 milliard boʻlgan va undan 17 milliard faol qoʻllaniladigan MemT-1.0-Flash hamda 36 milliard umumiy parametr va 3 milliard faolga ega MemT-1.0-Nano.

Bu modellar vaznlari Hugging Face platformasida mavjud, tegishli kod esa texnik hisobot bilan birga GitHubʼda joylashtirilgan.

Modellar uzoq suhbatlar bilan bogʻliq keng tarqalgan muammoni hal qilish uchun ishlab chiqilgan. Mavjud tizimlarning aksariyati butun tarixni kontekst oynasida saqlaydi, bu har bir yangi qadam bilan sekinlashish va inferens xarajatlarini oshirishga olib keladi. Buning oʻrniga, MemT modelning oʻziga oʻrganiladigan xotira modulini integratsiya qiladi.

Har bir oʻzaro aloqadan soʻng, model yangi maʼlumotni belgilangan xotira holatiga yozadi va zarur boʻlganda uni chaqiradi, har safar butun oldingi yozuvni qayta oʻqimasdan.

MemTensor kompaniyasi modellar oʻqitilishi 34 milliard token asosida ikki bosqichda oʻtganini maʼlum qiladi: avvalo, model maʼlumotni xotiraga yozishni oʻrgandi, keyin esa ushbu saqlangan maʼlumotdan foydalanib savollarga javob berishni oʻrgandi.

Ishlash natijalari va taqqoslash

Taʼkidlangan barcha ishlash koʻrsatkichlari kompaniyaning oʻz bahosiga asoslangan. MemTensor taʼkidlaydiki, toʻliq kontekst yondashuvi bilan 128 ming tokenli tarixda yakka inferens taxminan 1,86 marta tezroq ishlaydi va 256 ming tokenlarda taxminan 3,99 marta tezroq ishlaydi.

Birinchi token javob berish vaqti xotirali model uchun taxminan 104–112 millisekund, 256K uchun toʻliq kontekstda esa taxminan 445 millisekund deb baholanadi. Bundan tashqari, kompaniya 256K tarixda sessiya davomida xotira holati hajmi taxminan 40 MB ni tashkil etishini taʼkidlaydi, bu toʻliq kontekst keshiga talab qilinadigan 5,06 GB dan sezilarli darajada kamroq, yaʼni taxminan 130 barobar kamayishdir.

MemTensor 11 ta xotira benchmarklarida Flash uchun 50,6 va Nano uchun 47,0 oʻrtacha natijalarini eʼlon qiladi. Bu natijalar modellarini taqqoslanayotgan parametrik xotira usullari orasida birinchi va ikkinchi oʻringa qoʻyadi va soʻrov paytida tarixni chiqarib olishsiz ham, oʻrtacha ravishda qidiruv orqali kengaytirilgan yondashuvlarning natijalariga mos keladi.

Kompaniya shuningdek, xotirani qoʻshish Flash modelining umumiy imkoniyatlarini katta miqdordagi chalgʻituvchi omillar mavjud test sharoitida pasaytirmaganligini taʼkidlaydi.

Dasturchilar litsenziyalash shartlariga eʼtibor berishlari kerak: repozitoriyadagi kod nokommertsiya PolyForm litsenziyasi ostida joylashtirilgan, ammo modellar vaznlari mos ravishda Apache va MIT litsenziyalariga ega.

Jamoa uzoq muddatli xotirani yaxshilash, xotira sigʻimini oshirish va xotirani yangilash xarajatlarini kamaytirish yoʻnalishida yanada rivojlanishni rejalashtirmoqda, uzoq muddatli maqsad sifatida oʻzaro taʼsiri asosida doimiy oʻrganadigan agentlarni yaratishni nazarda tutmoqda.
SenseTime agentli chiqarish uchun Prefill/Decode ajratilgan klasterlarni taqdim etdi
Batafsil
pandaily.com

SenseTime agentli chiqarish uchun Prefill/Decode ajratilgan klasterlarni taqdim etdi

16-oktabrda Shenʼchžendagi CSDI 10-sammitida SenseTime vitse-prezidenti va texnik direktori SenseCore Xuan Shanming kompaniya agentlar davri uchun chiqarish infratuzilmasini qanday qayta qurayotganini tushuntirdi. Ushbu yangi davrda koʻp agentli ish jarayonlari va doimiy nazoratsiz bajariladigan uzoq muddatli vazifalar tufayli tokenlarga boʻlgan talab chat-botlarning imkoniyatlaridan sezilarli darajada oshib ketmoqda.

Taqdimotdagi asosiy eʼtibor markazlashuvni markaziy protsessorlar (CPU)dagi akseleratorlar soniga emas, balki ushbu markazning belgilangan xarajat va xizmat darajasi cheklovlari doirasida yuqori sifatli tokenlarni barqaror ishlab chiqarish qobiliyatiga qaratildi.

SenseCore yechimi Lingangdagi AIDCʼsida joylashgan 10 000 ta GPU miqyosidagi heterogen klasterlar ichida Prefill va Decode (PD) jarayonlarini ajratishga asoslangan. Prefill jarayoni kirish tokenlarini qayta ishlash bilan shugʻullanadi va hisoblash jihatidan intensivdir, shu bois Decode chiqish tokenlarini yaratadi, kontekst keshiga doimiy murojaat qiladi va yuqori xotira uzatish tezligini talab qiladi.

SenseCore arxitekturasida mahalliy akseleratorlar Prefillni bajarishga eʼtibor qaratgan, tepa darajadagi GPUlar esa Decode uchun javobgar boʻladi. Bu bosqichlar bir klaster ichidagi 800G, 400G va 200G uzatish tezligiga ega aralash fabrikalar orqali KV Cache kanallari orqali holat almashinadi.

Bunday ajratish operatsion xavf tugʻdiradi: baʼzi konfiguratsiyalarda oʻrtacha yoki past darajadagi uchdan ellikgacha Prefill tugunlari bitta Decode tuguniga xizmat qilishi mumkin, bu esa Decode tugunining ishdan chiqishi katta guruh Prefill tugunlarini toʻxtatishi mumkinligini anglatadi. Ushbu xavfni minimallashtirish uchun SenseCore Prefill pulidagi yuqori darajadagi kartalarning kichik zaxirasini tezkor almashtirish uchun qoʻllab-quvvatlaydi, shuningdek, tugunlarga yuklanishga qarab Prefill va Decode rollarini dinamik ravishda oʻzgartirish imkonini beradi.

Bunday PD heterogen rejalashtirishni joriy etgandan soʻng, bazaviy konfiguratsiyadagidek shu miqdordagi flagman yuqori samarali GPUlardan foydalanadigan sinov ssenariysida, kompaniya umumiy token uzatish tezligida taxminan besh baravar oshish haqida maʼlumot berdi. Bundan tashqari, kompaniya Prefill ishini mintaqaviy oʻrta darajadagi quvvatlarga, Decode ishini esa yuqori uzatish tezligiga ega masofaviy klasterlarga yoʻnaltirib, kesma-soha PD imkoniyatini oʻrganmoqda.

Bu million tokenli kontekstlar uchun KV Cache hajmi kamayayotgani fonida dolzarb ahamiyat kasb etmoqda — baʼzi modellar uchun u deyarli 100 GB dan taxminan 1 GB gacha qisqarmoqda, shuningdek, Decode jarayoni ichida Attention/FFN ajratilishi tufayli.

SenseCore davoomcha platformasi hozirda kuniga taxminan 6 trillion tokenni qayta ishlayotganini va 2026-yil toʻrtinchi choragacha kuniga 10 trillion tokenga erishishni maqsad qilganini taʼkidlaydi, shu bilan birga, yil davomida umumiy token hajmining taxminan 25 barobar oʻsishi prognoz qilinmoqda. Shuni taʼkidlash kerakki, bu uzatish tezligi va tezlik oshishi koʻrsatkichlari kompaniyaning bayonotlaridir. Nutqda mahalliy chiplar Decode uchun ishlatiladigan yuqori samarali GPUlarni toʻliq almashtirish oʻrniga, Prefill va aralash chiqarish vazifalarida katta ulush egallashga moʻljallanganligi taʼkidlandi.

VAST kompaniyasi oddiy oʻyin kadrlarini batafsil videoga renderlash uchun EdenLive ochiq modelini chiqardi
Batafsil
pandaily.com

VAST kompaniyasi oddiy oʻyin kadrlarini batafsil videoga renderlash uchun EdenLive ochiq modelini chiqardi

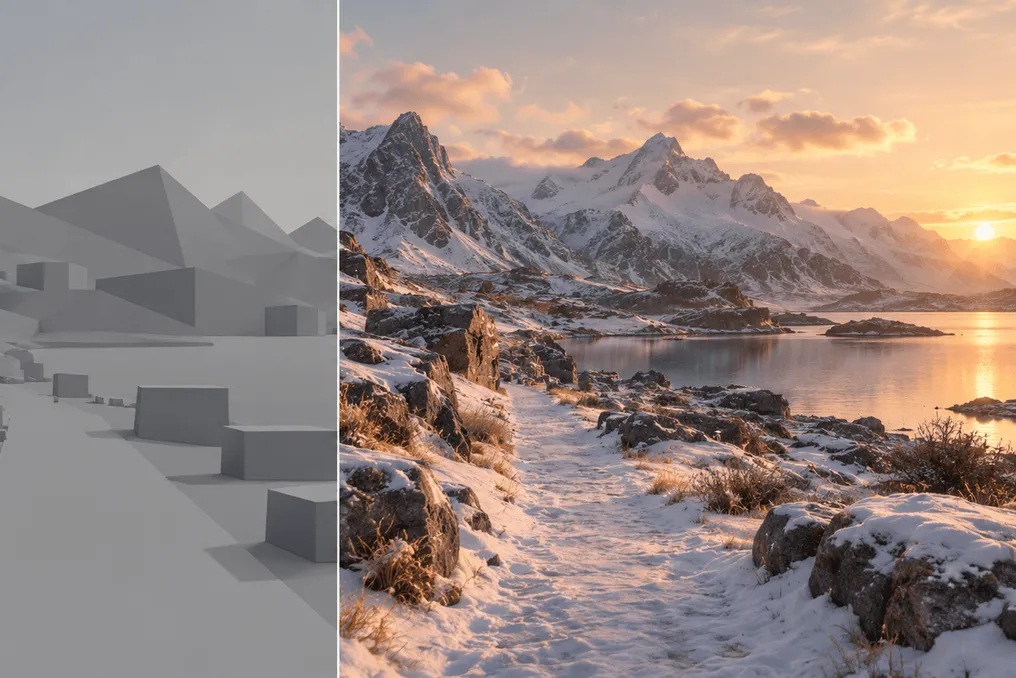
Tripo platformasining yaratuvchisi boʻlgan va 3D sohasidagi generativ AI ga ixtisoslashgan VAST kompaniyasi EdenLive modelini jamoatchilikka ochiq qildi. Ushbu model real vaqt rejimida ishlaydi va soddalashtirilgan oʻyin kadrlarini yoki mavjud videoni olib, ularni fotorealistikdan animega qadar oʻzgarishi mumkin boʻlgan tanlangan uslubdagi batafsil tasvirlarga uzluksiz qayta chizishga qodir.

Chiqarish 5B va 14B hajmdagi modellar vaznlarini, real vaqtda inferens uchun kodni, texnik hisobotni va toʻliq foydalanish namunalarini oʻz ichiga oladi. Muhim jihati shundaki, EdenLive dunyoni mustaqil simulyatsiya qilmaydi; buning oʻrniga, yuqori darajadagi dastur, masalan, oʻyin dvigateli yoki kodlash agenti tomonidan yozilgan kod, qoidalarqa rioya qilish, dunyo holatini kuzatish va xom referans videoni chiqarish uchun javob beradi.

Bu referans video olingandan soʻng, EdenLive belgilangan birinchi kadr va matnli soʻrov asosida renderlashni amalga oshiradi. VAST taʼkidlashicha, bunday ajratish oʻyin mantiqini aniq va sinovdan oʻtkazish uchun mos holatda saqlashga imkon beradi, shu bilan birga real vaqt rejimidagi modelning cheklangan imkoniyatlarini faqat tashqi koʻrinishga yoʻnaltirish mumkin.

Bu yondashuv avvalgi iyul oyida Eden Loyihasi deb nomlangan kengroq dunyo tadqiqoti doirasida taqdim etilgan. VAST bayonotlariga koʻra, 5B model 720p aniqlikda bitta Nvidia RTX 5090 video kartasida sekundiga 24 dan yuqori frekatsiyada ishlashga qodir. GitHubdagi README faylida bu raqam LightX2V inferens freymvorkidan foydalangan holda 1280x704 piksel aniqligida taxminan 24.7 FPS sifatida koʻrsatilgan.

Texnik hisobot bir H100 da shu aniqlikda 29.8 FPS, shuningdek, sakkizta H100 da 14B modeli 832x480 aniqlikda 26.8 FPS ni koʻrsatishini bildiradi. VAST foydalanuvchi kiritmasidan tegishli kadrgacha boʻlgan umumiy kechikish bir necha yuz millisekundni tashkil qilishini va tizimning kontentni bir necha daqiqa davomida uzluksiz yaratishini taʼkidlaydi.

Ikkala model ham Wan2.2-TI2V-5B va Wan2.1-I2V-14B video modellariga asoslangan. Inferens kodi va difuziya, VAE va dekoderning asosiy vaznlari Apache 2.0 litsenziyasi ostida tarqatiladi, ammo barcha komponentlar bunday litsenziyaga ega emas. Vizual enkoder DINOv3 litsenziyasidan foydalanadi, va soʻrovdan oʻyin maydoniga qadar ishchi muhitda qoʻllaniladigan tasvir modeli Kommersiya qilinmaydigan FLUX litsenziyasi ostida joylashgan, bu esa ushbu ishchi muhitdan tijoriy maqsadlarda foydalanishni cheklaydi.

VAST shuningdek, matnli soʻrovni xom oʻynaladigan oʻyinlarga aylantiradigan va keyin EdenLive tomonidan renderlanishi mumkin boʻlgan Game Prototype Turbo — mahoratni taqdim etdi. VAST namunalari platformer, bunda personaj lava ni toʻxtatib, tayanch nuqtalarini yaratadi, sogʻliq vaqtlari va raund vaqti yuqori darajadagi tizim tomonidan kuzatiladigan ikki oʻyinchi jangovar oʻyini, shuningdek, koʻk fon ustida suratga olingan odamni multfilm personajiga aylantiruvchi video renderlashni oʻz ichiga oladi. Bundan tashqari, model birinchi shaxs kadrlari boʻyicha inson qoʻllarini robot qoʻllar bilan almashtirib, jismoniy AI uchun qoʻshimcha oʻquv maʼlumotlarini yaratadi.

VAST taʼkidlashicha, hozirda EdenLive sahnalarni koʻrib chiqish va qutilarni itarish jumboqlar kabi past chastotali oʻzaro aloqalar uchun eng yaxshi mos keladi. Tez, intensiv oʻyin rejimi, bir nechta personajlarning uygʻunligini saqlash, kichik obʼektlar ustidan nozik nazorat va uzoq sessiyalardagi vizual barqarorlik hali ham takomillashtirilishi kerak.

Mashhur