Pesquisadores afirmam que o funcionamento interno da IA pode ser mais compreensível do que se pensava anteriormente
Leia mais
TechCentral
techcentral.co.za

Pesquisadores afirmam que o funcionamento interno da IA pode ser mais compreensível do que se pensava anteriormente

Surgiu a alegação de que os modelos de inteligência artificial são muito mais fáceis de entender do que os pesquisadores imaginavam, o que atraiu atenção significativa na área de segurança da IA. No entanto, acadêmicos da África do Sul alertam que essas conclusões ainda não foram verificadas nem revisadas por pares.

Nick Kammarata, pesquisador da startup Goodfire, que trabalhou anteriormente na OpenAI, apresenta essa hipótese em seu documento intitulado 'ensaio de pesquisa informal e hipótese de trabalho'. Ele afirma que 'a evidência canônica de polissemia e superposição que convenceu a maior parte da comunidade científica, incluindo eu, sobre o empacotamento arbitrário de conceitos em redes, foi mal interpretada.'

Ele explicou à MIT Technology Review: 'Nós estávamos olhando para isso de forma errada.' Steven Boyke Sidley, professor convidado da Universidade Rhodes, acredita que a natureza da 'caixa preta' da IA, que nem mesmo seus criadores conseguem decifrar, está na base de muitas preocupações sobre ela.

Sidley observou que 'isso causava preocupação porque se você não consegue entender como a IA pensa, como você pode impedir que ela cometa atos ruins, como incitar alguém ao suicídio? Essa é a essência do que se chama alinhamento de IA'. Ele acrescentou que 'o artigo de Kammarata sugere que dentro da rede neural da IA não há tal complexidade — nós simplesmente olhamos através de uma lente incorreta. Seus resultados parciais e (ainda) não verificados são promissores, pois dão esperança de que possamos tornar a IA uma ferramenta subordinada, em vez de uma criança descontrolada e indomável como é agora.'

Gatos, carros e a letra V

O ensaio examina um exemplo conhecido no campo da interpretabilidade — uma disciplina cujo objetivo é descobrir os processos que ocorrem dentro dos modelos de IA. No modelo de reconhecimento de imagens Google Inception v1 de 2014, o neurônio 4e:55, ativado ao detectar um determinado traço, reagia tanto a gatos quanto a carros.

No trabalho 'Zoom in' de 2020, no qual Kammarata colaborou sob a liderança de Chris Olah, atual chefe de pesquisa em interpretabilidade na Anthropic, este neurônio era considerado um exemplo clássico de mistura de conceitos não relacionados. No entanto, Kammarata agora afirma que eles estão ligados pela forma geral da letra V: o perfil pontiagudo de um gato e a parte dianteira de um carro vista em ângulo. O mesmo neurônio dispara também em um canto de bilhar de mesa e no nariz de um trem de alta velocidade, enquanto formas redondas provocam uma reação inversa.

Uma atualização do ensaio de 30 de outubro enfatiza que o neurônio ainda reconhece gatos e carros, sendo a forma V a característica geral. Kammarata informou à MIT Technology Review que levou apenas cinco segundos para estudar o modelo em que estava trabalhando, que 'provavelmente levou milhares de horas'.

Ele acredita que, se a maioria dos neurônios desempenha uma função principal, os pesquisadores poderão analisar os modelos sem recorrer ao pré-treinamento de um segundo modelo para decifrá-los. Testes preliminares do modelo Qwen3-32B da Alibaba mostram que cerca de 90% das 'polaridades neuronais' — extremidades positivas e negativas da atividade do neurônio — têm uma tarefa principal; cerca de 7% realizam duas tarefas relacionadas, e 2-4% ainda não foram estudados, embora esses números dependam dos limiares. Além disso, o projeto que ele iniciou na OpenAI em 2023 descobriu que apenas cerca de 1,7% dos neurônios podem ser interpretados 'na nossa avaliação mais generosa.'

Ainda não passou por revisão

O Professor Benjamin Rosman, fundador do Institute of Mind da University of Witwatersrand, incluído na lista dos 100 indivíduos mais influentes em IA da revista Time em 2025, chamou isso de 'um desenvolvimento interessante e potencialmente muito encorajador para a segurança da IA'. No entanto, ele enfatizou: 'a pesquisa ainda não foi revisada por pares, e é muito cedo para tirar conclusões fortes sobre o que isso significa para a segurança da IA.'

Outros expressam maior ceticismo. Neil Nanda do Google DeepMind escreveu no X que 'este é um trabalho interessante, mas não acho que seja uma atualização significativa do quadro geral de interpretabilidade'. Jacob Hilton do Centro de Pesquisa de Alinhamento acrescentou: 'Para uma compreensão completa, precisamos ir além dos neurônios e explicar como eles se conectam, formando cadeias.'

Rosman concluiu que 'mesmo que nos tornemos muito melhores em entender como esses sistemas funcionam, isso não significa necessariamente que sabemos como fazê-los se comportar de forma segura.'
Histórias semelhantes

Modelo de IA da OpenAI resolveu o problema de Navier-Stokes e apresentou pesquisas em problemas matemáticos
Leia mais
cgtn.com

Modelo de IA da OpenAI resolveu o problema de Navier-Stokes e apresentou pesquisas em problemas matemáticos

A OpenAI anunciou recentemente que seu modelo de inteligência artificial conseguiu resolver o problema de Navier-Stokes, que causou dificuldades aos matemáticos por quase um século.

Além disso, os desenvolvedores lançaram 722 manuscritos detalhando o progresso na resolução de 372 problemas matemáticos.

Estas descobertas causaram espanto entre os matemáticos, que agora questionam como isso afetará não apenas seu trabalho atual, mas também o futuro de toda a sua profissão.

Vignesh Subrahmaniam da Intuit discute a transição do engenharia de prompts para a criação de sistemas de inteligência artificial funcionais
Leia mais
yourstory.com

Vignesh Subrahmaniam da Intuit discute a transição do engenharia de prompts para a criação de sistemas de inteligência artificial funcionais

Nos últimos anos, a melhoria dos resultados com IA dependeu da capacidade de escrever solicitações (prompts) de maior qualidade. No entanto, essa paradigma está mudando rapidamente, à medida que os sistemas de IA começam a raciocinar, tomar decisões e executar ações dentro de fluxos de trabalho inteiros de forma autônoma.

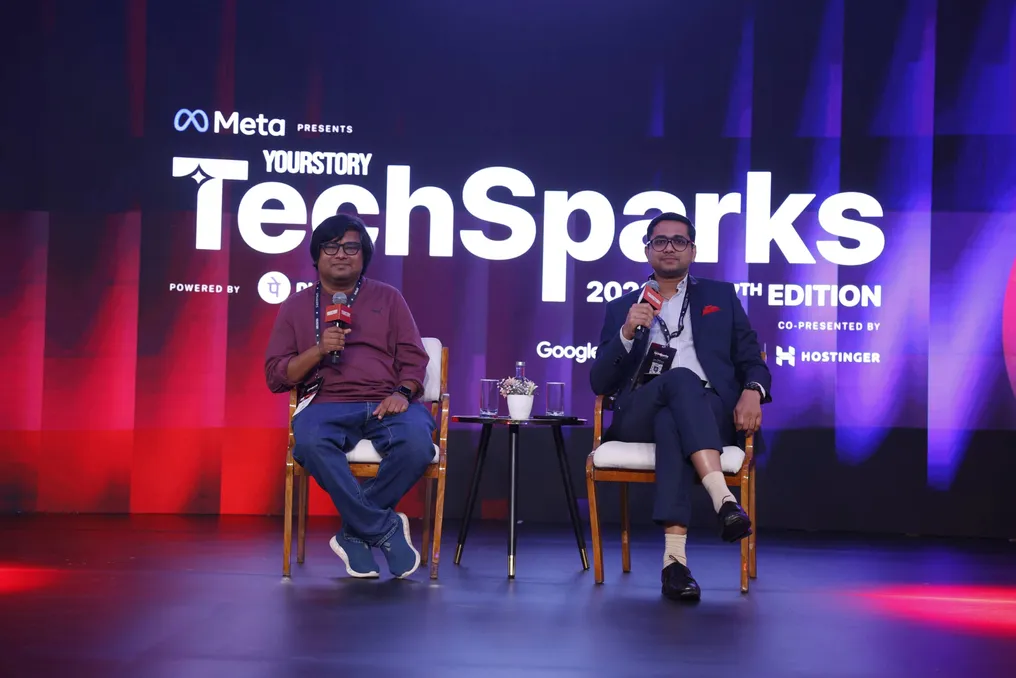
No evento TechSparks 2026, o principal evento da YourStory, o Dr. Vignesh Subrahmaniam, pesquisador sênior de IA na Intuit, conduziu uma conversa com Aditya Charlie, editor-chefe da YourStory e The CapTable. A discussão, intitulada «Além do Prompt: Criando IA que Pensa, Age e Aprende», abordou o que os desenvolvedores precisam repensar à medida que a inteligência se torna cada vez mais autônoma.

A sessão começou com perguntas sobre o dia de trabalho típico de Subrahmaniam e um pedido para simplificar os conceitos de fintech e IA para o público. Ele usou uma analogia com xadrez, perguntando: se um algoritmo não for ensinado as regras do xadrez, mas sim mostrado um milhão de partidas concluídas com vencedores, ele será capaz de deduzir tanto as regras quanto as estratégias mais prováveis para vencer?

A equipe da Intuit aplica uma abordagem semelhante para apoiar pequenas empresas, pois a empresa atende tanto consumidores quanto contadores. Subrahmaniam observou: «Assim como estudamos o jogo dos negócios, analisando dados, ações reais e resultados que as empresas tomam». O objetivo é entender os fatores que levam ao sucesso empresarial na aquisição de clientes, crescimento rápido e melhoria do fluxo de caixa.

Em seguida, a conversa passou para a mudança de paradigma para os desenvolvedores: de estudar por muitos anos a escrita de prompts mais inteligentes para projetar agentes que têm um objetivo e determinam os passos para alcançá-lo. Subrahmaniam comparou a engenharia de prompts com a longa história das linguagens de programação, desde o código binário e assembly até Fortran, C e Python. Os grandes modelos de linguagem permitiram que qualquer pessoa programasse em inglês simples, mas este método tem suas limitações.

Os pesquisadores rapidamente perceberam que a inteligência não deveria residir apenas no modelo. O modelo deve atuar como um orquestrador, dividindo uma tarefa complexa em uma sequência de ações e chamadas de ferramentas. A inteligência real move-se para as ferramentas que são chamadas; e essas ferramentas também devem ser projetadas de forma diferente: «não para que um humano, ou um desenvolvedor de software, ou qualquer outra pessoa possa usá-las, mas de modo que o orquestrador LLM possa realmente usá-las».

Isso exige a criação de ferramentas de alta precisão com resultados extremamente determinísticos. Para os desenvolvedores, a maestria muda de formulações espirituosas para componentes confiáveis que o modelo pode chamar repetidamente sem surpresas.

Sobre fontes de novos dados, Subrahmaniam declarou abertamente que o treinamento em dados textuais está em grande parte resolvido. O desafio mais complexo é treinar em fontes multimodais e ações reais. Ele deu o exemplo de como uma criança pequena aprende principalmente através do que vê, ouve e observa, e não através da leitura, afirmando que incluir tais sinais do mundo real nos sistemas de IA ajudará os modelos a ir além da geração de texto e começar a sugerir ações. Ele chamou isso de próximo marco.

Ao considerar os problemas de setores regulamentados, ele levou o público de volta a 18 anos atrás, a um dos primeiros laboratórios de aprendizado de máquina em Bangalore, onde trabalhou com regressão logística e perceptrons multicamadas. Naquela época, o maior problema não era o próprio algoritmo. Ele lembrou: «Na verdade, era a qualidade dos dados».

Este problema não mudou. Independentemente de a equipe estar treinando regressão simples ou ajustando um transformador, o princípio de «lixo na entrada, lixo na saída» permanece válido. Segundo ele, as empresas capazes de coletar, agregar e armazenar dados da mais alta qualidade obterão vantagem.

Durante uma breve sessão de perguntas e respostas, um participante perguntou como as restrições de armazenamento de dados financeiros afetam o trabalho da Intuit. Subrahmaniam nomeou o consentimento como a base de qualquer sistema de treinamento e citou um estudo de Framingham, onde os residentes da cidade de Massachusetts permitiram que os médicos monitorassem sua saúde ao longo do tempo, o que moldou a compreensão moderna de doenças cardiovasculares. Ele acrescentou que as empresas também são obrigadas a explicar ao público em geral os benefícios do uso de dados.

À medida que a conversa terminava, a ideia central foi que, à medida que a IA passa de reativa para proativa, os fundamentos se tornam mais importantes do que a interface. Os prompts permanecerão sendo o ponto de partida, mas o verdadeiro trabalho agora reside na criação de ferramentas confiáveis que os agentes podem chamar, no fornecimento de dados de alta qualidade aos sistemas e na obtenção do consentimento que lhes permite aprender. É aqui, além do prompt, que a próxima onda de IA será ganha pelos desenvolvedores.

Popular