Equipe MNN da Taobao lança modelo MNN-Pocket-0.3B de 173 MB para rodar em dispositivos
Leia mais
Pandaily
pandaily.com

Equipe MNN da Taobao lança modelo MNN-Pocket-0.3B de 173 MB para rodar em dispositivos

A equipe MNN da Taobao lançou publicamente o modelo MNN-Pocket-0.3B. Este modelo de linguagem, que contém cerca de 300 milhões de parâmetros, foi desenvolvido para funcionar diretamente dentro de aplicativos móveis. De acordo com um comunicado do IT Home em 6 de novembro, o modelo é construído na base do motor de inferência MNN e é destinado a grandes aplicativos de serviço e comércio universais, como o Taobao, onde os recursos computacionais, de memória e de bateria limitados no dispositivo devem ser distribuídos entre múltiplas funções.

A equipe estabeleceu quatro objetivos principais para seu modelo, que chamaram de modelo grande nativo de aplicativo. Esses objetivos incluíam atingir uma velocidade de decodificação superior a 200 tokens por segundo em certos dispositivos. O consumo de memória de pico deve permanecer abaixo de 300 MB, deixando uma margem dentro do orçamento total do modelo de cerca de 500 MB para crescimento de contexto e sobrecargas de integração. Além disso, um processo típico de inferência não deve consumir mais de um décimo de porcento da carga da bateria de um telefone padrão, o que significa que 100 execuções custarão menos de 1%. Finalmente, ao executar as tarefas de negócios definidas, o modelo deve demonstrar resultados comparáveis aos modelos da classe 8B.

Testes mostraram que o MNN-Pocket-0.3B funciona totalmente offline no iPhone 18 Pro usando o motor MNN, alcançando uma velocidade média de decodificação de cerca de 350 tokens por segundo. O pacote de implantação INT4, que inclui pesos, tokenizador, grafo de computação e configuração de inferência, tem um tamanho de 173 MB. No iPad Pro com chip M5 e usando o backend Metal, a equipe registrou uma velocidade de decodificação de 466 tokens por segundo e uma velocidade de preenchimento de 8721 tokens por segundo, com a memória de pico aumentando em 228 MB em relação à linha de base. No telefone Snapdragon 8 Gen 5 usando o backend da CPU, foram registrados 251 tokens por segundo, e o custo adicional de energia para 100 execuções no OnePlus 13 foi de cerca de 0,3% da carga da bateria.

O modelo foi treinado do zero, com foco especial nos idiomas chinês e inglês. Após testar configurações densas na faixa de 50 milhões a 1,3 bilhão de parâmetros, a equipe determinou que o tamanho de cerca de 300 milhões era o maior que satisfazia simultaneamente os requisitos de memória e velocidade. Foi decidida a utilização de 28 camadas com atenção de consulta agrupada (grouped-query attention), pois a transição para 36 camadas não aumentou as métricas médias, mas retardou a decodificação. O vocabulário foi reduzido de aproximadamente 151.000 tokens do tokenizador Qwen3 para 64.000, o que permitiu reduzir os custos de embeddings e camada de saída.

A equipe relata um nível IFEval de 73,20, IFEval chinês de 74,59 e uma média de 50,00 em 11 benchmarks chineses e em inglês, superando modelos de tamanho semelhante e maiores, incluindo o Qwen3-0.6B. Na ficha do modelo, observa-se que, assim como outros modelos com menos de um bilhão de parâmetros, ele não é recomendado para tarefas matemáticas complexas ou geração de código em horizontes longos.

As opções publicadas no Hugging Face incluem o modelo base para pré-treinamento contínuo, um ponto de verificação de ajuste fino supervisionado, um modelo com ajuste de instruções, um build GGUF, um build MNN INT4 e um modelo com cabeça de decisão para seleção entre candidatos. O lançamento também contém um rascunho do modelo de decodificação especulativa DFlash2, que, segundo a equipe, é capaz de dobrar a taxa de transferência de decodificação em certas tarefas.
Histórias semelhantes

Lenovo lança host de IA Kaitian com processador Zhaoxin KX-7000 e NPU Houmo LQ50 para execução local de modelos de 35B
Leia mais
pandaily.com

Lenovo lança host de IA Kaitian com processador Zhaoxin KX-7000 e NPU Houmo LQ50 para execução local de modelos de 35B

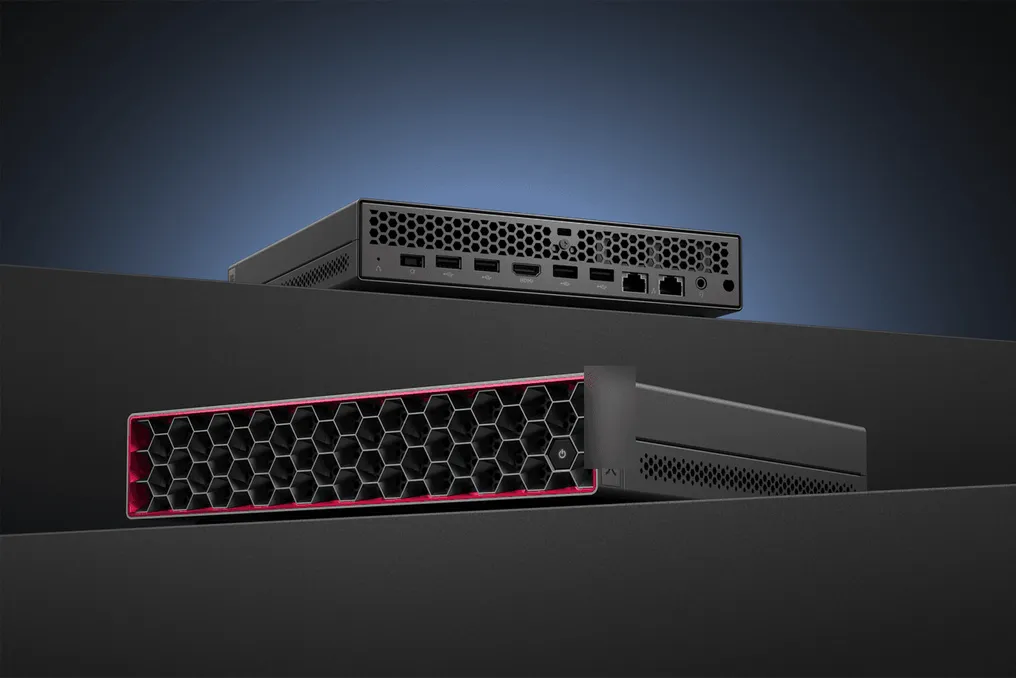
A Lenovo lançou o primeiro sistema host de IA da linha Kaitian, destinado ao mercado chinês de inovação em TI (Xinchuang). Este computador de mesa de 1,6 litros combina o processador Zhaoxin com a NPU de IA da Houmo, permitindo a execução local de modelos com cerca de 35 bilhões de parâmetros.

O dispositivo é equipado com um processador Zhaoxin KX-7000 de oito núcleos e a NPU Houmo Liqing LQ50. Na configuração padrão, o sistema oferece uma capacidade de computação de 160 TOPS no formato INT8, e com a opção NPU, essa capacidade pode atingir 320 TOPS. A NPU possui 24 GB de memória dedicada com largura de banda de 153,6 GB/s. O host opera sob o Kylin OS e vem pré-instalado com o agente Tianxi AI Pro da Lenovo.

A empresa realizou testes do dispositivo usando modelos abertos, incluindo as séries Qwen3.5 e Qwen3.6-35B-A3B. Ao usar os 24 GB da NPU e quantização W4A8, o modelo Qwen3.6-35B-A3B gerou texto a uma velocidade de aproximadamente 28,99 tokens por segundo durante a inferência local. O sistema suporta entrada de dados de até 200.000 tokens para processamento de documentos longos e tarefas multi-turn. A plataforma Houmo fornece aos desenvolvedores ferramentas para perfilagem, compilação, gerenciamento de tempo de execução e quantização de modelos.

A Lenovo posiciona este host como um funcionário digital permanente, projetado para operação 24 horas por dia. Isso permite que os agentes executem tarefas agendadas, como pesquisa de conhecimento local, elaboração de documentos e sumarização de informações, enquanto o processamento das saídas ocorre diretamente no dispositivo, e não através de tokens na nuvem, mantendo os dados localmente. No evento, os testadores do Tianxi AI Pro deram uma instrução para verificar o aplicativo de operadora móvel, e o dispositivo realizou uma chamada de teste, mediu o atraso do código SMS de verificação e forneceu um relatório.

Em relação à dissipação de calor, o processador e a NPU possuem canais de ar separados atrás do painel frontal hexagonal com ventiladores de alta pressão. A Lenovo relata que em marcha lenta, a temperatura da carcaça é de cerca de 33 graus Celsius em uma sala com temperatura de 25 graus, e sob carga total, atinge 41 graus. Em uma sala com temperatura de 35 graus, sob carga total, a temperatura atinge cerca de 46 graus. O nível de ruído é de 19,4 dB em modo de espera e cerca de 29,5 dB durante a inferência total da NPU. O dispositivo pesa cerca de 1,5 kg e é equipado com duas portas independentes de 2,5GbE.

Vale notar que o host Kaitian difere do Lenovo AI Host P7, que foi apresentado em outubro com chips Houmo M50 e CIX P1.

Xiaomi lança modelo Xiaomi-OCR-0 com 0,8 bilhão de parâmetros que lidera na classe OmniDocBench
Leia mais
pandaily.com

Xiaomi lança modelo Xiaomi-OCR-0 com 0,8 bilhão de parâmetros que lidera na classe OmniDocBench

A Xiaomi anunciou o lançamento do modelo Xiaomi-OCR-0, um modelo leve para compreensão de documentos. Os pesos e o código para inferência deste modelo estão disponíveis nas plataformas Hugging Face e GitHub, conforme relatado pela empresa em 30 de outubro.

O modelo possui 0,8 bilhão de parâmetros e foi projetado para executar três tipos de tarefas dentro de um único sistema: análise de documentos, extração de informações chave e respostas a perguntas visuais por OCR.

A funcionalidade de análise inclui o reconhecimento de texto principal, tabelas e fórmulas matemáticas, fornecendo resultados estruturados na ordem de leitura com suporte a formatos nativos Markdown e LaTeX. Para a extração de informações chave, o modelo foca em faturas, recibos, documentos de identidade e formulários comerciais, encontrando campos solicitados e fornecendo o resultado em formato JSON para fluxos de trabalho automatizados.

As respostas a perguntas visuais vão além da simples transcrição, permitindo a pesquisa entre regiões, cálculos numéricos e raciocínio baseado em documentos e gráficos.

Metodologia de Treinamento e Ajuste

A Xiaomi afirma que o modelo é construído com base no modelo Qwen3.5-0.8B-Base e foi treinado com aproximadamente 170 milhões de amostras de OCR e documentos. Os rótulos dos dados foram filtrados através do consenso de vários modelos de OCR especializados, que realizaram verificações mútuas e votaram sobre áreas de texto, tabelas e fórmulas.

Ao trabalhar com tabelas e fórmulas complexas, a equipe utilizou um ciclo de 'previsão, renderização novamente e comparação': os resultados candidatos eram renderizados de volta em imagens e comparados com o original em nível de pixel e estrutura para detectar linhas deslocadas ou caracteres ausentes. Casos sintéticos complexos incluíram texto multilíngue, caligrafia histórica, efeito moiré de tela e iluminação distorcida.

O processo de treinamento ocorreu em três fases: primeiro, fixação textual para alinhar áreas visuais com tokens de texto; em seguida, pré-treinamento contínuo de OCR em dezenas de bilhões de tokens; e, finalmente, aprendizado por reforço para tarefas mistas com recompensas verificáveis, como distância de edição estrutural e pontuações de correspondência de tabela.

Resultados de Teste

No benchmark OmniDocBench v1.6, o modelo obteve uma pontuação de 96,83, ficando em segundo lugar no geral, apenas 0,04 pontos atrás do líder, e tornando-se o primeiro entre os modelos com menos de um bilhão de parâmetros. No teste Real5-OmniDocBench, que simula digitalizações, papel amassado, capturas de tela, mudanças de iluminação e quadros inclinados, o modelo alcançou 95,24 pontos. As métricas no Wild-OmniDocBench foram de 87,94.

O modelo atinge 97,84 no teste de referência de fórmulas UniMER-Test e 92,27 no PubTabNet para avaliação de estrutura de tabelas. Ao calcular a média dos resultados em DocVQA, InfoVQA, ChartQA, OCRBench e TextVQA, ele obtém 83,2 pontos, superando o HunyuanOCR-1.5 com 76,5 e o 8B MiniCPM-V-4.5 com 82,6, embora fique atrás do Qwen3.5-4B com 84,9. Deve-se notar que todos os números apresentados são dados próprios da Xiaomi.

A Xiaomi informa que esta tecnologia já está integrada ao assistente Super XiaoAi em seus telefones, onde é capaz de extrair códigos de resgate, números de fila, detalhes de contas e horários de reuniões diretamente da tela. Além dos pesos do modelo, a Xiaomi fornece aos desenvolvedores uma versão de demonstração no navegador, o serviço MCP e um conjunto de ferramentas Agent Skill.

A empresa 01.AI Kai-Fu Lee recebeu investimentos estatais de Hangzhou na casa de centenas de milhões de yuans
Leia mais
technode.com

A empresa 01.AI Kai-Fu Lee recebeu investimentos estatais de Hangzhou na casa de centenas de milhões de yuans

A 01.AI, fundada por Kai-Fu Lee, atraiu investimentos na casa de centenas de milhões de yuans de investidores estatais em Hangzhou e na área de Linping desta cidade. Este acordo foi anunciado em 30 de outubro, dois dias após ser assinado.

De acordo com os termos do negócio, a 01.AI planeia estabelecer sua sede em Linping e criar uma base para auxiliar empresas na implementação de inteligência artificial. Esses fundos são destinados a apoiar a crescente orientação da empresa para aplicações corporativas e sistemas especializados de IA para setores específicos.

A empresa está gradualmente abandonando serviços voltados para consumidores finais, passando para soluções de IA corporativa. Em setembro, a plataforma de modelos públicos parou de oferecer versões de teste de modelos e serviços de API. Lee declarou que agora a empresa adapta modelos abertos chineses, como DeepSeek, Qwen e GLM, para clientes empresariais, sendo que cerca de metade de sua receita provém de fora da China.

Popular