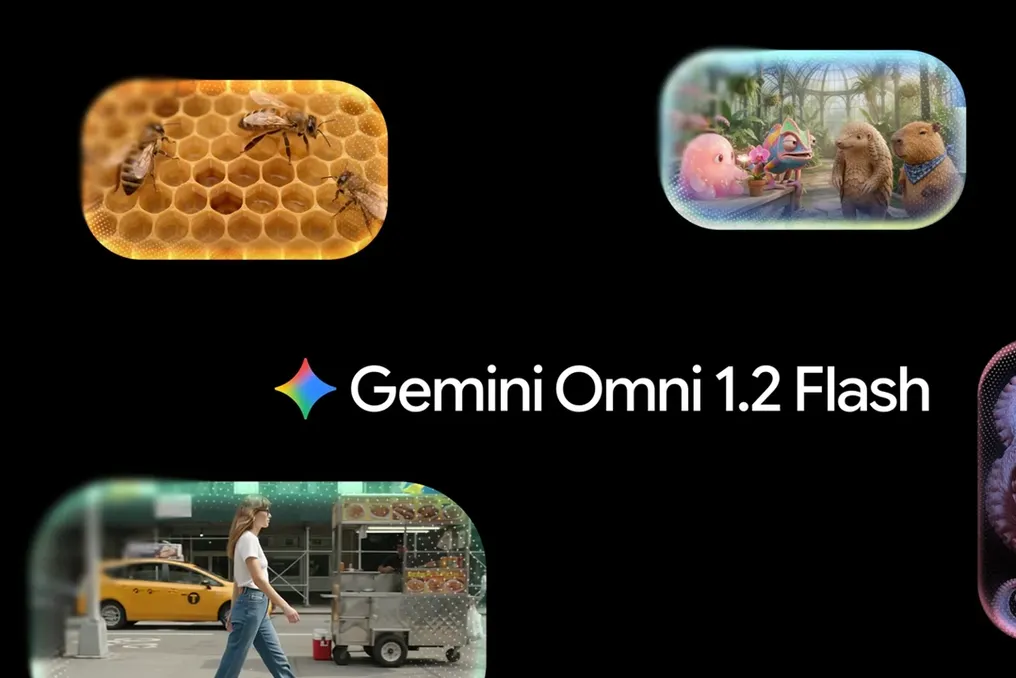
Google lança Gemini Omni 1.2 Flash para criação de vídeos de até 15 segundos
Leia mais
Tecnoblog
tecnoblog.net

Google lança Gemini Omni 1.2 Flash para criação de vídeos de até 15 segundos

O Google divulgou o Gemini Omni 1.2 Flash, sua mais recente versão de modelo de inteligência artificial dedicada à geração e edição de vídeos. Esta atualização se destaca pela capacidade de produzir clipes com duração máxima de 15 segundos, apresentando maior qualidade e uniformidade.

Embora 15 segundos possa parecer um período breve, o Gemini Omni 1.2 Flash foi desenvolvido especificamente para a produção de conteúdo audiovisual curto. Este lançamento representa um avanço significativo em relação à versão anterior, a 1.1, que limitava a criação de vídeos a até 10 segundos.

Adicionalmente, o Google informou que o novo modelo possibilita ao usuário especificar a duração do vídeo em incrementos de um segundo. Isso elimina a necessidade de se restringir a tempos pré-determinados, como 5, 10 ou 15 segundos, permitindo escolhas como 4, 7 ou 8 segundos, sendo que o tempo mínimo estabelecido é de 3 segundos.

Outro ponto enfatizado pelo Google é que o Gemini Omni 1.2 Flash produz resultados mais coesos, mantendo as características de pessoas, objetos ou cenários, o que diminui a probabilidade de surgirem 'aberrações' no vídeo.

O modelo de IA também foi aprimorado para gerar diálogos mais naturais, oferecendo melhor sincronização labial e uma distinção mais clara entre diferentes vozes. Os recursos de movimentação de câmera foram refinados, incluindo opções para aproximar, afastar ou mover a câmera ao redor de elementos específicos.

Para otimizar o fluxo de trabalho e reduzir custos, o Gemini Omni 1.2 Flash aceita comandos via voz ou texto para modificar diversos aspectos do vídeo, como o plano de fundo, os efeitos de iluminação ou o formato da tela, sem exigir refazer todo o processo a cada alteração.

Para auxiliar no acompanhamento dos resultados e na economia, o modelo permite a criação de rascunhos em resoluções de 360p ou 720p. Caso o resultado seja satisfatório, o vídeo final pode ser exportado em 1080p ou 4K, conforme a necessidade.

Em relação aos custos, o Google ressaltou uma redução de 30% no preço de um vídeo em 720p, o que equivale a US$ 0,07 por segundo.

Por ser um modelo, o Gemini Omni 1.2 Flash está sendo implementado em diversas plataformas de IA do Google, com disponibilidade distribuída nos seus serviços.
Histórias semelhantes

Sistema openJiuwen da Huawei fornece memória de vídeo baseada em eventos para agentes, reduzindo o tempo de resposta em até 97%
Leia mais
pandaily.com

Sistema openJiuwen da Huawei fornece memória de vídeo baseada em eventos para agentes, reduzindo o tempo de resposta em até 97%

openJiuwen, um framework de código aberto suportado pela Huawei, lançou o OmniMem-Lens — uma função de memória multimodal na versão 0.2.0 do seu módulo AgentMemory. Esta função permite que agentes de IA memorizem vídeos longos com base em eventos reais, e não em intervalos de tempo fixos, conforme relatado pela QbitAI em 4 de novembro.

A equipe afirma que a abordagem padrão, que consiste em dividir vídeos longos em segmentos de um minuto e armazenar cada um separadamente, prejudica a memória do agente de duas maneiras. Quando uma cena contínua é dividida entre janelas, o agente recebe apenas metade das evidências, o que contribui para alucinações. Além disso, alguns segundos de ação chave misturados com minutos de material irrelevante podem se perder no ruído, diminuindo a precisão da busca.

A maioria dos métodos de segmentação de eventos também depende apenas de um tipo de dado, fazendo com que ignorem mudanças de tópico se a imagem permanecer estática ou mudanças de cena se ninguém estiver falando. O OmniMem-Lens rastreia ambos os fluxos: o trilho visual marca as mudanças de cena, e o trilho de áudio usa reconhecimento de fala para determinar a mudança de tópico pelo falante, mesmo que a tela não tenha mudado. A verificação cruzada dessas duas fontes permite fazer cortes exatamente nos limites dos eventos reais.

Em um exemplo, onde foi mostrada uma visão geral de produto de duas horas, o mesmo esquema arquitetônico foi exibido por 40 minutos, enquanto o orador abordava três tópicos diferentes. O trilho de áudio os dividiu em três memórias, o que permitiu responder a uma pergunta subsequente sobre métricas de teste de carga.

A memória é armazenada em três níveis: L0 armazena o vídeo original, L1 contém memórias no nível de eventos e L2 contém memórias mais detalhadas no nível de segmentos. Os níveis L1 e L2 são totalmente convertidos em texto e vetores, o que permite integrá-los em stacks de geração existentes com amostragem aumentada e bancos de dados vetoriais principais com alterações mínimas. O trabalho principal de organização de dados é realizado offline. Durante uma consulta, o sistema correlaciona a consulta com L1 e L2, extraindo quadros exatos de L0 somente quando a verificação de detalhes visuais é necessária.

Ao testar o OmniMem-Lens em conjunto com Qwen3-VL-8B contra a resposta direta do Qwen3-VL-8B a partir do vídeo, a precisão de recuperação de informações aumentou em 8% no Video-MME-L e em 6,4% no LVBench. O maior aumento, de 45,7%, foi alcançado no EgoLife-QA, um conjunto de dados de primeira pessoa que registra um dia inteiro de vida cotidiana, onde o corte fixo frequentemente falha. No LVBench, o tempo de resposta em modo online diminuiu de 34,5 segundos para 1,72 segundos, cerca de 20 vezes mais rápido, e a equipe estima uma redução máxima de latência de 97%.

O código-fonte do projeto está disponível no GitCode com um espelho no GitHub sob a licença Apache-2.0. A equipe relata que o openJiuwen WorkSwarm em breve começará a suportar AgentMemory, o que permitirá memorizar e relembrar vídeos trocados em conversas cotidianas durante discussões posteriores.

SenseTime lança SenseNova 6.8 Flash para fluxos de trabalho de escritório e design
Leia mais
technode.com

SenseTime lança SenseNova 6.8 Flash para fluxos de trabalho de escritório e design

A SenseTime apresentou oficialmente a versão SenseNova 6.8 Flash em 2 de novembro, expandindo as capacidades do seu agente multimodal para colaboração em aplicativos de escritório e no campo do design.

Este modelo é capaz de criar apresentações animadas, pôsteres, websites, gráficos em formato SVG, bem como realizar modelagem 3D usando ferramentas como o Blender.

Além disso, a empresa dá especial atenção aos recursos de memória de longo prazo e interação entre diferentes diálogos. Essas funcionalidades visam ajudar os agentes a lembrar os requisitos do projeto, conectar informações de tarefas anteriores e sugerir ajustes quando dados relevantes mudam.

O modelo está disponível através do assistente Raccoon da SenseTime e pelo plano SenseNova Token Plan. A empresa QbitAI demonstrou a geração de websites, pôsteres e apresentações no cliente Raccoon; testes separados de memória de longo prazo e colaboração proativa foram realizados usando uma versão interna de desenvolvimento.

Scenes AI da Dawa Technology opera com modelos mundiais de 34 bilhões em tempo real em uma única placa RTX
Leia mais
pandaily.com

Scenes AI da Dawa Technology opera com modelos mundiais de 34 bilhões em tempo real em uma única placa RTX

A Dawa Technology, sediada em Chunchin e originada do setor de produção virtual de cinema, apresentou o Scenes AI — um modelo de mundo em tempo real. Este sistema é capaz de transformar vídeos gravados por câmeras comuns em um mundo editável e persistente.

O produto recebeu um prêmio por excelência em um evento intermediário de startups da NVIDIA em Suzhou, em 15 de outubro. Trinta membros do NVIDIA Inception participaram deste estágio, juntamente com mais de 580 participantes.

A maioria dos modelos de vídeo se concentra na previsão do próximo quadro. No entanto, o Scenes AI suporta um estado contínuo do mundo. Elementos como cena, pessoas, câmera, iluminação, objetos e física são armazenados como variáveis separadas que podem ser lidas e modificadas independentemente. Ao mudar, apenas a parte correspondente do estado é atualizada, e não toda a imagem é redesenhada.

Em demonstrações, a Dawa mostrou como uma sala pode se transformar em um campo desenhado à mão, enquanto uma cadeira, um urso de pelúcia e um armário mantêm suas posições. As inscrições na parede permanecem no lugar, e as pessoas aparecem e desaparecem, enquanto o clima muda de neve para chuva.

O sistema inclui uma camada de controle complexa e uma camada generativa leve. A camada de controle, construída em torno do módulo Latent Stage, divide a cena, o personagem, a câmera, a iluminação, o traje e o adereço no espaço latente, aplicando restrições físicas para sólidos, tecidos, líquidos e partículas. A camada de renderização, LiveStage, utiliza difusão esparsa causal para amostrar apenas as áreas em mudança.

O modelo possui um total de 34 bilhões de parâmetros, mas ativa cerca de 4 bilhões a cada passo, o que representa aproximadamente 11,8%. A Dawa afirma que isso reduz o uso da GPU em 40% a 60% e acelera a inferência três a cinco vezes em comparação com a difusão de vídeo tradicional.

Em uma única placa de consumo NVIDIA GeForce RTX, o sistema atinge a inferência em tempo real em resolução de 720p e taxa de 25 quadros por segundo. Em testes de edição contínua, a empresa relata uma taxa de sucesso de edição alvo de 98,2% e uma retenção de identidade de pessoas de 93,3%. O sistema utiliza CUDA, TensorRT e NVENC e funciona em hardware local sem computação em nuvem.

A Dawa afirma que seus dados foram obtidos em um estúdio de 84.000 metros quadrados, mais de 300 produções reais e 180 TB de dados de estado do mundo. O Diretor de Produto da empresa, Li Zongxin, resumiu a abordagem da seguinte forma: o vídeo pode terminar, mas o mundo deve continuar funcionando. Todos os indicadores de desempenho apresentados são dados fornecidos pela própria empresa.

Popular