Moxin Technology apresenta MoWorld 2.0 — modelo 4D do mundo com simulação de física baseado em Ascend
Leia mais
Pandaily
pandaily.com

Moxin Technology apresenta MoWorld 2.0 — modelo 4D do mundo com simulação de física baseado em Ascend

A Moxin Technology apresentou o MoWorld 2.0, um modelo de mundo quadridimensional que foi treinado e executado diretamente no hardware Huawei Ascend. A apresentação ocorreu no Fórum da Conferência Mundial de Internet em Uzhcheno, em 4 de novembro.

Este lançamento é um desenvolvimento da versão anterior, MoWorld 1.0, lançada em julho. A principal melhoria, segundo a empresa, foi a implementação de processos físicos. O MoWorld 2.0 integra fatores como gravidade, elasticidade, flutuabilidade, iluminação e calor, bem como as propriedades de sólidos, corpos moles, líquidos e materiais deformáveis no processo de construção e interação com o espaço.

O resultado do trabalho são ativos Gaussianos 4D, que podem ser usados para simulações, renderizados em tempo real e aplicados repetidamente. Graças à modelagem de múltiplos aspectos físicos, a Moxin afirma que o modelo gera não apenas a aparência do espaço e dos objetos, mas também determina em tempo real como os itens interagem, como as forças externas os afetam e como o ambiente circundante muda.

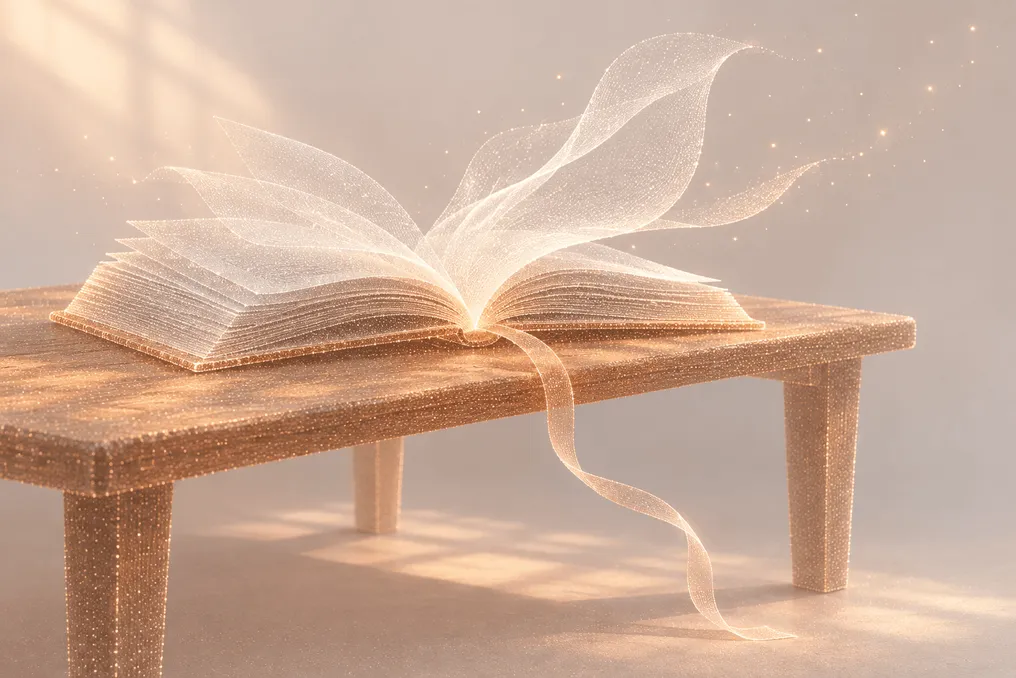
Durante a demonstração, foi mostrado como uma brisa leve faz as páginas de um livro se moverem e um marcador cai no chão. Para isso, foi necessário considerar a força e a direção do vento, a flexibilidade do papel, o peso do marcador e a rigidez do chão. Outros exemplos demonstram cenas que podem ser editadas e com as quais se pode interagir, bem como a possibilidade de acelerar ou desacelerar o tempo.

O MoWorld 2.0 foi desenvolvido e executado em uma base computacional totalmente nacional Ascend. A Moxin informou que colaborou com equipes da Huawei na otimização de sistemas de inferência, planejamento multi-NPU e treinamento de sequências longas. Segundo suas próprias estimativas, o custo de inferência pode cair para 30% do custo de instalação de uma GPU de escala semelhante.

A empresa também destacou o aumento de velocidade: a inferência de vídeo aumentou de picos de 50 quadros por segundo na versão 1.0 para aproximadamente 70 quadros por segundo. O renderização de ativos Gaussianos 3D e 4D excede 500 quadros por segundo, e os testes em telefones móveis atingem cerca de 100 quadros por segundo. Anteriormente, a Moxin havia apresentado uma versão simplificada do MoWorld no telefone Mate 90 da Huawei.

A Moxin trabalha com parceiros na validação e implementação da tecnologia em diversas áreas. Para IA incorporada (embodied AI), o MoWorld 2.0 cria ambientes virtuais com estrutura espacial e feedback físico básico, permitindo que robôs treinem e repitam ações em simulação. No campo da condução autônoma, o modelo gera cenários com fenômenos raros, como chuva, neve, buracos e obstáculos repentinos. Outras áreas de aplicação incluem a criação de gêmeos digitais industriais de linhas de produção e minas, planejamento urbano, turismo virtual e a criação de cenas reutilizáveis para produção cinematográfica e de jogos, que suportam movimento livre de câmera, edição de objetos e alteração do clima.
Histórias semelhantes

AgiBot apresenta o robô GO-3 Preview, que ficou em primeiro lugar em três rankings e planeja ser um projeto aberto
Leia mais
pandaily.com

AgiBot apresenta o robô GO-3 Preview, que ficou em primeiro lugar em três rankings e planeja ser um projeto aberto

A empresa AgiBot lançou o modelo GO-3 Preview em 29 de outubro. Este modelo encarnado de inteligência artificial é capaz de continuar aprendendo em escala em todas as fases: durante o pré-treinamento, após ele e já após a implementação no trabalho. A AgiBot pretende tornar o modelo completo acessível ao público até o final de 2026.

O GO-3 Preview é baseado em uma arquitetura que a AgiBot chama de WRAM, ou Modelo de Raciocínio de Ações no Mundo. Esta arquitetura conecta o raciocínio sobre a tarefa, a previsão de eventos futuros e a geração de ações, permitindo que o robô entenda a instrução, preveja o resultado e execute os movimentos correspondentes.

O modelo conquistou recentemente o primeiro lugar em três rankings para IA encarnada: RoboDojo, RoboTwin e RoboColiseum. A AgiBot afirma que o modelo é escalável em duas direções. Por um lado, ricos exemplos de processamento de objetos e desenvolvimento de tarefas são fornecidos por vídeos em primeira pessoa de pessoas, e as trajetórias dos robôs ligam observações a ações e resultados físicos.

Por outro lado, a maior capacidade de aprendizado do modelo transforma essa experiência dispersa em habilidades que podem ser aplicadas a novas tarefas. Após o pré-treinamento, a empresa observa que os robôs podem realizar tarefas desconhecidas em casas, cozinhas, sistemas com múltiplos robôs e realizar manipulação fina sem ajuste fino adicional.

Com várias demonstrações, o modelo é capaz de dominar operações longas e delicadas, como preparar jianbing — um panqueca picante chinês. Após o ajuste fino e a coordenação dos passos pelo agente, o robô também pode montar peças de Lego.

Para a fase pós-treinamento, a AgiBot desenvolveu o sistema de aprendizado distribuído Genie Evolver, que combina cerca de cem robôs reais com simulação de física e modelos de mundo. Em um jogo de curling na mesa, o robô superou um humano testado médio após quatro horas de treinamento online. Em um jogo de torres de blocos, ele conseguiu retirar cinco blocos seguidos, mantendo a estabilidade da torre.

Após a implementação, a estrutura de agente Genie Master garante a conexão entre julgamento, execução e feedback, permitindo que os robôs melhorem continuamente durante o trabalho. O robô AgiBot G2, operando em uma loja de varejo 24 horas, detectou autonomamente as causas de suas próprias falhas, ajustou sua abordagem e manteve o conhecimento adquirido sem intervenção humana ou configuração. O sucesso deste robô em um fluxo de trabalho completo aumentou de 28,6% no primeiro dia para estáveis 85,7% em cinco dias.

Em uma tarefa semelhante à suspensão de pequenos ganchos, a AgiBot afirma que este método aumentou o sucesso da tarefa individual em 17,7 pontos percentuais em comparação com o ajuste fino tradicional controlado, e o processo de aprendizado continua online.

MOSI e OpenMOSS lançam modelo MOSS-Image de código aberto para controle de texto e layout
Leia mais
pandaily.com

MOSI e OpenMOSS lançam modelo MOSS-Image de código aberto para controle de texto e layout

A equipe da MOSI Intelligence, em colaboração com a equipe do OpenMOSS, apresentou o MOSS-Image, um sistema de conversão de texto para imagem com 5 bilhões de parâmetros. Este sistema é projetado para criar materiais gráficos, como fotos de produtos e pôsteres, onde não apenas a alta qualidade da imagem, mas também o posicionamento denso do texto e a adesão precisa ao layout são críticos.

O lançamento inclui as versões MOSS-Image-Base e MOSS-Image-SFT, que passou por ajuste fino controlado. Os pesos desses modelos estão disponíveis nas plataformas Hugging Face e ModelScope sob a licença Apache 2.0. Um relatório técnico indica que MOSI Intelligence, o Shanghai Institute of Innovation (SII), a Fudan University e a Shanghai Jiao Tong University participaram do desenvolvimento.

Alguns dias após o lançamento, em 16 de outubro, mídias tecnológicas chinesas relataram que o modelo alcançou posições de destaque na lista de tendências text-to-image no Hugging Face. A atividade da comunidade foi alta: o número de downloads e estrelas no GitHub cresceu rapidamente, e o repositório oficial ultrapassou 1.4 mil estrelas. É importante notar que esses números são dados da comunidade e não métricas verificadas pela empresa, e eles mudam constantemente devido à aparição de vários espelhos e pontos de controle destilados.

Desenvolvedores nas plataformas Reddit e X já publicaram testes comparativos com outros modelos de pesos abertos. A comunidade também lançou destilações com passos 8 e 4, pacotes de quantização e fluxos de trabalho para ComfyUI.

A principal vantagem oferecida pela equipe é o controle. O MOSS-Image aceita solicitações de até 4096 tokens e pode utilizar um layout estruturado em JSON, que define texto e objetos usando caixas delimitadoras, em vez de depender exclusivamente da composição definida em linguagem natural. De acordo com o teste da equipe no Long Long Text Benchmark, o modelo demonstra uma cobertura média de texto de 96,3% entre os modelos de pesos abertos.

No benchmark RealLayoutArena, que é um teste cego de design de ponta a ponta, a pontuação Elo do modelo é de 1698,70. Este valor fica aquém do GPT Image 2 ao usar tarefas de design concisas, mas atinge 1807,34 ao aplicar prompts gerais aprimorados, colocando-o em primeiro lugar no segundo grupo de acordo com o próprio sistema de avaliação da equipe.

Arquitetonicamente, o MOSS-Image é um transformador difusivo de fluxo único, pré-treinado do zero. O caminho generativo unificado é alimentado pelo codificador de texto congelado Qwen3.5-9B e pelo autoencoder variacional FLUX.2. Segundo a equipe, a receita de treinamento envolve a filtragem de imagens geradas por IA para preservar maior diversidade fotográfica, e o treinamento foi realizado em plataformas de GPU heterogêneas. Adaptadores para Diffusers, ComfyUI, SGLang e vLLM-Omni já estão disponíveis, e uma API de hospedagem foi lançada na plataforma MOSI.

Fornecer pesos abertos oferece aos designers e desenvolvedores agentes compactos para trabalhos que exigem layout complexo, sem a necessidade de esperar acesso a uma API fechada. Deve-se ressaltar que todos os indicadores de benchmark e classificações apresentados são baseados no relatório da equipe e nos dados da comunidade, e devem ser considerados como auto-relatórios ou sinais coletados da comunidade, e não como resultados laboratoriais independentes.

ShengShu transmite o processo de treinamento do Motubrain 2.0 antes do lançamento do modelo
Leia mais
pandaily.com

ShengShu transmite o processo de treinamento do Motubrain 2.0 antes do lançamento do modelo

A equipe de modelos globais da ShengShu Technology iniciou uma transmissão ao vivo do processo completo de treinamento do Motubrain 2.0, a próxima versão de seu modelo de inteligência artificial encarnada para robôs. A transmissão começou em 21 de outubro e está programada para durar cerca de duas semanas.

A empresa informou que o Motubrain 2.0 será lançado em acesso aberto em breve e decidiu demonstrar o processo de treinamento antes desse lançamento.

Os modelos Motubrain representam uma família de modelos fundamentais de robôs da ShengShu, cujo objetivo é fornecer aos robôs um cérebro universal capaz de aplicar habilidades em diferentes tarefas, cenários e tipos de robôs. A primeira versão do Motubrain foi apresentada em abril como um modelo de alcance global. Vale ressaltar que a ShengShu é mais conhecida por seus modelos de geração de vídeo Vidu.

Estrutura da Transmissão

A transmissão ao vivo está dividida em quatro fases. A fase de pré-treinamento explora como a escala do treinamento afeta o desempenho e a capacidade de generalização em condições de tiro zero. O treinamento subsequente foca na execução de tarefas específicas para melhorar a performance. Em seguida, há a fase de tarefas do agente, que verifica se o modelo pode transferir o conhecimento adquirido para outras tarefas. A fase final é dedicada à autoaperfeiçoamento recursivo, para determinar se o modelo é capaz de avaliar suas ações com base no feedback da execução e melhorá-las.

Na página de transmissão em tempo real, os passos de treinamento e as métricas de sucesso da avaliação são exibidos à medida que são atualizados.

A ideia principal desta demonstração é a transparência. Geralmente, o progresso na IA encarnada é avaliado por observadores externos através de demonstrações polidas de robôs, tabelas de benchmarks e artigos científicos, que pouco revelam como exatamente as capacidades são formadas durante o treinamento ou quais problemas surgem. A ShengShu afirma que a transmissão mostrará não apenas sucessos, mas também erros, o processo de tentativa e erro, bem como correções, e espera compartilhar com outros pesquisadores questões abertas relativas à escalabilidade, generalização entre tarefas e melhoria autônoma.

Este passo está alinhado com uma tendência mais ampla entre equipes chinesas de IA, que compartilham publicamente o progresso do treinamento. Anteriormente, Luo Fuli, líder dos modelos MiMo da Xiaomi, publicou detalhes da fase de treinamento por reforço para o MiMo-V2.6.

No entanto, existem limitações ao que uma transmissão ao vivo pode provar. Os pesos do modelo ainda não foram lançados, e a própria empresa declara que a pesquisa permanece em caráter experimental, e os resultados exigirão experimentos e avaliações subsequentes para confirmação. O anúncio foi fornecido pela ShengShu e noticiado pela mídia tecnológica chinesa. O verdadeiro teste será o lançamento em acesso aberto e a conformidade de seus benchmarks com o que foi mostrado na transmissão.

Popular