A empresa de IA HongYun, sediada em Pequim, apresentou o HyperLM V2.5 — uma nova versão de sua plataforma para treinamento combinado e inferência de grandes modelos. Isso foi relatado pelas publicações IT Home e ifeng Tech em 3 de novembro. A empresa afirma ser a primeira a realizar uma adaptação profunda ao chip Huawei Ascend 950DT, sendo totalmente compatível com o sistema Atlas 850E SuperPoD com resfriamento a ar e tendo passado pela certificação técnica da Huawei para Ascend Native.
A HongYun acredita que a definição de suporte é frequentemente muito vaga, quando um modelo é considerado suportado apenas após a instalação e geração de tokens. O objetivo da empresa é ajudar clientes governamentais e corporativos que utilizam implantações privadas a obter o máximo desempenho dos novos aceleradores.
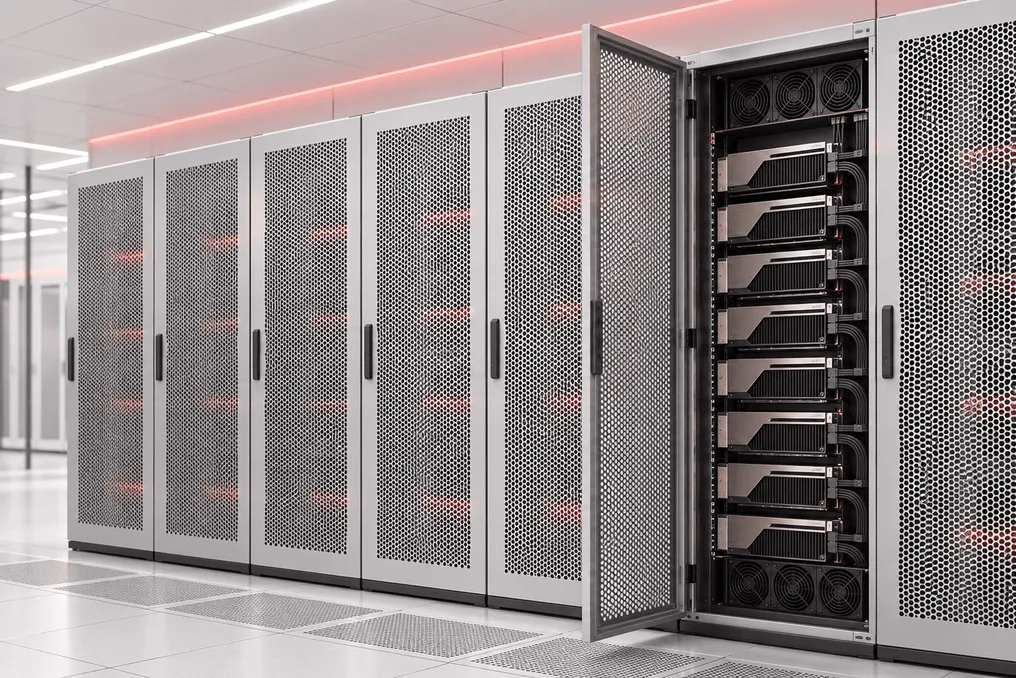
A empresa descreve o Ascend 950DT como um chip de ponta para tarefas que exigem alta taxa de transferência, como interações prolongadas em chats, processamento de documentos longos e raciocínio contínuo de agentes. Além disso, observa-se que o sistema Atlas 850E com resfriamento a ar pode ser integrado em data centers existentes sem a necessidade de modernizar a infraestrutura.
O HyperLM V2.5 se adapta em vários níveis. No nível de interconexão, a plataforma suporta a tecnologia UnifiedBus 2.0 da Huawei, que fornece uma largura de banda de interconexão do sistema de 13,4 TB/s, prevenindo gargalos na transmissão de tráfego entre placas, o que é importante para contextos longos ou divisão das fases de pré-preenchimento e decodificação. No nível do operador, o sistema é otimizado para inferência mxFP4, permitindo o uso de 14,2 PFLOPS por nó.
A plataforma suporta os modelos de código aberto mais recentes, incluindo Qwen, GLM e DeepSeek, e seu agendador foi reconstruído levando em consideração o perfil de memória e largura de banda do 950DT.
O lançamento do HyperLM V2.5 inclui cinco novos recursos. A divisão de pré-preenchimento e decodificação permite isolar duas fases em pools de recursos independentes para que não entrem em concorrência durante picos de carga. O cache KV multinível reutiliza prompts do sistema, contextos frequentemente encontrados e modelos de sessão fixos para reduzir o volume de cálculos repetidos. A virtualização vNPU segmenta os chips Ascend 950DT, 910C e 910B, fornecendo cotas granulares e isolamento para cálculos AI Core e memória HBM, além de suportar migração a quente e reagendamento automático em caso de falha de hardware.
Também foi adicionado um modelo de gateway unificado, compatível com o protocolo OpenAI, que gerencia roteamento, limitação de taxa, versões beta e testes A/B. O monitoramento abrangente de toda a pilha rastreia carga, uso de memória, largura de banda, latência e QPS, fornecendo alertas e localização automática de falhas.
Para setores regulamentados, como governo, energia, transporte e finanças, a plataforma prevê a separação de funções de administrador, segurança e auditor, controle multinível de classificação e logs operacionais completos, bem como contabilidade de capacidade computacional, auditoria de chamadas de modelos e estatísticas de uso por projeto.
A HongYun foi incubada pelo Instituto Ocidental de Tecnologia Computacional da Academia Chinesa de Ciências, e sua equipe principal é formada por funcionários do Instituto de Tecnologia Computacional e Sugon. Em 2020, a empresa aderiu ao programa de parceria Ascend da Huawei. A empresa planeja continuar o desenvolvimento com base no hardware Ascend e Hygon DCU, focando em agendamento heterogêneo, aceleração de inferência, cache e aplicações de agentes.