Meituan lança LongCat-2.5, um modelo multimodal com 1,6 trilhão de parâmetros para codificação de agentes de longo alcance
Leia mais
Pandaily
pandaily.com

Meituan lança LongCat-2.5, um modelo multimodal com 1,6 trilhão de parâmetros para codificação de agentes de longo alcance

A equipe do LongCat da Meituan apresentou o modelo LongCat-2.5 em 2 de novembro. Este modelo é um sistema nativo multimodal desenvolvido para executar tarefas de agentes de longo alcance. De acordo com o IT Home, o modelo possui um total de 1,6 trilhão de parâmetros e ativa cerca de 48 bilhões deles ao processar cada token.

O LongCat-2.5 baseia-se na versão anterior LongCat-2.0 e melhora significativamente dois aspectos chave: a compreensão nativa de dados visuais e a capacidade de codificação de agentes. O lançamento oficial ocorreu após a versão preliminar LongCat-2.5-Preview, que esteve disponível na plataforma LongCat API desde 25 de setembro.

Melhorias no treinamento e trabalho com tarefas

Grande parte do processo de treinamento foi focada em tarefas de longa duração. A Meituan informou que adicionou mais dados de trajetórias de longo alcance ao treinamento de sequências longas e utilizou aprendizado por reforço em larga escala de longo alcance para aprimorar o trabalho de engenharia ponta a ponta. Isso inclui o desenvolvimento dentro de grandes bases de código complexas e a criação de projetos completos.

A equipe continua a expandir a síntese de dados, construir ambientes e realizar treinamento misto em vários mecanismos de agentes. Além disso, eles transformam trajetórias de falhas de agentes reais em tarefas reprodutíveis e verificáveis para treinamento, permitindo enriquecer continuamente o banco de dados em áreas onde o modelo demonstra fraquezas.

Compreensão visual e infraestrutura

Em termos de processamento de imagens, o LongCat-2.5 representa sinais visuais como tokens discretos de múltiplos níveis. Graças a isso, a maior parte do modelo processa imagens e texto em uma forma tokenizada unificada. A Meituan afirma que a combinação dessa visão nativa com a codificação de agentes torna o modelo forte em codificação visual, permitindo-lhe lidar com design criativo e tarefas 3D.

A infraestrutura que suporta o lançamento do modelo opera em capacidades computacionais domésticas. A Meituan otimizou o treinamento de contexto longo e a inferência W4A4, que utiliza pesos de 4 bits e ativações de 4 bits, em chips internos. O trabalho no alinhamento numérico entre treinamento e inferência, bem como a otimização da implantação de contexto longo, garante o funcionamento eficiente do aprendizado por reforço em larga escala de longo alcance.

Resultados de testes e disponibilidade

De acordo com a tabela de benchmarks apresentada pela própria Meituan, o LongCat-2.5 obteve um resultado de 88.4 no Terminal Bench v2.1, superior aos 70.8 do LongCat-2.0, e 51.8 no AutomationBench contra 15.8. O modelo também alcançou 91.9 no BrowseComp, 82.1 no PaperBench, 55.4 no 3DCodeBench e 78.6 no Vision2Web. Em comparação com modelos avançados de outros laboratórios, o LongCat-2.5 não ocupa o primeiro lugar em todos os testes; por exemplo, no Program Bench, ele atinge 25.5 contra 37 do melhor concorrente. Deve-se notar que esses resultados ainda não foram verificados independentemente.

No log de alterações do LongCat, está indicado que o modelo é compatível com Claude Code, Codex, Hermes e outros mecanismos principais, e a documentação da plataforma contém guias de configuração de ferramentas como OpenCode, Cline, Kilo Code, CodeBuddy e WorkBuddy. O LongCat-2.5 está disponível em longcat.chat e através da LongCat API, sendo que a Meituan anunciou lançamentos futuros no GitHub e Hugging Face.

Histórias semelhantes

SenseTime lança o modelo SenseNova-Loop-9B-Preview com arquitetura cíclica
Leia mais
pandaily.com

SenseTime lança o modelo SenseNova-Loop-9B-Preview com arquitetura cíclica

A SenseTime lançou publicamente o modelo SenseNova-Loop-9B-Preview em 30 de outubro. Este modelo multimodal é construído com um design de loop (looped Transformer design) e, segundo a empresa, é capaz de competir com modelos de cerca de 27 bilhões de parâmetros usando apenas 9 bilhões de parâmetros.

Os pesos do modelo estão disponíveis na plataforma Hugging Face sob a licença Apache 2.0, e o código-fonte está no GitHub. De acordo com o cartão do modelo, ele possui 32 camadas de decodificador separadas. As quatro primeiras e as últimas quatro camadas são executadas uma vez, enquanto as camadas de 4 a 27, que constituem um bloco de 24 camadas, são executadas sequencialmente duas vezes usando pesos compartilhados. Isso resulta em 56 execuções de camadas de decodificador em uma única passagem direta, armazenando apenas 32 conjuntos de pesos de camadas.

O decodificador alterna entre mecanismos de atenção linear e completa: em cada grupo de quatro camadas, seguem-se três camadas de atenção linear, seguidas por uma camada de atenção completa. Os limites do ciclo coincidem com esses grupos. O modelo aceita texto e imagens como entrada e gera texto como saída. Seus receptores de treinamento utilizam sequências de até 262.144 tokens, incluindo texto, imagens, código e trajetórias de ferramentas.

Dentro da seção de loop, a SenseTime integrou hiperconexões de dois fluxos com restrição de variedade (two-stream manifold-constrained hyper-connections, mHC). Essas conexões transportam dois fluxos residuais e utilizam mapeamentos aprendidos, restritos pela normalização de Synchorn, para misturar informações entre eles. A empresa relata que testes de exclusão de componentes mostraram que os mHC aumentaram as pontuações no GPQA Diamond em 4,42 pontos e no TeamBench em 13,34 pontos.

A SenseTime afirma que, sob condições de avaliação, seu modelo supera outros modelos em tarefas de codificação, tarefas de escritório e tarefas de agente, e também supera o Qwen3.5-27B nos benchmarks WorkBuddy Bench, RaccoonPPT Bench e AutomationBench. O gráfico de benchmarks no cartão também apresenta resultados para BIRD-Dev, AIDABench, Terminal Bench 2.1 e T3-Banking. Esses dados são resultados próprios da empresa, e um relatório técnico ainda está pendente.

O modelo suporta MTP para acelerar a inferência, enquanto outros dois métodos de aceleração — Dspark e Dflash2 — ainda estão em fase de treinamento. A SenseTime planeja investigar mais adiante DSA e o número adaptativo de iterações para aumentar a eficiência e o desempenho nas tarefas.

Tongyan Lingzhi utiliza adaptadores LoRA pessoais e modelos de autoaperfeiçoamento para desenvolver IA
Leia mais
pandaily.com

Tongyan Lingzhi utiliza adaptadores LoRA pessoais e modelos de autoaperfeiçoamento para desenvolver IA

A Tongyan Lingzhi, uma subsidiária da plataforma industrial do Instituto de Inteligência Artificial Geral de Pequim (BIGAI), apresentou sua abordagem ao conceito de IA pessoal. Essa abordagem envolve a criação de modelos que aprendem continuamente com base nos dados de um indivíduo, projeto ou empresa específico, em vez de depender apenas de consultas e busca de informações.

A maioria dos sistemas de IA corporativos existentes hoje se adapta aos usuários externos. Eles usam consultas para estabelecer regras, extraem documentos através de busca, armazenam o estado na memória e empacotam etapas reutilizáveis. No entanto, os pesos do modelo raramente são alterados após a interação.

A Tongyan Lingzhi afirma que hábitos estáveis, como padrões de engenharia de uma equipe ou disciplina de gestão de riscos de um grupo de investimento, podem ser integrados diretamente nos parâmetros do modelo. A arquitetura da empresa prevê a manutenção de um modelo base geral para processar conhecimentos e raciocínios comuns, ao qual são adicionados adaptadores Personal LoRA leves para cada usuário, projeto ou organização individual. A empresa observa que essas capacidades individuais devem ser mantidas mesmo em caso de substituição do modelo base.

Para manter o treinamento desses adaptadores, a equipe desenvolve um mecanismo de autoaperfeiçoamento recursivo, ou RSI. Rastreamentos de tarefas, correções humanas e resultados obtidos tornam-se dados potenciais para treinamento. Um avaliador especial, configurado de acordo com os padrões de cada usuário ou empresa, seleciona os sinais que devem ser estudados antes de aplicar uma atualização incremental LoRA. O modelo atualizado é então executado nas mesmas tarefas da versão anterior, e apenas as melhorias são lançadas no ambiente de trabalho, enquanto as regressões são revertidas.

O diretor técnico Chu Bingbin enfatizou que uma variação desviada é apenas um sinal, e apenas padrões recorrentes devem se tornar dados de treinamento. Além disso, a empresa está trabalhando na criação de infraestrutura para tornar milhares desses adaptadores acessíveis. O sistema TIP executa treinamento e inferência paralelamente nos mesmos GPUs, e o Paged LoRA gerencia a memória do adaptador em páginas. Em uma fase de teste usando Qwen2.5-72B-Instruct em oito GPUs Nvidia H800 e um orçamento de memória de adaptador de 5,79 GB, o Paged LoRA demonstrou menor latência e melhor comportamento na 'cauda' em comparação com o layout plano, quando as consultas LoRA variavam de 1% a 30% do tráfego, embora o desempenho tenha diminuído ao atingir 50%.

A Tongyan Lingzhi reconhece que o trabalho ainda está em estágio inicial. Embora o caminho técnico do RSI e a arquitetura do produto estejam definidos, e os módulos estejam em fase de design, o ciclo de treinamento totalmente automatizado ainda está em desenvolvimento. Problemas abertos incluem esquecimento catastrófico, contaminação por feedback e deriva do modelo.

Empresa VAST lança modelo aberto EdenLive para renderizar frames de jogos simples em vídeo detalhado
Leia mais
pandaily.com

Empresa VAST lança modelo aberto EdenLive para renderizar frames de jogos simples em vídeo detalhado

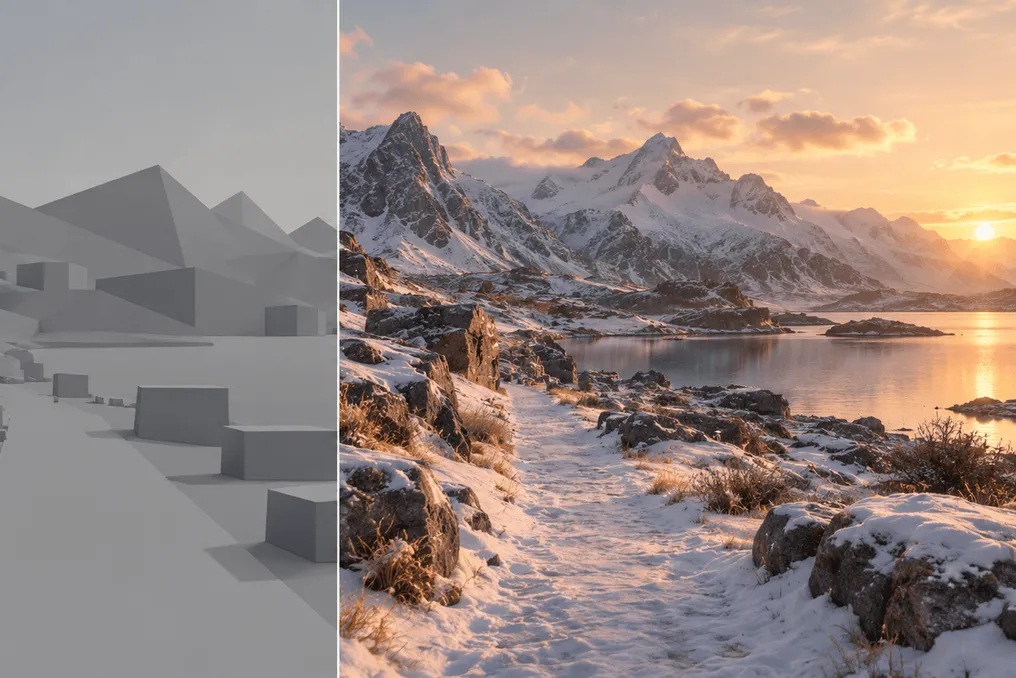
A VAST, uma empresa especializada em IA generativa em 3D e por trás da plataforma Tripo, tornou o modelo EdenLive público. Este modelo opera em tempo real e é capaz de pegar frames de jogos simplificados ou vídeos existentes, redesenhando-os continuamente em imagens detalhadas em um estilo escolhido, que pode variar de fotorrealista a anime.

O lançamento inclui pesos de modelos de 5B e 14B, código para inferência em tempo real, um relatório técnico e demonstrações de uso ponta a ponta. É importante notar que o EdenLive não simula o mundo por conta própria; em vez disso, um programa superior, como um motor de jogo ou código escrito por um agente de codificação, é responsável por aplicar as regras, rastrear o estado do mundo e gerar um vídeo de referência bruto.

Após receber este vídeo de referência, o EdenLive realiza o render, guiado pelo primeiro frame definido e pelo prompt de texto. A VAST afirma que essa separação permite manter a lógica do jogo explícita e testável, enquanto as capacidades limitadas do modelo em tempo real são focadas exclusivamente na aparência.

A abordagem foi apresentada pela primeira vez em junho no âmbito de uma pesquisa mundial mais ampla conhecida como Projeto Eden. De acordo com a VAST, o modelo de 5B é capaz de operar com uma taxa superior a 24 quadros por segundo em resolução 720p em uma única placa Nvidia RTX 5090. No arquivo README do GitHub, esse número é indicado aproximadamente como 24.7 FPS em resolução de 1280 por 704 pixels, utilizando aceleração do framework de inferência LightX2V.

O relatório técnico relata uma taxa de 29.8 FPS na mesma resolução em um único H100, bem como 26.8 FPS em resolução de 832 por 480 para o modelo de 14B rodando em oito H100. A VAST afirma que a latência total desde a entrada do usuário até o quadro correspondente é de centenas de milissegundos, e o sistema pode gerar conteúdo continuamente por vários minutos.

Ambos os modelos são baseados nos modelos de vídeo Wan2.2-TI2V-5B e Wan2.1-I2V-14B. O código de inferência e os principais pesos de difusão, VAE e decodificador são distribuídos sob a licença Apache 2.0, mas nem todos os componentes possuem essa licença. O codificador visual utiliza a licença DINOv3, e o modelo de imagem usado no espaço de trabalho de solicitação para jogo está sob a Licença Não Comercial FLUX, o que restringe o uso desse espaço de trabalho a fins não comerciais.

A VAST também apresentou o Game Prototype Turbo — um recurso que transforma um prompt de texto em um jogo jogável bruto, que pode então ser renderizado pelo EdenLive. As demonstrações da VAST incluem um plataforma onde o personagem congela lava para criar pontos de apoio, um jogo de luta multiplayer onde as barras de vida e o cronômetro de rodada são rastreados pelo sistema superior, e o render de vídeo que transforma uma pessoa filmada contra um fundo azul em um personagem de desenho animado. Além disso, o modelo demonstra a substituição de mãos humanas por robóticas em filmagens de primeira pessoa para criar dados de treinamento adicionais para IA incorporada.

A VAST observa que, atualmente, o EdenLive é mais adequado para interações de baixa frequência, como inspeção de cenas e quebra-cabeças de empurrar caixas. Jogabilidade rápida e intensa, manutenção da coerência de múltiplos personagens, controle fino de objetos pequenos e estabilidade visual em sessões longas ainda requerem melhorias.

Popular