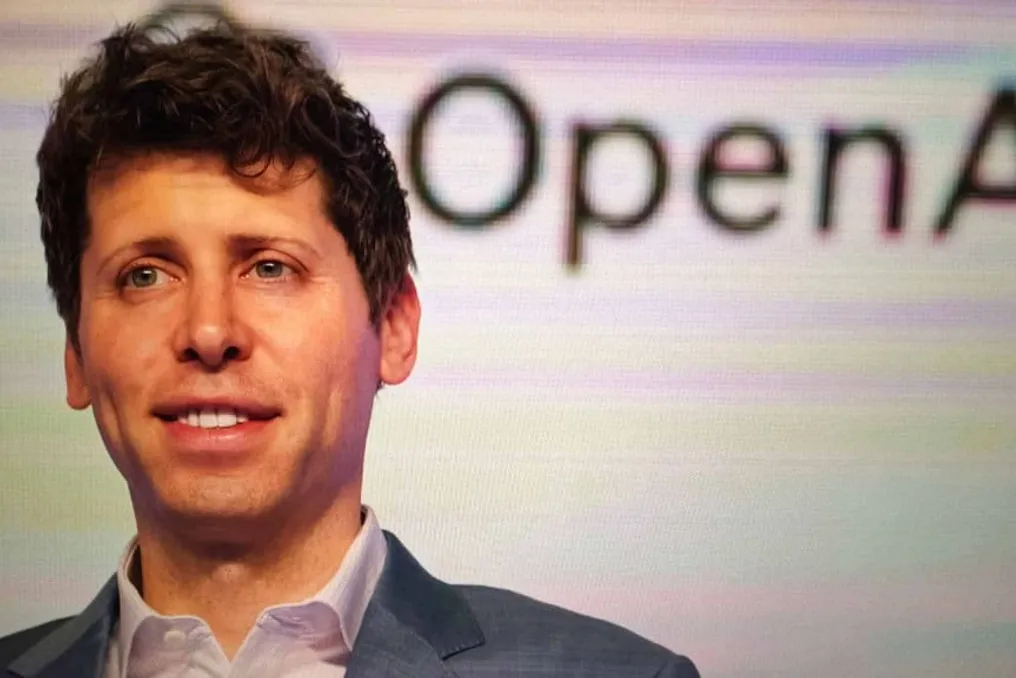
Sam Altman, CEO da OpenAI, expressou sua opinião de que manter grandes volumes de memória RAM em computadores pessoais constitui um desperdício, considerando a atual escassez mundial desse componente. Para o executivo, seria mais vantajoso direcionar esses recursos para os data centers, otimizando assim a capacidade existente.
Essa declaração foi proferida durante uma participação no podcast Cheeky Pint, em um debate sobre os entraves nas cadeias de suprimentos de tecnologia. Altman manifestou críticas específicas à noção de que modelos de inteligência artificial (IA) de código aberto, executados diretamente nos dispositivos dos usuários, poderiam diminuir a necessidade de vastos centros de processamento.
Ele apontou que muitos indivíduos acreditam que a execução de modelos localmente solucionaria parte da demanda por infraestrutura de IA. Contudo, o executivo argumenta que essa abordagem não é necessariamente a maneira ideal de gerenciar um recurso que está em falta.
Altman declarou: «Do ponto de vista da alocação global, é realmente péssimo que todo mundo tenha uma parte da oferta limitada de DRAM do mundo parada no próprio computador, sendo utilizada apenas 5% do tempo». Segundo a análise do CEO, a memória disponível precisa ser empregada com a máxima eficiência possível. Ele complementou: «Você quer a utilização máxima na nuvem se está tentando lidar com esse ambiente de oferta extremamente restrita».
A perspectiva de Altman contrasta com o interesse de desenvolvedores e usuários em rodar modelos de IA diretamente em seus PCs. Essa opção tem o potencial de diminuir a dependência de serviços hospedados na nuvem e possibilitar a realização de certas tarefas sem depender constantemente da infraestrutura de grandes corporações.
Por outro lado, o argumento do executivo baseia-se na premissa de que a memória instalada nos data centers pode ser utilizada de forma muito mais intensa, enquanto os computadores pessoais tendem a permanecer ligados sem explorar totalmente sua capacidade.
Este debate evidencia um conflito entre duas metodologias de distribuição de recursos computacionais: seja mantendo a capacidade de processamento nas mãos dos usuários, ou centralizando-a em grandes estruturas compartilhadas.