A ACE Robotics, em colaboração com o S-Lab da Nanyang Technological University, lançou o Mundo — um modelo de mundo capaz de criar um ambiente interativo e explorável com base em um pequeno número de imagens de um local real. Isso foi relatado pelo portal de notícias chinês Robot Pro em 31 de outubro.
A equipe afirma que o Mundo pode recriar uma cena, exibi-la de diferentes ângulos e modelá-la no tempo, permitindo testar e treinar robôs em uma cópia digital de um espaço específico.
De acordo com o repositório no GitHub, o código e os pesos do modelo estarão disponíveis até o final de novembro.
Como Funciona o Mundo
O Mundo aceita de uma a doze imagens contextuais e gera novas vistas ao longo de um caminho de câmera definido. Ao usar apenas uma imagem, o sistema expande o estilo e a estrutura visíveis para áreas não visíveis, e o aumento no número de imagens reduz a incerteza em zonas que não foram fotografadas.
Para espaços maiores, o modelo é capaz de criar movimentos de câmera com duração de dezenas de segundos a vários minutos, selecionando as fotos mais adequadas para cada segmento e sobrepondo-as para garantir a coerência.
Detalhes Técnicos do Modelo
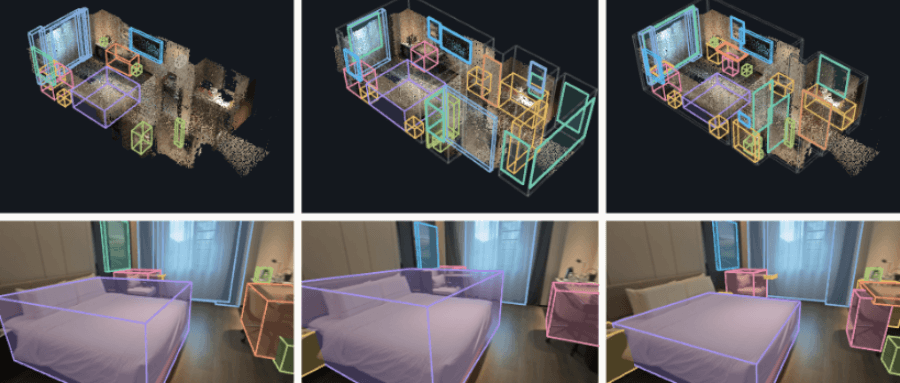
A base do funcionamento é um modelo fundamental tridimensional que restaura as poses das câmeras e a geometria densa. Simultaneamente, um detector tridimensional cria um retângulo delimitador inicial para cada objeto grande. Como os detectores podem omitir objetos ou avaliar incorretamente seus tamanhos, um agente baseado em visão e linguagem edita o programa da cena, renderiza-o a partir de cada ponto de vista de entrada, compara o resultado com as fotos originais e determina o que precisa ser corrigido. Paralelamente, a otimização numérica ajusta a posição, o tamanho e a orientação das caixas.
Um agente de verificação separado monitora a coerência sem interferir na edição da cena. O programa da cena registra o nome, pose, tamanho, massa e coeficiente de atrito de cada objeto. Os scripts aplicam forças e ações, e o motor físico, que atualmente é o MuJoCo, calcula o movimento, contato e colisões. Em seguida, um modelo de difusão de vídeo visualiza a simulação no estilo das fotos originais.
A equipe refinou o modelo MiniMax reference-to-video, utilizando cerca de 40.000 pares de vídeos de 640x480, gerando clipes de 124 quadros e reutilizando os últimos 34 quadros de cada clipe para manter a continuidade de vídeos longos.
Exemplos de Uso e Limitações
As demonstrações incluem cenários onde robôs se movem por um piso recriado de hotel, abrem uma máquina de lavar na lavanderia, colocam uma maçã em uma tigela e empilham cubos, utilizando vistas de câmeras de cabeça e punho, bem como trajetórias gravadas.
A equipe definiu claramente os limites das capacidades do sistema: o processo de reconstrução leva de 10 a 20 minutos, o renderização é realizada a uma taxa de aproximadamente 1,5 quadros por segundo em oito GPUs A800 com 20 passos de inferência. Também foi observado que objetos pequenos podem parecer flutuantes e que a memória de longo prazo para cenas que mudam ao longo de um longo período está ausente.