Método HarnessPro da Tsinghua e Zhipu permite que agentes alterem sua própria estrutura, reduzindo custos em 26% em tarefas
Leia mais
Pandaily
pandaily.com

Método HarnessPro da Tsinghua e Zhipu permite que agentes alterem sua própria estrutura, reduzindo custos em 26% em tarefas

Pesquisadores da Universidade Tsinghua, Zhipu, Universidade Jiaotong de Xangai, University of Warwick e Kuaishou apresentaram o HarnessPro — um método que permite à inteligência artificial melhorar o ambiente em que opera. Este ambiente é um framework que define prompts, ferramentas, orçamentos e a sequência de execução das tarefas do agente.

Em um artigo científico publicado no arXiv em 19 de outubro, com a participação do cientista-chefe da Zhipu, Tan Ze, foi adicionado um segundo objetivo de autoaperfeiçoamento: aumentar a produtividade ao mesmo tempo em que se reduzem os custos operacionais.

Este projeto continua o trabalho da Zhipu desde setembro, quando foram apresentadas informações sobre o Agente de Infraestrutura baseado em GLM-5.3, que ajudou a criar e configurar a infraestrutura de inferência para GLM-5.3-Flash, aumentando o throughput de ponta a ponta em cerca de três vezes em comparação com o nível inicial em menos de duas semanas.

Como funciona o HarnessPro

O HarnessPro começa com uma configuração existente, coletando dados sobre chamadas de ferramentas, feedback do ambiente e uso de tokens. Em seguida, o agente de análise de trajetória estuda várias execuções da mesma tarefa para identificar as causas de falhas, bem como perdas, como busca repetida, exploração inútil e verificações excessivas.

Após isso, o agente planejador desenvolve três tipos de alterações, priorizando economia, equilíbrio ou desempenho. O agente de edição de framework implementa cada alteração em um espaço de trabalho separado, que é rastreado usando Git para fins de auditoria e reversão.

Para avaliar o progresso sem usar respostas de referência ou testes oficiais, o agente de geração de testes cria testes com base na descrição da tarefa e nas execuções iniciais, e esses testes são fixados para cada candidato. Essa abordagem aumentou significativamente a taxa de detecção de falhas de 41,7% para 83,3% em experimentos iniciais, em comparação com o método de consulta ao modelo de leitura de logs para determinar o sucesso da tarefa.

Candidatos que apresentam resultados piores do que o framework original, ou que são inferiores a outra versão em termos de custo e sucesso, são excluídos. As variantes Lite, Medium e Heavy passam para a próxima fase de teste.

Resultados dos testes

A equipe realizou testes nas plataformas Terminal-Bench 2, SWE-Bench Pro e ProgramBench, utilizando GPT-5.5 com Codex. Em comparação com o método RHO anterior, a variante Heavy aumentou a porcentagem média de aprovação em 2,0 pontos percentuais e reduziu o custo médio da tarefa em 26,1%.

No Terminal-Bench 2, a porcentagem de aprovação aumentou de 76,3% para 80,8%, e o custo da tarefa caiu de US$ 1,09 para US$ 0,72. No SWE-Bench Pro, a variante Medium alcançou 79,0% de aprovação contra 80,0% do RHO, com um custo de US$ 1,26 por tarefa em vez de US$ 2,68.

O principal ganho de eficiência foi alcançado através do alinhamento dos esforços de raciocínio e orçamentos de ferramentas com cada tarefa, o que incentivou o agente a parar de explorar, bem como pela compressão de logs e instruções repetitivas. Os indicadores financeiros apresentados consideram apenas a execução das tarefas, excluindo os processos de busca e avaliação que as precederam.
Histórias semelhantes

AgiBot propõe métrica Worken para medir o trabalho de robôs com o objetivo de reduzir a proporção engenheiros-robôs para 1 para 10 até o final do ano
Leia mais
pandaily.com

AgiBot propõe métrica Worken para medir o trabalho de robôs com o objetivo de reduzir a proporção engenheiros-robôs para 1 para 10 até o final do ano

No evento Innovation Day 2026, realizado em 29 de outubro em Xangai, a AgiBot apresentou uma nova unidade de medida para avaliar a contribuição real dos robôs nos processos de trabalho. O cofundador, presidente e diretor técnico Peng Zhihui nomeou esta unidade Worken, que significa horas de trabalho inteligente e eficaz. Ele definiu Worken como o produto do número de robôs ativos pelas horas de trabalho autônomo e pelo coeficiente de eficiência de saída.

Peng enfatizou que o simples tempo de funcionamento de um robô não equivale a valor. Segundo ele, o fato de um robô estar ligado por oito horas não garante a criação de oito horas de valor, e uma alta taxa de sucesso na conclusão de uma tarefa não significa que ele possa operar com a mesma estabilidade que um humano durante um mês. O objetivo do Worken é responder à questão de qual trabalho sustentável e útil os robôs fornecem em condições reais, ao contrário das especificações demonstrativas.

A AgiBot compartilhou dados de três implementações. Quatro robôs que atendem visitantes no beco Quanzhai em Chengdu operaram por 310 horas e produziram 744 Workens. Oito robôs envolvidos em carregamento e descarregamento na linha de produção da fábrica Longcheer operaram por 528 horas e geraram 2956,8 Workens. No metrô de Guangzhou, 120 robôs que direcionam passageiros através da zona de segurança operaram por 240 horas e forneceram 14.400 Workens. Além disso, a empresa ainda não estabeleceu um padrão aceito para definir o coeficiente de eficiência, como contabilizar intervenção humana, manutenção ou inatividade.

Um aspecto importante foi a remoção de pessoas do ciclo de trabalho. Em setembro, a AgiBot instalou mais de 300 robôs em mais de 100 pontos do parque Chimelong Spaceship em Henan para realizar passeios, jogos como xadrez e tênis de mesa, bem como outros eventos para os visitantes. Atualmente, quase 500 robôs operam regularmente lá, e a empresa planeja aumentar esse número para 1000 até o final do ano.

O parceiro Wang Chuang observou que inicialmente quase cada robô exigia seu próprio engenheiro. Como as crianças interagiam com os robôs, violando as regras do jogo, a proporção robôs-engenheiros mudou de 1 para 1 para 3 para 1. O objetivo da empresa é atingir uma proporção de 10 para 1 até o final deste ano e de 20 para 1 no próximo ano. Com essa proporção, segundo ele, o cliente precisará apenas de cerca de 5% mais orçamento de pessoal para essa função.

Os líderes reconheceram as limitações existentes. Wang relatou que o novo modelo de interação WITA-OMNI ainda precisa ser aprimorado em termos de estabilidade e consistência ao trabalhar com grandes parques de robôs. O cofundador Yao Maoqing afirmou que o funcionamento estável e de longo prazo de mais de 10.000 robôs nas fábricas chinesas será um marco industrial chave. Peng acrescentou que os consumidores finais estão interessados não tanto na capacidade de construir um robô, mas se podem pagar sua operação. Sem um resultado mensurável e redução de custos operacionais, na opinião dele, cada robô vendido ainda exigirá seu supervisor.

Pesquisadores da Tsinghua, Infinigence AI e AgiBot treinaram 96 robôs com experiência coletiva
Leia mais
pandaily.com

Pesquisadores da Tsinghua, Infinigence AI e AgiBot treinaram 96 robôs com experiência coletiva

Pesquisadores da Universidade Tsinghua, Infinigence AI e AgiBot apresentaram uma abordagem de aprendizado chamada Aprendizagem de Experiência Coletiva (Collective Experience Learning, ou CEL). Este método permite que os robôs aprendam com os sucessos de outros robôs, em vez de depender predominantemente de demonstrações humanas.

De acordo com um comunicado publicado pela QbitAI em 30 de outubro, a equipe testou este método em um cluster de 96 robôs reais. O artigo científico correspondente está disponível no arXiv sob o número 2610.25736.

O problema original que os pesquisadores estão resolvendo está relacionado aos recursos de trabalho. Os robôs melhoram acumulando experiência prática, mas hoje isso é frequentemente alcançado através da repetição múltipla de movimentos por humanos ou intervenção do operador para corrigir erros. Embora centenas de robôs possam ser implantados, operadores qualificados não podem ser escalados na mesma velocidade.

Ao usar o CEL, a experiência bem-sucedida obtida por um robô é preservada e compartilhada, permitindo que um robô enfrentado a uma tarefa aprenda como seus colegas resolveram situações semelhantes.

Testes de Tarefas e Resultados

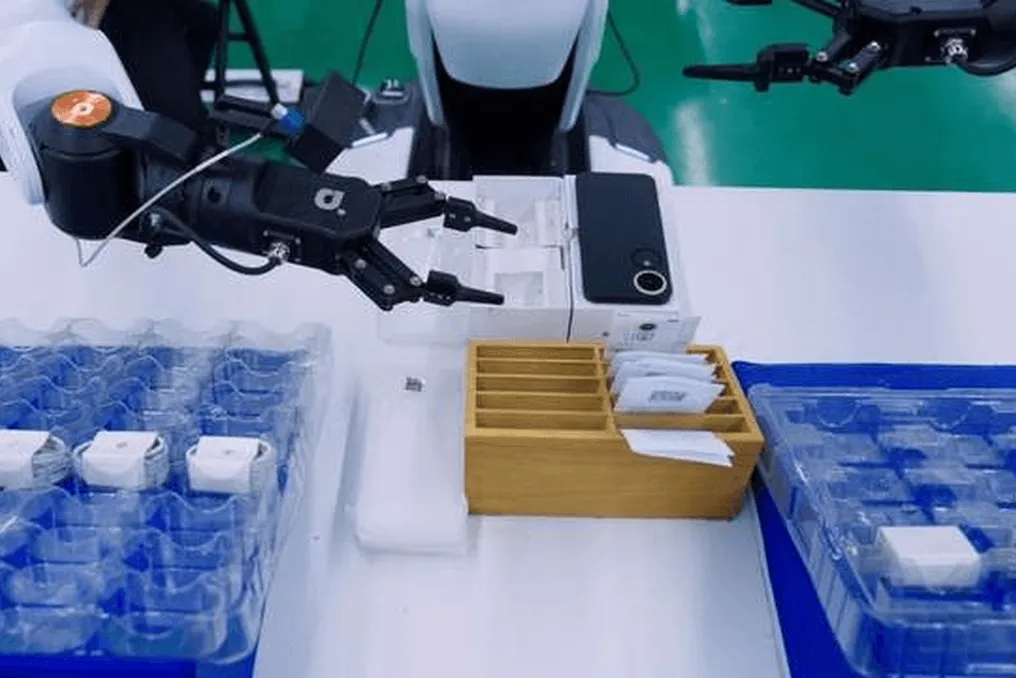
A equipe testou cinco tarefas diferentes, abrangendo tanto trabalhos domésticos quanto industriais: separar cores, dobrar roupas, carregar telefones, montar um banquinho e embalar telefones. Dois robôs que não participaram do treinamento realizaram 600 testes, cometendo 15 falhas, o que resultou em uma taxa geral de sucesso de 97,5%. A taxa de sucesso em todas as cinco tarefas excedeu a média de seis operadores humanos.

Em particular, no empacotamento de telefones, que é uma tarefa industrial multifásica, a taxa de sucesso aumentou de 79,2% para 98,3% após a aplicação do aprendizado coletivo, com apenas dois falhas registradas em 120 tentativas consecutivas.

Também foi observada uma tendência de escalabilidade: mantendo o mesmo volume de tempo real de treinamento, o aumento no número de robôs participantes de 16 para 96 elevou o sucesso de 86,7% para 98,3%.

Componentes Técnicos do Sistema

O funcionamento deste sistema é garantido por dois elementos chave. O primeiro é um sistema de aprendizado assíncrono tolerante a falhas chamado FATS. Este sistema é construído sobre a plataforma de aprendizado por reforço em larga escala RLinf. Os robôs carregam sua experiência imediatamente após a conclusão da tarefa, sem esperar pelos outros, e o cluster continua funcionando mesmo se os dispositivos forem desligados.

Durante o teste com 96 robôs, o cluster coletou 9.834 episódios. Vinte e dois robôs tiveram um total de 30 falhas, mas a perda de tempo dos robôs foi de apenas 1,3% do tempo total de operação.

O segundo componente é um algoritmo chamado ajuste fino de recuperação de experiência guiado por falhas (failure-guided experience retrieval fine-tuning, ou FERT). Uma manipulação pode durar minutos e incluir milhares de passos de ação, mas o feedback muitas vezes se resume apenas ao sucesso ou fracasso final. O FERT utiliza ambos esses aspectos: quando um robô encontra dificuldades, ele recupera experiências bem-sucedidas de situações semelhantes e foca o aprendizado especificamente nesses exemplos.

O comunicado foi fornecido pela Infinigence AI. Os resultados são apresentados pelo grupo de pesquisa e ainda não passaram por verificação independente.

DeepSeek Harness v0.2.2-alpha.2 permite que o agente principal delegue tarefas a ferramentas locais Codex e Claude Code
Leia mais
pandaily.com

DeepSeek Harness v0.2.2-alpha.2 permite que o agente principal delegue tarefas a ferramentas locais Codex e Claude Code

A DeepSeek lançou uma versão preliminar do DeepSeek Harness, seu software de código aberto para agentes, versão v0.2.2-alpha.2, que foi disponibilizada no GitHub em 28 de outubro. A principal novidade é um plugin experimental chamado subagent_oar, que permite ao agente principal delegar uma tarefa autônoma para instalar o Codex CLI ou o Claude Code na mesma máquina.

Anteriormente, o Harness suportava Claude Code e Codex; a atualização v0.1.0-rc.8 em agosto permitia aos usuários instalá-los como pacotes de perfil dentro de seu sistema subagent. No entanto, a nova ferramenta funciona de maneira diferente. Ela fornece ao agente principal um ponto de entrada unificado para distribuição de trabalho: ao chamar subagent_oar, o agente seleciona codex ou claude, e em seguida envia a descrição da tarefa, a solicitação completa e um diretório de trabalho opcional. A ferramenta retorna imediatamente um identificador de tarefa, e ao concluir o trabalho, uma notificação de conclusão traz a resposta final ou uma mensagem de erro de volta para a sessão principal.

As ferramentas externas operam de forma independente. O Codex CLI e o Claude Code mantêm suas próprias configurações, modelos, ferramentas e processo de login, portanto, os usuários devem instalá-los e autorizá-los em cada um, além de garantir que o host do Harness possa encontrá-los. Os parâmetros do provedor podem transmitir o modelo, o nível de raciocínio, os argumentos de inicialização, as variáveis de ambiente e o tempo limite, dependendo do suporte de cada runtime.

A documentação estabelece restrições claras: a conversa principal não é redirecionada, portanto, o pedido deve especificar explicitamente quais arquivos são importantes e o que deve ser retornado. As tarefas são descartáveis, sem possibilidade de perguntas subsequentes, reinício de sessão ou transmissão de progresso em tempo real. Apenas a resposta final ou falha é retornada, e não o raciocínio interno do agente externo ou o histórico de suas ferramentas. Exemplos oficiais permitem o uso de um espaço de trabalho gravável e desativam solicitações de permissão, e o cancelamento de uma tarefa não desfaz as alterações de arquivo que o agente externo já fez.

Outros complementos ajudam os usuários a rastrear o trabalho delegado. Um recurso experimental de solicitação de mudanças pode exibir o status e as diferenças de uma solicitação de mesclagem relacionada para uma sessão rodando em seu próprio diretório de trabalho Git. O plugin de estatísticas do desenvolvedor detalha o uso de contexto, cache, bem como o tempo gasto em modelos e ferramentas, em cada etapa e movimento. A saída de pequenas tarefas em segundo plano agora chega na notificação de conclusão, e o guia de espera do subagent reduz a necessidade de polling repetido.

O lançamento também permite que os usuários atualizem pacotes de plugins de terceiros, com a opção de reverter em caso de falha na atualização em tempo real, e adiciona texto de interface em japonês, espanhol, francês, alemão, russo e português brasileiro. Materiais comunitários anteriores, incluindo testes de configuração multiagente dos criadores do Bilibili, foram criados pelos próprios usuários e não são produtos da DeepSeek.

Popular