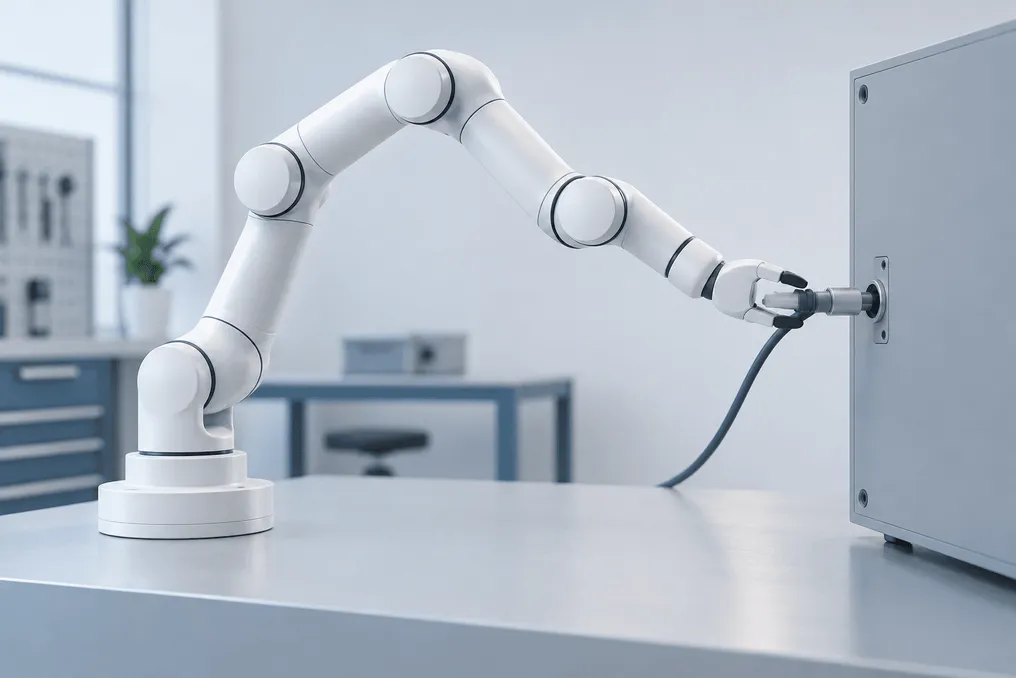
Dobot apresenta braço robótico VEGA 7 com sete eixos para IA incorporada e MTBF de 50.000 horas
Leia mais
Pandaily
pandaily.com

Dobot apresenta braço robótico VEGA 7 com sete eixos para IA incorporada e MTBF de 50.000 horas

A Dobot anunciou o lançamento do braço robótico DOBOT VEGA 7, que possui sete eixos e é projetado para controle de força, sendo originalmente concebido para as necessidades de inteligência artificial incorporada. A apresentação ocorreu em um evento no âmbito da Feira Industrial Internacional da China em Xangai, onde o produto é posicionado para uso com robôs móveis de dois braços, manipulação móvel em ambientes industriais e desenvolvimento de sistemas de IA incorporada.

A principal vantagem destacada pela Dobot é a durabilidade do dispositivo. A empresa afirma que o tempo médio entre falhas (MTBF) do modelo VEGA 7 é de 50.000 horas. O equipamento padrão inclui um freio eletromagnético em cada junta, permitindo que o braço mantenha sua postura e pare em 18 milissegundos em caso de perda súbita de energia. Além disso, o braço possui classificação IP54, garantindo proteção contra poeira e água.

Cada junta também é equipada com um sensor de torque, que suporta funções de detecção de contato, controle flexível, detecção de colisão e aprendizado por controle manual. A Dobot indica que a precisão do controle de força atinge 0,15 N ou melhor, a precisão do controle de torque é de 0,05 N·m ou melhor, e a resolução do controle de força é de 0,01 N·m ou melhor. Essas características permitem que o braço seja usado como plataforma para desenvolver e testar tarefas que exigem conexão e desconexão precisas, montagem de peças pequenas e coordenação de dois braços.

Os principais parâmetros técnicos incluem uma carga útil nominal de 7 kg, um raio de trabalho de 725 mm e repetibilidade dentro de ±0,03 mm. O sétimo eixo fornece redundância, permitindo que o braço alcance o mesmo ponto de diferentes maneiras, o que é particularmente útil quando o alvo está profundamente dentro do equipamento ou quando dois braços precisam operar em um espaço confinado. Os cabos passam por um grande espaço interno oco, e na extremidade do braço há duas interfaces de expansão que suportam EtherCAT, CAN e RS-485, com potência nominal de 3 A e potência de pico de 5 A para ferramentas.

A Dobot também observou que os sensores de torque podem ser úteis para coleta de dados. Ao gravar demonstrações de teleoperação ou operação real do robô, os sensores das juntas registram forças de contato juntamente com dados de movimento, fornecendo um sinal adicional para treinamento e depuração, além dos vídeos e dados de posição das juntas.

Na mesma apresentação, foram apresentados mais dois produtos: PULSA, que a Dobot promoveu com foco na velocidade, e um robô colaborativo CRH de alto desempenho, voltado para uma implementação mais simples em linhas de produção. No entanto, a empresa não divulgou a política de preços ou os prazos de entrega para o modelo VEGA 7.
Histórias semelhantes

Plataforma de teste VA-Bench da Universidade de Tecnologia de Dalian mostra que os melhores modelos multimodais completam apenas metade das tarefas de robótica
Leia mais
pandaily.com

Plataforma de teste VA-Bench da Universidade de Tecnologia de Dalian mostra que os melhores modelos multimodais completam apenas metade das tarefas de robótica

Um grupo de pesquisa da Universidade de Tecnologia de Dalian apresentou o VA-Bench, um novo benchmark projetado para testar a capacidade de grandes modelos de linguagem multimodais universais de converter informações visuais em ações bem-sucedidas de um braço robótico.

Entre as doze configurações testadas, o melhor modelo, Qwen3.8-max da Alibaba, conseguiu completar em média 53,93% das tarefas. Isso indica que os modelos capazes de 'entender' a cena ainda enfrentam dificuldades na execução confiável das ações correspondentes.

A descrição do benchmark foi publicada em um artigo no arXiv (2609.19554) e na publicação chinesa Sina Tech. O VA-Bench avalia o ciclo completo do processo: observação, raciocínio, ação e correção. Antes de cada teste, o modelo visualiza um vídeo de demonstração bem-sucedida, mas não recebe coordenadas de objetos, trajetórias de especialistas ou parâmetros de ação precisos.

Durante o teste, o modelo pode mudar os ângulos da câmera autonomamente, o que aumenta o número de passos de interação, e deve fornecer comandos específicos: deslocamentos em milímetros em cada eixo, ângulos de rotação e instruções para abrir ou fechar a garra. Um controlador fixo executa estritamente as instruções fornecidas pelo modelo.

Escopo e Estrutura do Teste

O benchmark abrange 14 tipos de tarefas de manipulação, incluindo 11 tarefas com um braço e três tarefas com dois braços. Cada tarefa inclui 20 cenas fisicamente verificadas em simulação de física, totalizando 280 cenas base. Além disso, foram adicionadas variações de geometria e layout, bem como um percurso com cinco objetos que exige uma execução prolongada. Cada configuração de modelo foi executada três vezes.

Os principais modelos alcançaram 100% de precisão na localização de alvos e 99,6%–100% na compreensão da manipulação necessária, mas o sucesso geral da tarefa permaneceu em cerca de metade. Os modelos Opus-5 e GPT-5.6-sol, apresentados no exterior, seguiram o Qwen3.8-max, mostrando resultados de 52,86% e 51,55%, respectivamente. Os autores observam que os três líderes estão dentro de 2,38 pontos percentuais e não fazem declarações sobre classificação confiável. A porcentagem de conclusão das subtarefas variou de 65,9% a 68,6%, indicando que muitos falhos ocorrem após progresso parcial. Todas as outras condições apresentaram um resultado de 23,10% ou inferior.

Principais Problemas Identificados

Foram identificadas duas lacunas principais. O Qwen3.8-max conseguiu detectar erros em 73,6% dos casos, mas corrigiu-os online apenas em 46,7% dos casos. Sua eficácia foi de 65,61% em tarefas de um braço, mas apenas 11,11% em tarefas de dois braços, que exigem a distribuição de objetos entre cada braço e a coordenação de sua disposição mútua.

A observação ativa mostrou ser um fator mais significativo do que a presença de câmeras adicionais. Em uma análise comparativa, o Qwen3.8-max obteve sucesso em 57,50% das 280 cenas quando escolhia os pontos de vista, em comparação com 27,86% quando lhe eram fornecidos cinco pontos de vista fixos. Além disso, todos os quatro modelos testados recusaram-se a participar do teste sem observação ativa.

A alteração na forma de objetos, contêineres ou no layout, mantendo a mesma tarefa, reduziu o sucesso de um dos modelos de referência em mais de 30 pontos — de 80,00% para 47,86%. Ao mesmo tempo, o Qwen3.8-max reduziu seu índice de 77,86% para 67,86%. No percurso de execução prolongada, o Qwen3.8-max posicionou 61 de 100 objetos, mas nenhum modelo concluiu um episódio rigoroso.

Este benchmark difere da classificação 'embodied brain' SuperCLUE, publicada esta semana, porque o VA-Bench mede se os julgamentos de percepção, raciocínio e planejamento levam a uma ação física bem-sucedida, ao contrário do SuperCLUE, que avalia esses aspectos em si.

Popular