कृत्रिम एजेंट अक्सर पायलट परीक्षण चरण में अच्छे परिणाम दिखाते हैं, क्योंकि ऐसी स्थितियों में अनुप्रयोग का क्षेत्र संकीर्ण होता है, डेटा नियंत्रित होता है और अनुरोध अनुमानित होते हैं। हालांकि, उत्पादन वातावरण अलग होता है, और यही अंतर कई परियोजनाओं को रोक देता है।
गार्टनर का अनुमान है कि 2027 के अंत तक एजेन्ट एआई परियोजनाओं में से 40% से अधिक बढ़ती लागतों, अनिश्चित व्यावसायिक मूल्य या अपर्याप्त जोखिम नियंत्रण के कारण रद्द कर दी जाएंगी। VeloDB में एशिया-प्रशांत क्षेत्र के क्षेत्रीय निदेशक नितिन वागुल्डे के अनुसार, समस्या का एक बड़ा हिस्सा मॉडल में नहीं, बल्कि डेटा के स्तर में निहित है।
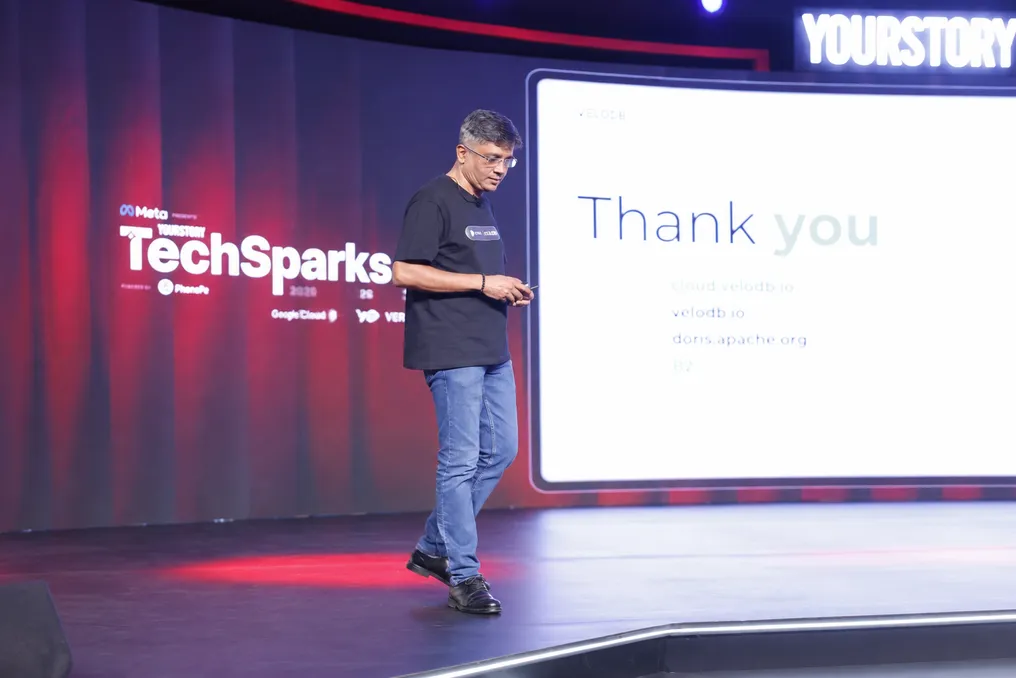
'स्केल पर एआई एजेंट: प्रदर्शन के बाद जीवित रहना' नामक अपने भाषण में, नितिन ने विस्तार से बताया कि एआई एजेंट मनुष्यों की तुलना में डेटा का उपयोग कैसे करते हैं, उन्हें बड़े पैमाने पर विश्वसनीय रूप से काम करने के लिए क्या आवश्यक है, और कंपनियां इन प्रणालियों का समर्थन करने के लिए अपनी डेटा इन्फ्रास्ट्रक्चर को कैसे पुनर्गठित कर रही हैं।
नितिन ने एक उदाहरण से शुरुआत की: पारंपरिक प्रणाली में, एक प्रबंधक तैयार रिपोर्ट चलाकर पिछले वर्ष की बिक्री का डेटा प्राप्त कर सकता था। स्थिति मौलिक रूप से बदल जाती है जब आप एआई एजेंट से पिछले तीन तिमाहियों में बिक्री में गिरावट की व्याख्या करने के लिए कहते हैं। एजेंट को ईआरपी और सीआरएम सिस्टम से ऑर्डर रिकॉर्ड निकालने, प्रमुख ग्राहकों की समस्याओं के लिए सपोर्ट टिकट और चैट का विश्लेषण करने, और क्षेत्रों की गतिशीलता पर बिक्री विभाग की रिपोर्ट का अध्ययन करने के लिए मजबूर होना पड़ता है। यदि उसकी धारणा अधूरी है, तो वह अतिरिक्त जानकारी के लिए वापस जाता है।
उन्होंने टिप्पणी की: 'जो पहले एक साधारण खोज या एक साधारण अनुरोध से पूरा हो जाता था, अब उसी जानकारी को प्राप्त करने के लिए सैकड़ों खोज संचालन की आवश्यकता होती है।' पहले व्यावसायिक डेटा के मुख्य उपभोक्ता लोग और रिपोर्ट थे, और सिस्टम स्पष्ट सीमाओं वाली निश्चित रिपोर्टों के आसपास बनाए गए थे।
अब, नितिन के अनुसार, एआई इन डेटा का नया ग्राहक बन गया है, और यह पूरी तरह से अलग तरीके से व्यवहार करता है। एजेंट चौबीसों घंटे काम करते हैं, एक साथ कई प्रश्न पूछते हैं और एक पुनरावृत्तीय चक्र में कार्य करते हैं: पूछना, सोचना, खोजना और उत्तर प्राप्त होने तक प्रयास दोहराना। उनके प्रश्न भी पहले से लिखे हुए नहीं होते हैं, जो डेटा परत पर एक मजबूत और अप्रत्याशित भार पैदा करता है।
जटिलता इस तथ्य से बढ़ जाती है कि व्यावसायिक डेटा कई स्थानों पर वितरित होता है: लेनदेन रिकॉर्ड, चैट मेमोरी, दस्तावेज़, डैशबोर्ड और अर्थपूर्ण खोज के लिए वेक्टर स्टोर। एजेंट को जवाब देने से पहले इन सभी स्रोतों में खोजना और परिणामों को संयोजित करना पड़ता है।
डेटा के प्रत्येक अतिरिक्त अनुरोध से लागत बढ़ती है। यदि डेटा पुराना है, तो उत्तर गलत होगा। नितिन ने इसकी तुलना गलत ट्रैफिक मानचित्र पर गाड़ी चलाने से की। इसके अलावा, जब डेटा कई स्रोतों से आता है, तो उत्तर के स्रोत की पहचान करना कठिन हो जाता है, जिससे विश्वास की समस्या उत्पन्न होती है।
उन्होंने इस स्थिति की तुलना किसी व्यक्ति को कागजात इकट्ठा करने के लिए पांच कार्ड कैटलॉग अलमारियों में भेजने से की। जब तक व्यक्ति पांचवीं अलमारी से लौटता है, पहली अलमारी से जानकारी पुरानी हो सकती है।
नितिन ने चार आवश्यकताओं को रेखांकित किया जिन्हें एजेंटों को पायलट मोड से पूर्ण संचालन में जाने के लिए पूरा करना चाहिए। VeloDB का उत्तर एक एकीकृत इंजन है जो इन सभी आवश्यकताओं को पूरा करता है। कंपनी की स्थापना 2023 में मूल Apache Doris डेवलपर्स द्वारा की गई थी, जो ओपन-सोर्स रियल-टाइम एनालिटिक्स डेटाबेस है, जो जून 2022 में Apache सॉफ्टवेयर फाउंडेशन की शीर्ष-स्तरीय परियोजना बन गया। VeloDB के आंकड़ों के अनुसार, Apache Doris को GitHub पर 14,000 से अधिक स्टार और 700 योगदानकर्ता प्राप्त हैं, और इसका उपयोग दुनिया भर में 5,000 से अधिक उद्यम करते हैं।
एजेंटों के काम को धीमा करने वाले वापस आने वाले अनुरोधों की संख्या को कम करने के लिए, VeloDB हाइब्रिड क्वेरी का समर्थन करता है। एक क्वेरी SQL, वेक्टर खोज और टेक्स्ट खोज को मिलाकर निर्धारित और संभाव्य खोजों को समानांतर में निष्पादित कर सकती है। परिणाम बिखरे हुए डेटा के बजाय एक एकल विश्वसनीय स्रोत होता है।
नितिन ने दो कंपनियों के उदाहरण प्रस्तुत किए जो इस आर्किटेक्चर का उपयोग अपने काम में करती हैं। पहला - 120 मिलियन से अधिक उपयोगकर्ताओं वाला एक प्रमुख क्रिप्टोकरेंसी एक्सचेंज, जिसका उन्होंने नाम नहीं लिया। एक्सचेंज एआई एजेंटों को लेनदेन डेटा प्रदान करता है, जिन्हें खुदरा निवेशक किसी विशेष संपत्ति पर बड़े व्यापारियों की स्थिति देखने के लिए अनुरोध कर सकते हैं। उन्होंने बताया कि उसके एजेंट चौबीसों घंटे काम करते हुए लगभग 3 मिलीसेकंड की अंतिम विलंबता के साथ लगभग 33,000 संवाद संसाधित करते हैं।
दूसरा उदाहरण - चीनी एआई कंपनी MiniMax है, जो जनवरी 2026 में हांगकांग स्टॉक एक्सचेंज में सूचीबद्ध हुई और 200 से अधिक देशों में 212 मिलियन उपयोगकर्ताओं को सेवा प्रदान करती है। MiniMax ने Grafana Loki को छोड़ने के बाद अपना लॉगिंग सिस्टम Apache Doris पर पुनर्निर्माण किया, क्योंकि लॉग सूचना का एक मूल्यवान स्रोत बन गए थे जिसे सहेजना और अनुरोध करना उचित था।
नितिन ने स्पष्ट किया कि MiniMax 10 जीबीपीएस की गति से डेटा लोड करती है और दो सेकंड से भी कम समय में लगभग 10 पेटाबाइट तक क्वेरी कर सकती है, साथ ही लागत में 70% की कमी लाती है। VeloDB ने विशेष रूप से बताया कि डोरिस पर आधारित सिस्टम अब पेटाबाइट पैमाने पर MiniMax के सभी व्यावसायिक क्षेत्रों में लॉग का समर्थन करता है जिसमें 99.9% से अधिक की उपलब्धता है।
नितिन ने जोड़ा कि ये समस्याएं शुरुआती चरण के स्टार्टअप्स के लिए भी प्रासंगिक हैं जो एजेंट बना रहे हैं। VeloDB फिनटेक स्टार्टअप्स के साथ सहयोग करता है जो MiniMax या क्रिप्टो एक्सचेंज जैसी ही स्केलिंग समस्याओं का सामना कर रहे हैं, बस एक शुरुआती चरण में।
उनका अंतिम तर्क यह था कि एजेंट हमेशा सैकड़ों प्रश्न पूछेंगे, इसलिए बुनियादी ढांचे को यह सुनिश्चित करना चाहिए कि उनमें से प्रत्येक सस्ता, तेज़ और वर्तमान हो। नितिन के लिए, एआई एजेंटों का स्केलिंग बेहतर मॉडल खोजने पर कम और एक ही स्रोत से एजेंटों को विश्वसनीय वास्तविक समय डेटा प्रदान करने पर अधिक निर्भर करता है। उनका तर्क था कि जो कंपनियां डेटा स्तर को सही ढंग से कॉन्फ़िगर करेंगी, वे तेजी से निर्णय ले पाएंगी, लागत कम कर पाएंगी और आत्मविश्वास के साथ अपने एजेंटों को पायलट मोड से परिचालन में स्थानांतरित कर पाएंगी।