npj अनकन्वेंशनल कंप्यूटिंग में 3 नवंबर को प्रकाशित एक लेख में, लेखकों ने आधुनिक एनालॉग कंप्यूटिंग की अवधारणा को परिभाषित किया है। 'डिफरेंशियल और मैट्रिक्स समीकरणों को हल करने के लिए आधुनिक एनालॉग कंप्यूटिंग' नामक यह कार्य बीजिंग विश्वविद्यालय के आर्टिफिशियल इंटेलिजेंस इंस्टीट्यूट और इंटीग्रेटेड सर्किट स्कूल से सुन चोंग के नेतृत्व में है। सह-लेखकों में मिलान पॉलिटेक्निक विश्वविद्यालय से पिएर्जियोलिओ माननोकी और अनकन्वेंशनल एआई, साथ ही ज्यूरिख में आईबीएम रिसर्च यूरोप से मैनुअल ले गैलो और अबू सेबेस्टियन शामिल हैं। इस बारे में QbitAI ने उसी दिन सूचित किया।
समीक्षा में तीन मुख्य तत्वों पर प्रकाश डाला गया है: विभेदक समीकरणों का समाधान, मैट्रिक्स समीकरणों का समाधान और मैट्रिक्स-वेक्टर गुणन का निष्पादन। ये तत्व ऑपरेटरों के एक सामान्य सेट का उपयोग करते हैं - समकलेषक (summers), गुणक (multipliers) और इंटीग्रेटर - और गणितीय रूप से जुड़े हुए हैं, क्योंकि असतत विभेदक समीकरण मैट्रिक्स समीकरणों में बदल जाते हैं जिन्हें या तो कई मैट्रिक्स गुणन द्वारा या बंद लूप वाले एनालॉग नेटवर्क का उपयोग करके एक ही चरण में हल किया जा सकता है। लेखक असतत घटकों से लेकर प्रतिरोधक मेमोरी और CMOS पर आधारित इंटीग्रेटेड सर्किट के कार्यान्वयन को ट्रैक करते हैं, साथ ही प्रयोज्यता, सटीकता, स्केलेबिलिटी, मेमोरी कंप्यूटिंग से संबंध और कम्प्यूटेशनल जटिलता पर भी चर्चा करते हैं।
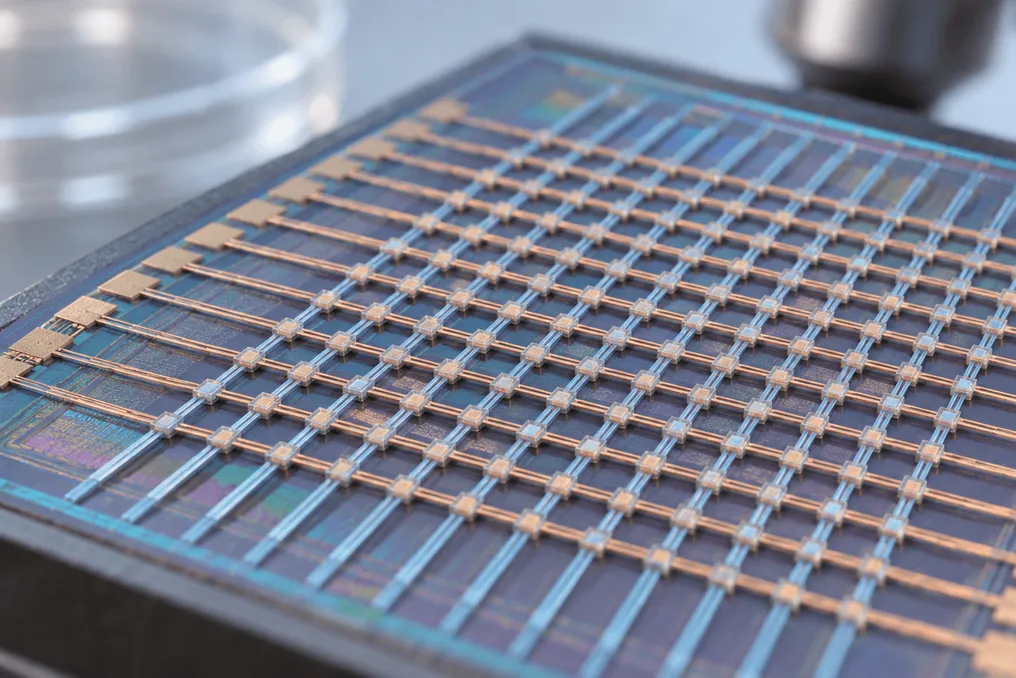
सुन के अनुसार, आधुनिक दृष्टिकोण तीन तरीकों से एनालॉग कंप्यूटरों से अलग है जिन्हें दशकों पहले डिजिटल चिप्स द्वारा विस्थापित कर दिया गया था। पहला, यह विशेष रूप से विभेदक समीकरणों के बजाय आर्टिफिशियल इंटेलिजेंस और वायरलेस संचार के क्षेत्र में मैट्रिक्स भार पर केंद्रित है। दूसरा, यह CMOS पर आधारित एनालॉग सर्किट के बजाय मेमरिस्टर्स जैसे प्रतिरोधक मेमोरी उपकरणों पर आधारित है। तीसरा, यह उच्च सटीकता और पैमाने को प्राप्त करने के लिए इंजीनियरिंग विधियों का उपयोग करता है।
इन उपकरणों के क्रॉसबार में, एक ऑपरेंड डिवाइस की चालकता के रूप में प्रोग्राम किया जाता है, और दूसरा वोल्टेज के रूप में लगाया जाता है; इस प्रकार, ओम का नियम प्रत्येक गुणन को पूरा करता है, और किरचॉफ का धारा नियम प्रत्येक स्तंभ को जोड़ता है। नतीजतन, 1000x1000 आकार की सरणी में दस लाख गुणक होते हैं, जबकि सुन द्वारा उल्लिखित 2016 का CMOS आधारित एनालॉग चिप केवल चार इंटीग्रेटर और आठ गुणक रखता था। ऑपरेशनल एम्पलीफायर का उपयोग करके फीडबैक जोड़ने से सर्किट को नैनोसेकंड में मैट्रिक्स समीकरण को हल करने में मदद मिलती है।
यह समीक्षा सुन के पिछले कार्यों पर आधारित है। 2019 में, उनकी टीम ने PNAS पत्रिका में एक प्रतिरोधक सरणी 3x3 पर एक ही चरण में मैट्रिक्स समीकरण को हल करने का प्रदर्शन किया, जिसमें लगभग 3% की त्रुटि थी। नेचर इलेक्ट्रॉनिक्स 2025 के लेख में एक निश्चित सटीकता 24 बिट प्राप्त करने के लिए डिवाइस पर आठ चालकता अवस्थाओं के साथ बिट स्लाइसिंग का उपयोग किया गया था, जिससे तीन पुनरावृत्तियों के बाद सापेक्ष त्रुटि $10^{-4}$ तक कम हो गई, और फिर $10^{-7}$ तक, जो FP32 के तुलनीय है, और ब्लॉक एल्गोरिथम का उपयोग करके 512x512 मैट्रिसेस तक बढ़ाया गया। टीम के अपने अनुमानों के अनुसार, थ्रूपुट लगभग 1000 गुना और ऊर्जा दक्षता Nvidia H100 कोर और FP32 सटीकता वाले डिजिटल ASIC की तुलना में लगभग 100 गुना अधिक थी। इन मेट्रिक्स का अभी तक स्वतंत्र सत्यापन नहीं हुआ है।
चर्चा किए गए अनुप्रयोगों में वास्तविक समय में रोबोट गति नियंत्रण, 6G के लिए मैसिव MIMO सिग्नल डिटेक्शन और बड़ी मॉडलों के प्रशिक्षण के लिए द्वितीय क्रम अनुकूलन शामिल हैं।