SenseTime ने गहन प्रोसेसिंग के लिए लेयर रीयूज़ का उपयोग करने वाला 9 बिलियन पैरामीटर वाला आर्टिफिशियल इंटेलिजेंस मॉडल जारी किया
और पढ़ें
TechNode
technode.com

SenseTime ने गहन प्रोसेसिंग के लिए लेयर रीयूज़ का उपयोग करने वाला 9 बिलियन पैरामीटर वाला आर्टिफिशियल इंटेलिजेंस मॉडल जारी किया

SenseTime ने SenseNova Loop-9B-Preview, एक मल्टीमॉडल, ओपन-सोर्स मॉडल प्रस्तुत किया है। यह मॉडल संबंधित मॉडल भारों को दोहराए बिना प्रोसेसिंग की गहराई बढ़ाने के लिए पुनर्गणना विधि का उपयोग करता है। इस रिलीज़ की घोषणा 30 अक्टूबर को की गई थी।

यह मॉडल पाठ और ग्राफिक दोनों डेटा इनपुट के रूप में स्वीकार कर सकता है, और दस्तावेज़ समझ, कोड लेखन और बाहरी उपकरणों के उपयोग से संबंधित कार्यों को पूरा करने के लिए पाठ उत्पन्न कर सकता है।

यह सामान्य ब्लॉक के दोहरे पास के माध्यम से कार्य करता है जिसमें 24 डिकोडर परतें होती हैं, जिससे लगभग नौ अरब मापदंडों वाले मूल मॉडल के आधार पर अधिक गहरा कम्प्यूटेशनल पथ बनाया जा सकता है।

दस्तावेज़ीकरण प्रशिक्षण सेटअप 262,144 टोकन तक की लंबाई वाली अनुक्रमों का समर्थन करता है और पाठ, छवियों, कोड और उपकरण उपयोग सहित उदाहरणों को जोड़ता है। SenseTime ने मॉडल भार, इन्फेरेंस निर्देश और प्रशिक्षण गाइड प्रकाशित किए हैं, और परियोजना को Apache 2.0 लाइसेंस के तहत वितरित किया है।

समान कहानियाँ

MemTensor ने लंबी कहानियों को सहेजने के लिए मेमोरी के साथ MemT 1.0 का ओपन मॉडल जारी किया
और पढ़ें
pandaily.com

MemTensor ने लंबी कहानियों को सहेजने के लिए मेमोरी के साथ MemT 1.0 का ओपन मॉडल जारी किया

चीनी कंपनी MemTensor ने मेमोरी-आधारित मौलिक मॉडलों की एक श्रृंखला प्रस्तुत की और उसे सार्वजनिक रूप से उपलब्ध कराया, जिसे उन्होंने MemT 1.0 नाम दिया। इस श्रृंखला में दो मॉडल शामिल हैं: MemT-1.0-Flash, जिसमें कुल 288 अरब पैरामीटर हैं जिनमें से सक्रिय रूप से 17 अरब का उपयोग किया जाता है, और MemT-1.0-Nano, जिसमें 36 अरब कुल पैरामीटर और 3 अरब सक्रिय पैरामीटर हैं।

इन मॉडलों के वज़न Hugging Face प्लेटफॉर्म पर उपलब्ध हैं, और संबंधित कोड तकनीकी रिपोर्ट के साथ GitHub पर रखा गया है।

ये मॉडल लंबे संवादों से जुड़ी एक सामान्य समस्या को हल करने के लिए विकसित किए गए हैं। अधिकांश मौजूदा सिस्टम पूरी कहानी को संदर्भ विंडो में संग्रहीत करते हैं, जिससे हर नई चाल के साथ धीमापन और इन्फेरेंस की लागत बढ़ जाती है। इसके बजाय, MemT मॉडल के भीतर एक प्रशिक्षित मेमोरी मॉड्यूल को एकीकृत करता है।

प्रत्येक इंटरैक्शन के बाद, मॉडल नई जानकारी को एक निश्चित मेमोरी स्थिति में लिखता है और आवश्यकता पड़ने पर उसे पुनर्प्राप्त करता है, बजाय इसके कि वह हर बार पूरे पिछले रिकॉर्ड को फिर से पढ़े।

MemTensor बताता है कि मॉडलों को 34 अरब टोकन के आधार पर दो चरणों में प्रशिक्षित किया गया था: पहले मॉडल को मेमोरी में जानकारी लिखना सिखाया गया, और फिर उसे इस संग्रहीत जानकारी का उपयोग करके सवालों का जवाब देना सिखाया गया।

प्रदर्शन परिणाम और तुलना

सभी प्रस्तुत प्रदर्शन मेट्रिक्स कंपनी के स्वयं के मूल्यांकन पर आधारित हैं। MemTensor का दावा है कि 128 हजार टोकन की कहानी के साथ एंड-टू-एंड इन्फेरेंस पूर्ण संदर्भ दृष्टिकोण की तुलना में लगभग 1.86 गुना तेज काम करता है, और 256 हजार टोकन के साथ लगभग 3.99 गुना तेज काम करता है।

पहले टोकन के प्रतिक्रिया समय का अनुमान मेमोरी मॉडल के लिए लगभग 104-112 मिलीसेकंड है, जबकि 256K के लिए पूर्ण संदर्भ के लिए यह लगभग 445 मिलीसेकंड है। इसके अलावा, कंपनी बताती है कि 256K की कहानी के साथ प्रति सत्र मेमोरी स्थिति का आकार लगभग 40 एमबी है, जो पूर्ण संदर्भ कैश के लिए आवश्यक 5.06 जीबी से काफी कम है, जो लगभग 130 गुना कमी दर्शाता है।

मेमोरी पर 11 बेंचमार्क पर, MemTensor फ्लैश के लिए 50.6 और नैनो के लिए 47.0 का औसत स्कोर बताता है। ये परिणाम मॉडलों को तुलनात्मक पैरामीट्रिक मेमोरी तरीकों में पहले और दूसरे स्थान पर रखते हैं और औसतन खोज-वर्धित दृष्टिकोणों (retrieval-augmented approaches) के परिणामों के अनुरूप हैं, भले ही क्वेरी के दौरान इतिहास को पुनर्प्राप्त न किया जाए।

कंपनी इस बात पर भी जोर देती है कि मेमोरी जोड़ने से बड़े व्यवधान वाले परीक्षणों में फ्लैश मॉडल की समग्र क्षमताओं में कोई गिरावट नहीं आई है।

डेवलपर्स को लाइसेंसिंग शर्तों पर ध्यान देना चाहिए: रिपॉजिटरी कोड गैर-व्यावसायिक PolyForm लाइसेंस के तहत प्रकाशित किया गया है, जबकि मॉडल वज़न क्रमशः Apache और MIT लाइसेंस के तहत हैं।

टीम दीर्घकालिक स्मृति में सुधार, मेमोरी क्षमता बढ़ाने और मेमोरी अपडेट की लागत कम करने की दिशा में आगे विकास की योजना बना रही है, जिसका दीर्घकालिक लक्ष्य ऐसे एजेंट बनाना है जो अपनी बातचीत के आधार पर सीखते रहें।

DeepSeek ने AI मॉडल के निष्पादन को तेज और अनुकूलित करने के लिए DeepInfer कोड जारी किया
और पढ़ें
olhardigital.com.br

DeepSeek ने AI मॉडल के निष्पादन को तेज और अनुकूलित करने के लिए DeepInfer कोड जारी किया

पिछले मंगलवार (20) को, DeepSeek ने DeepInfer का कोड सार्वजनिक किया, जो उसके आर्टिफिशियल इंटेलिजेंस (AI) मॉडल चलाने के लिए डिज़ाइन किया गया एक सॉफ्टवेयर है। इस टूल को प्रोसेसिंग की दक्षता में सुधार करने और प्रतिक्रियाएँ उत्पन्न करने के लिए आवश्यक समय को कम करने के उद्देश्य से बनाया गया था।

कोड जारी होने के साथ, डेवलपर्स और निगमों को कार्यक्रम के कामकाज का विश्लेषण करने और इसे विभिन्न परियोजनाओं में अनुकूलित करने की संभावना है, बशर्ते वे तकनीकी आवश्यकताओं और स्थापित उपयोग की शर्तों का पालन करें। DeepSeek के अनुसार, यह कदम ऊर्जा और कम्प्यूटेशनल संसाधनों की खपत को कम करने और AI मॉडल के संचालन को अधिक कुशल बनाने पर केंद्रित है। हालांकि, व्यावहारिक परिणाम उपयोग की स्थितियों और उपलब्ध बुनियादी ढांचे पर निर्भर करेंगे।

वर्तमान में, DeepInfer विशेष रूप से DeepSeek-V4.1-Flash मॉडल के साथ संगत है। हालांकि कोड खोलने से अन्य डेवलपर्स को तकनीक की जांच करने और उसका उपयोग करने की अनुमति मिलती है, यह ध्यान रखना महत्वपूर्ण है कि कंपनी की निष्पादन प्रणाली का पूरा हिस्सा सार्वजनिक नहीं किया गया है, क्योंकि बुनियादी ढांचे के कुछ घटक बंद बने हुए हैं।

ओलहार डिजिटल न्यूज़ कार्यक्रम में भाग लेते हुए, मशीन लर्निंग विशेषज्ञ रॉबर्ट 'पेना' स्पिनेली ने इस नई बात पर टिप्पणी की। शोधकर्ता ने AI मॉडल उपलब्ध कराने और उसे चलाने के लिए जिम्मेदार सॉफ्टवेयर जारी करने के बीच अंतर स्पष्ट किया। इस अंतर को समझाने के लिए, उन्होंने एक कार के उदाहरण का उपयोग किया।

पेना ने विस्तार से बताया कि केवल मॉडल साझा करना उसे प्रभावी ढंग से संचालित करने के लिए आवश्यक सभी उपकरण प्रदान करने के बराबर नहीं है। जबकि मॉडल प्रतिक्रियाओं के निर्माण का मार्गदर्शन करने वाले मापदंडों को वहन करता है, इन्फेरेंस सॉफ्टवेयर उन तंत्रों को समूहित करता है जो इसके कार्य करने में सक्षम बनाते हैं। इस कोड को खोलने से उन डेवलपर्स की मदद मिल सकती है जो अपने स्वयं के समाधान लागू करने की योजना बना रहे हैं।

विशेषज्ञ ने स्थिति की तुलना करते हुए कहा: 'पहले, वे केवल इंजन का ब्लूप्रिंट साझा करते थे, जो वास्तव में कृत्रिम बुद्धिमत्ता है। अब वे पूरी कार के संचालन को दे रहे हैं। सारा सॉफ्टवेयर और वह तंत्र जिससे वे कृत्रिम बुद्धिमत्ता चलाते हैं, जनता के लिए जारी किया गया है।'

यह तुलना दोनों तत्वों के बीच के अंतर को समझने में मदद करती है, लेकिन एक चेतावनी है: DeepInfer की उपलब्धता का मतलब यह नहीं है कि DeepSeek के बुनियादी ढांचे के सभी तत्व सुलभ हैं। फिर भी, कोड तक पहुंच प्रोग्रामर और शोधकर्ताओं को कंपनी द्वारा अपनाई गई निष्पादन पद्धतियों का अध्ययन करने और यह मूल्यांकन करने की अनुमति देती है कि उन्हें अन्य कार्यों में कैसे लागू किया जाए।

यह पहल DeepSeek की व्यावसायिक रणनीति को भी लाभ पहुंचा सकती है। अपनी तकनीक के हिस्से को साझा करके, कंपनी अन्य डेवलपर्स के लिए रास्ते खोलती है ताकि वे इसका उपयोग कर सकें, सुधारों में योगदान दे सकें और संगत एप्लिकेशन बना सकें। यह अपनाना एक अत्यधिक प्रतिस्पर्धी बाजार में उसकी तकनीक की पहुंच का विस्तार कर सकता है, जहां कई कंपनियां अधिक सुलभ और कुशल मॉडल प्रदान करने के लिए प्रतिस्पर्धा करती हैं।

पेना ने जोड़ा: 'DeepSeek एक ऐसा पारिस्थितिकी तंत्र बनाना चाहती है ताकि अधिक लोग और कंपनियां उनके उत्पादों का उपयोग करें।' उन्होंने आगे कहा: 'पूरी संरचना को कैसे स्थापित किया जाए, यह दिखाकर, यह जनता को अधिक महंगे भुगतान किए गए प्लेटफार्मों को छोड़ने के लिए प्रोत्साहित करता है। यह एक अत्यंत प्रतिस्पर्धी क्षेत्र में खुद को स्थापित करने का एक सुसंगत तरीका है।'

DeepInfer का जारी होना इस बात पर जोर देता है कि AI के क्षेत्र में प्रतिस्पर्धा केवल प्रतिक्रियाएँ उत्पन्न करने की क्षमता तक ही सीमित नहीं है, बल्कि उन्हें निष्पादित करने के लिए आवश्यक दक्षता तक भी सीमित है। अपनी तकनीक के हिस्से को साझा करके, DeepSeek सॉफ्टवेयर के उपयोग के विकल्पों को बढ़ाती है और क्षेत्र में अपनी स्थिति मजबूत करती है। इस उपाय का प्रभाव, अन्य कारकों के अलावा, विभिन्न वातावरणों में प्राप्त प्रदर्शन और डेवलपर्स और कंपनियों की भागीदारी पर निर्भर करेगा।
VAST ने सरल गेम फ्रेम को विस्तृत वीडियो में रेंडर करने के लिए EdenLive मॉडल जारी किया
और पढ़ें
pandaily.com

VAST ने सरल गेम फ्रेम को विस्तृत वीडियो में रेंडर करने के लिए EdenLive मॉडल जारी किया

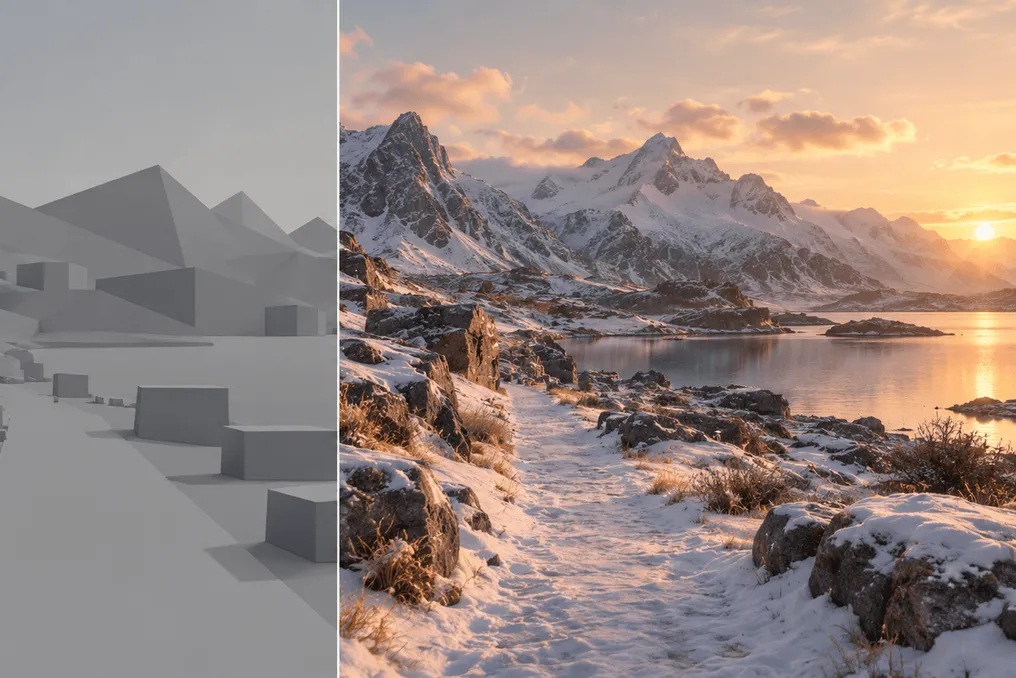
VAST, जो 3डी में जेनरेटिव एआई में विशेषज्ञता रखता है और Tripo प्लेटफॉर्म के पीछे है, ने EdenLive मॉडल को सार्वजनिक कर दिया है। यह मॉडल वास्तविक समय में काम करता है और सरलीकृत गेम फ्रेम या मौजूदा वीडियो को लेता है, उन्हें चुने हुए शैली में विस्तृत छवियों में लगातार फिर से प्रस्तुत करता है, जो फोटो-यथार्थवादी से लेकर एनीमे तक भिन्न हो सकती है।

इस रिलीज़ में 5B और 14B आकार के मॉडल वेट्स, वास्तविक समय इन्फेरेंस के लिए कोड, एक तकनीकी रिपोर्ट और एंड-टू-एंड डेमो शामिल हैं। यह ध्यान रखना महत्वपूर्ण है कि EdenLive स्वयं दुनिया का अनुकरण नहीं करता है; इसके बजाय, एक उच्च-स्तरीय प्रोग्राम, जैसे गेम इंजन या कोडिंग एजेंट द्वारा लिखा गया कोड, नियमों का पालन करने, दुनिया की स्थिति को ट्रैक करने और एक मोटे संदर्भ वीडियो को आउटपुट करने के लिए जिम्मेदार होता है।

इस संदर्भ वीडियो को प्राप्त करने के बाद, EdenLive निर्दिष्ट पहले फ्रेम और टेक्स्ट प्रॉम्प्ट का मार्गदर्शन करते हुए रेंडरिंग करता है। VAST का तर्क है कि इस अलगाव से गेम लॉजिक को स्पष्ट और परीक्षण योग्य बनाए रखने की अनुमति मिलती है, जबकि वास्तविक समय में मॉडल की सीमित क्षमताओं को पूरी तरह से बाहरी रूप पर केंद्रित किया जाता है।

इस दृष्टिकोण को पहली बार जून में प्रोजेक्ट ईडन नामक एक बड़े विश्व अनुसंधान के हिस्से के रूप में प्रस्तुत किया गया था। VAST के बयानों के अनुसार, 5B मॉडल एक Nvidia RTX 5090 पर 720p रिज़ॉल्यूशन पर 24 फ्रेम प्रति सेकंड से अधिक की दर पर काम कर सकता है। GitHub पर README फ़ाइल में, लाइटएक्स2V इन्फेरेंस फ्रेमवर्क से त्वरण का उपयोग करते हुए, 1280x704 पिक्सेल रिज़ॉल्यूशन पर लगभग 24.7 FPS के रूप में यह संख्या बताई गई है।

तकनीकी रिपोर्ट एक ही H100 पर समान रिज़ॉल्यूशन पर 29.8 FPS और आठ H100 पर 14B मॉडल के लिए 832x480 रिज़ॉल्यूशन पर 26.8 FPS का आंकड़ा बताती है। VAST का दावा है कि उपयोगकर्ता इनपुट से संबंधित फ्रेम तक कुल विलंबता कुछ सौ मिलीसेकंड है, और सिस्टम कई मिनटों तक लगातार सामग्री उत्पन्न कर सकता है।

दोनों मॉडल Wan2.2-TI2V-5B और Wan2.1-I2V-14B वीडियो मॉडल पर आधारित हैं। इन्फेरेंस कोड और मुख्य डिफ्यूजन, VAE और डिकोडर वेट Apache 2.0 लाइसेंस के तहत वितरित किए जाते हैं, हालांकि सभी घटक इस लाइसेंस के अंतर्गत नहीं आते हैं। विज़ुअल एन्कोडर DINOv3 लाइसेंस का उपयोग करता है, और अनुरोध से गेम तक कार्यक्षेत्र में उपयोग की जाने वाली छवि मॉडल गैर-व्यावसायिक FLUX लाइसेंस के तहत है, जो इस कार्यक्षेत्र के गैर-व्यावसायिक उद्देश्यों के लिए उपयोग को प्रतिबंधित करता है।

VAST ने Game Prototype Turbo भी पेश किया है - एक कौशल जो टेक्स्ट प्रॉम्प्ट को एक मोटे खेलने योग्य गेम में बदल देता है जिसे EdenLive फिर रेंडर कर सकता है। VAST के प्रदर्शनों में एक प्लेटफॉर्मर शामिल है जहां चरित्र आधार बिंदु बनाने के लिए लावा को जमाता है, एक दो-खिलाड़ी फाइटिंग गेम जिसमें स्वास्थ्य बार और राउंड टाइमर को उच्च-स्तरीय प्रणाली द्वारा ट्रैक किया जाता है, और एक वीडियो रेंडरिंग जो नीली पृष्ठभूमि पर फिल्माए गए व्यक्ति को कार्टून चरित्र में बदल देती है। इसके अलावा, मॉडल एम्बोडेड एआई के लिए अतिरिक्त प्रशिक्षण डेटा बनाने हेतु फुटेज में मानव हाथों को रोबोटिक हाथों से बदलने का प्रदर्शन करता है।

VAST отмечает कि वर्तमान में EdenLive कम आवृत्ति की बातचीत के लिए सबसे उपयुक्त है, जैसे दृश्यों का निरीक्षण करना और बक्से धकेलने वाले पहेलियाँ। तेज़, गहन गेमप्ले, कई पात्रों की स्थिरता बनाए रखना, छोटी वस्तुओं पर सूक्ष्म नियंत्रण और लंबी सत्रों में दृश्य स्थिरता अभी भी सुधार की मांग करती है।

लोकप्रिय