Meituan ने 1.6 ट्रिलियन पैरामीटर वाला लॉन्ग-हॉरिजन एजेंट कोडिंग के लिए मल्टीमॉडल LongCat-2.5 जारी किया
और पढ़ें
Pandaily
pandaily.com

Meituan ने 1.6 ट्रिलियन पैरामीटर वाला लॉन्ग-हॉरिजन एजेंट कोडिंग के लिए मल्टीमॉडल LongCat-2.5 जारी किया

Meituan की LongCat टीम ने 2 नवंबर को LongCat-2.5 मॉडल प्रस्तुत किया। यह मॉडल एक मूल मल्टीमॉडल सिस्टम है जिसे लंबी अवधि के एजेंट कार्यों को पूरा करने के लिए विकसित किया गया है। आईटी होम की रिपोर्ट के अनुसार, इस मॉडल में कुल 1.6 ट्रिलियन पैरामीटर हैं और प्रत्येक टोकन को संसाधित करते समय लगभग 48 बिलियन सक्रिय होते हैं।

LongCat-2.5 पिछले संस्करण LongCat-2.0 पर आधारित है और दो प्रमुख पहलुओं में काफी सुधार करता है: विज़ुअल डेटा की मूल समझ और एजेंट कोडिंग की क्षमता। आधिकारिक रिलीज़ 25 सितंबर से LongCat API प्लेटफॉर्म पर उपलब्ध प्रारंभिक संस्करण LongCat-2.5-Preview के बाद हुई।

प्रशिक्षण और कार्य हैंडलिंग में सुधार

प्रशिक्षण प्रक्रिया का अधिकांश भाग लंबी अवधि के कार्यों पर केंद्रित था। Meituan ने बताया कि उन्होंने लंबी अनुक्रमों के प्रशिक्षण में अधिक लंबी-अवधि के ट्रैजेक्टरी डेटा जोड़े हैं और एंड-टू-एंड इंजीनियरिंग कार्य को बेहतर बनाने के लिए लॉन्ग-हॉरिजन रीइन्फोर्समेंट लर्निंग का उपयोग किया है। इसमें जटिल कोडबेस के भीतर विकास और पूर्ण परियोजनाओं का निर्माण शामिल है।

टीम डेटा संश्लेषण का विस्तार करना, वातावरण बनाना और विभिन्न एजेंट तंत्रों में मिश्रित प्रशिक्षण करना जारी रखे हुए है। इसके अलावा, वे वास्तविक एजेंट विफलताओं की ट्रैजेक्टरी को पुनरुत्पादनीय और सत्यापन योग्य कार्यों में बदल रहे हैं ताकि उन क्षेत्रों में डेटाबेस को लगातार बढ़ाया जा सके जहां मॉडल कमजोर प्रदर्शन दिखाता है।

विज़ुअल अंडरस्टैंडिंग और इंफ्रास्ट्रक्चर

छवि प्रसंस्करण के दृष्टिकोण से, LongCat-2.5 दृश्य संकेतों को बहु-स्तरीय असतत टोकन के रूप में प्रस्तुत करता है। इसके कारण, मॉडल का मुख्य भाग छवियों और पाठ को एक एकीकृत टोकनाइज्ड रूप में संसाधित करता है। Meituan का दावा है कि इस मूल दृष्टि को एजेंट कोडिंग के साथ जोड़ना मॉडल को विज़ुअल कोडिंग के क्षेत्र में मजबूत बनाता है, जिससे यह रचनात्मक डिजाइन और 3डी कार्यों से निपट सकता है।

मॉडल की रिलीज़ को सक्षम करने वाला बुनियादी ढांचा घरेलू कंप्यूटिंग क्षमताओं पर काम करता है। Meituan ने आंतरिक चिप्स पर लॉन्ग कॉन्टेक्स्ट ट्रेनिंग और W4A4 इन्फेरेंस को अनुकूलित किया है, जो 4-बिट वेट्स और 4-बिट एक्टिवेशन का उपयोग करता है। प्रशिक्षण और इन्फेरेंस के बीच संख्यात्मक संरेखण पर काम करना, और लॉन्ग कॉन्टेक्स्ट परिनियोजन का अनुकूलन, लॉन्ग-हॉरिजन रीइन्फोर्समेंट लर्निंग के कुशल संचालन को सुनिश्चित करता है।

परीक्षण परिणाम और उपलब्धता

Meituan द्वारा प्रस्तुत बेंचमार्क तालिका के अनुसार, LongCat-2.5 ने Terminal Bench v2.1 पर 88.4 का परिणाम दिखाया, जो LongCat-2.0 के 70.8 से अधिक है, और AutomationBench पर 51.8 बनाम 15.8 प्राप्त किया। मॉडल ने BrowseComp पर 91.9, PaperBench पर 82.1, 3DCodeBench पर 55.4 और Vision2Web पर 78.6 भी हासिल किया। अन्य प्रयोगशालाओं के अत्याधुनिक मॉडलों से तुलना करने पर, LongCat-2.5 सभी परीक्षणों में पहला स्थान नहीं रखता है; उदाहरण के लिए, प्रोग्राम बेंच पर यह सर्वश्रेष्ठ प्रतियोगी के 37 की तुलना में 25.5 प्राप्त करता है। यह ध्यान रखना महत्वपूर्ण है कि ये आंकड़े अभी तक स्वतंत्र रूप से सत्यापित नहीं किए गए हैं।

LongCat के चेंज लॉग में उल्लेख किया गया है कि मॉडल Claude Code, Codex, Hermes और अन्य मुख्य तंत्रों के साथ संगत है, और प्लेटफॉर्म का दस्तावेज़ीकरण OpenCode, Cline, Kilo Code, CodeBuddy और WorkBuddy जैसे उपकरणों को कॉन्फ़िगर करने के लिए दिशानिर्देश प्रदान करता है। LongCat-2.5 longcat.chat और LongCat API पर उपलब्ध है, जबकि Meituan ने GitHub और Hugging Face पर जल्द ही रिलीज़ की घोषणा की है।

समान कहानियाँ

शेंगशु मोटुब्रेन 2.0 मॉडल जारी करने से पहले प्रशिक्षण प्रक्रिया का प्रसारण कर रहा है
और पढ़ें
pandaily.com

शेंगशु मोटुब्रेन 2.0 मॉडल जारी करने से पहले प्रशिक्षण प्रक्रिया का प्रसारण कर रहा है

शेंगशु टेक्नोलॉजी की ग्लोबल मॉडल्स टीम ने रोबोटों के लिए अपने एम्बोडीड आर्टिफिशियल इंटेलिजेंस मॉडल के अगले संस्करण, मोटुब्रेन 2.0 के पूर्ण प्रशिक्षण प्रक्रिया का सीधा प्रसारण शुरू किया है। यह प्रसारण 21 अक्टूबर को शुरू हुआ और लगभग दो सप्ताह तक चलने की योजना है।

कंपनी ने बताया कि मोटुब्रेन 2.0 जल्द ही सार्वजनिक रूप से जारी किया जाएगा, और इस रिलीज़ से पहले प्रशिक्षण प्रक्रिया का प्रदर्शन करने का निर्णय लिया है।

मोटुब्रेन मॉडल शेंगशु के रोबोट फंडामेंटल मॉडल परिवार का हिस्सा हैं, जिसका उद्देश्य रोबोटों को एक सार्वभौमिक मस्तिष्क प्रदान करना है जो विभिन्न कार्यों, परिदृश्यों और विभिन्न प्रकार के रोबोटों पर कौशल लागू कर सके। मोटुब्रेन का पहला संस्करण अप्रैल में एक वैश्विक मॉडल के रूप में प्रस्तुत किया गया था। यह ध्यान रखना महत्वपूर्ण है कि शेंगशु अपने वीडियो जनरेशन मॉडल विडू (Vidu) के लिए अधिक प्रसिद्ध है।

प्रसारण की संरचना

सीधा प्रसारण चार चरणों में विभाजित है। प्री-ट्रेनिंग चरण यह जांचता है कि प्रशिक्षण का पैमाना शून्य-शॉट स्थितियों में प्रदर्शन और सामान्यीकरण क्षमता को कैसे प्रभावित करता है। बाद का प्रशिक्षण सुधार के लिए विशिष्ट कार्यों को पूरा करने पर केंद्रित है। इसके बाद एजेंट टास्क चरण आता है, जो जांचता है कि क्या मॉडल प्राप्त ज्ञान को अन्य कार्यों पर स्थानांतरित कर सकता है। अंतिम चरण पुनरावर्ती आत्म-सुधार को समर्पित है, ताकि यह पता लगाया जा सके कि क्या मॉडल प्रतिक्रिया के आधार पर अपनी कार्रवाइयों का मूल्यांकन कर सकता है और उन्हें बेहतर बना सकता है।

लाइव स्ट्रीमिंग पेज पर सीखने के चरणों और सफलता मूल्यांकन संकेतकों को अपडेट होने पर प्रदर्शित किया जाता है।

इस प्रदर्शन का मुख्य विचार पारदर्शिता है। आमतौर पर एम्बोडीड एआई में प्रगति का आकलन बाहरी पर्यवेक्षकों द्वारा पॉलिश किए गए रोबोट प्रदर्शनों, बेंचमार्क तालिकाओं और वैज्ञानिक लेखों के माध्यम से किया जाता है, जो यह कम बताते हैं कि प्रशिक्षण प्रक्रिया के दौरान क्षमताएं वास्तव में कैसे बनती हैं या क्या समस्याएं उत्पन्न होती हैं। शेंगशु का दावा है कि प्रसारण न केवल सफलताओं, बल्कि गलतियों, प्रयास और त्रुटि की प्रक्रिया और समायोजन को भी दिखाएगा, और यह स्केलिंग, क्रॉस-टास्क सामान्यीकरण और स्वायत्त सुधार से संबंधित खुले प्रश्नों को अन्य शोधकर्ताओं के साथ साझा करने की उम्मीद करता है।

यह कदम एआई के क्षेत्र में चीनी टीमों के बीच एक व्यापक प्रवृत्ति के अनुरूप है, जो प्रशिक्षण प्रगति को सार्वजनिक रूप से साझा करती हैं। इससे पहले, शियाओमी के MiMo मॉडल के प्रमुख लो फूली ने MiMo-V2.6 के लिए रीइन्फोर्समेंट ट्रेनिंग चरण का विवरण प्रकाशित किया था।

हालांकि, सीधी स्ट्रीमिंग द्वारा सिद्ध की जा सकने वाली सीमाएं हैं। मॉडल वज़न अभी तक जारी नहीं किए गए हैं, और कंपनी स्वयं कहती है कि शोध अनुसंधान प्रकृति का बना हुआ है, और परिणामों की पुष्टि के लिए बाद के प्रयोगों और मूल्यांकन की आवश्यकता होगी। यह घोषणा शेंगशु द्वारा की गई थी और चीनी तकनीकी मीडिया द्वारा कवर की गई थी। वास्तविक परीक्षा सार्वजनिक रिलीज और स्ट्रीम में दिखाए गए बेंचमार्क के अनुरूप होने पर होगी।

टोंगयान लिंगझी व्यक्तिगत LoRA एडेप्टर और सेल्फ-इम्प्रूवमेंट मॉडल का उपयोग करके एआई को विकसित कर रहा है
और पढ़ें
pandaily.com

टोंगयान लिंगझी व्यक्तिगत LoRA एडेप्टर और सेल्फ-इम्प्रूवमेंट मॉडल का उपयोग करके एआई को विकसित कर रहा है

टोंगयान लिंगझी, जो बीजिंग इंस्टीट्यूट ऑफ जनरल आर्टिफिशियल इंटेलिजेंस (BIGAI) के औद्योगिक प्लेटफॉर्म की सहायक कंपनी है, ने व्यक्तिगत एआई की अवधारणा के लिए अपना दृष्टिकोण प्रस्तुत किया है। इस दृष्टिकोण में ऐसे मॉडल बनाना शामिल है जो केवल प्रश्नों और जानकारी की खोज पर निर्भर रहने के बजाय किसी विशिष्ट व्यक्ति, परियोजना या कंपनी के डेटा के आधार पर लगातार सीखते हैं।

आज अधिकांश मौजूदा कॉर्पोरेट एआई सिस्टम बाहरी उपयोगकर्ताओं के अनुकूल होते हैं। वे नियमों को स्थापित करने के लिए प्रश्नों का उपयोग करते हैं, खोज के माध्यम से दस्तावेज़ निकालते हैं, स्थिति को मेमोरी में संग्रहीत करते हैं और पुन: प्रयोज्य चरणों को पैक करते हैं। हालांकि, इंटरैक्शन के बाद मॉडल के वज़न शायद ही कभी बदलते हैं।

टोंगयान लिंगझी का दावा है कि स्थिर आदतें, जैसे टीम के इंजीनियरिंग मानक या निवेश समूह की जोखिम प्रबंधन अनुशासन, को सीधे मॉडल मापदंडों में एकीकृत किया जा सकता है। कंपनी की वास्तुकला सामान्य ज्ञान और तर्क को संसाधित करने के लिए एक सामान्य आधार मॉडल को बनाए रखने का प्रावधान करती है, जिसमें प्रत्येक व्यक्तिगत उपयोगकर्ता, परियोजना या संगठन के लिए हल्के पर्सनल LoRA एडेप्टर जोड़े जाते हैं। कंपनी का कहना है कि ये व्यक्तिगत क्षमताएं आधार मॉडल बदलने की स्थिति में भी बनी रहनी चाहिए।

इन एडेप्टरों को प्रशिक्षित रखने के लिए, टीम रिकर्सिव सेल्फ-इम्प्रूवमेंट (RSI) नामक एक तंत्र विकसित कर रही है। कार्य ट्रैकिंग, मानव द्वारा सुधार और प्राप्त परिणाम सीखने के लिए संभावित डेटा बन जाते हैं। प्रत्येक उपयोगकर्ता या कंपनी के मानकों के अनुरूप सेट एक विशेष मूल्यांकनकर्ता उन संकेतों का चयन करता है जिन्हें वृद्धिशील LoRA अपडेट करने से पहले अध्ययन करने लायक है। फिर अद्यतन मॉडल को पिछले संस्करण के समान कार्यों पर चलाया जाता है, और केवल सुधारों को कार्य वातावरण में जारी किया जाता है, जबकि प्रतिगमन को रद्द कर दिया जाता है।

सीटीओ चू बिनबिन ने जोर देकर कहा कि एक विचलन केवल एक संकेत है, और केवल दोहराए जाने वाले पैटर्न ही प्रशिक्षण डेटा बन सकते हैं। इसके अलावा, कंपनी हजारों ऐसे एडेप्टर को सुलभ बनाने के लिए बुनियादी ढांचा तैयार कर रही है। TIP प्रणाली एक ही GPU पर समानांतर में प्रशिक्षण और अनुमान दोनों करती है, और Paged LoRA एडेप्टर मेमोरी को पेजों में प्रबंधित करता है। आठ Nvidia H800 GPUs और 5.79 जीबी एडेप्टर मेमोरी बजट का उपयोग करके Qwen2.5-72B-Instruct के साथ एक परीक्षण चरण में, Paged LoRA ने फ्लैट लेआउट की तुलना में बेहतर विलंबता और 'टेल' व्यवहार प्रदर्शित किया जब LoRA अनुरोध ट्रैफिक का 1% से 30% थे, हालांकि 50% तक पहुंचने पर प्रदर्शन कम हो गया।

टोंगयान लिंगझी स्वीकार करता है कि काम प्रारंभिक चरण में है। हालांकि RSI का तकनीकी मार्ग और उत्पाद वास्तुकला परिभाषित हैं, और मॉड्यूल डिजाइन चरण में हैं, पूरी तरह से स्वचालित शिक्षण चक्र अभी भी विकास में है। खुले मुद्दों में कैटास्ट्रोफिक फॉरगेटिंग, फीडबैक प्रदूषण और मॉडल ड्रिफ्ट शामिल हैं।

VAST ने सरल गेम फ्रेम को विस्तृत वीडियो में रेंडर करने के लिए EdenLive मॉडल जारी किया
और पढ़ें
pandaily.com

VAST ने सरल गेम फ्रेम को विस्तृत वीडियो में रेंडर करने के लिए EdenLive मॉडल जारी किया

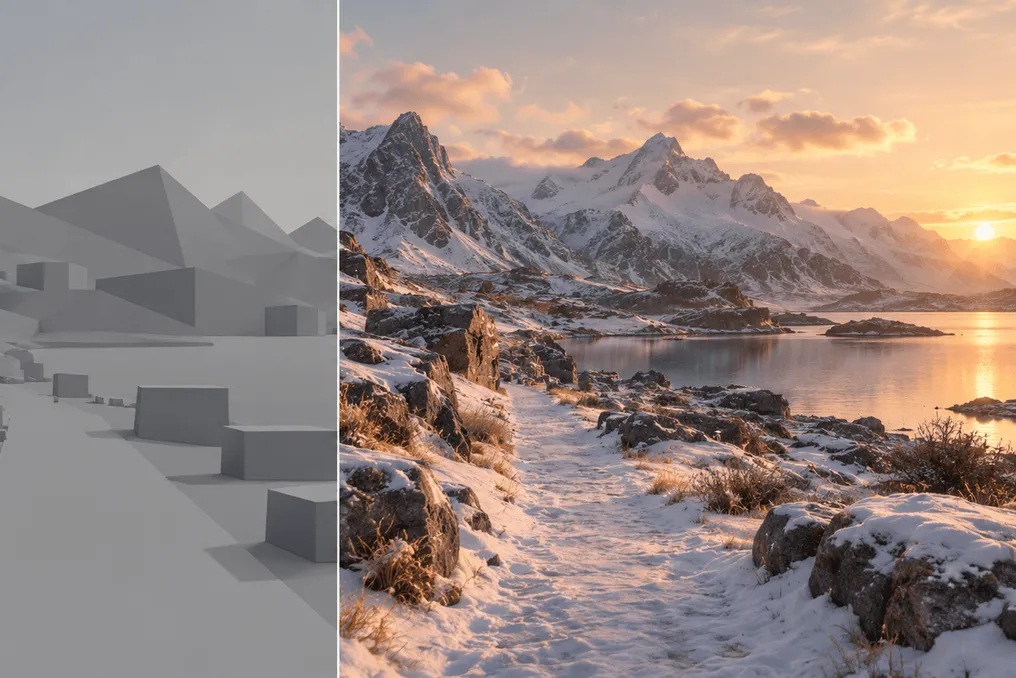
VAST, जो 3डी में जेनरेटिव एआई में विशेषज्ञता रखता है और Tripo प्लेटफॉर्म के पीछे है, ने EdenLive मॉडल को सार्वजनिक कर दिया है। यह मॉडल वास्तविक समय में काम करता है और सरलीकृत गेम फ्रेम या मौजूदा वीडियो को लेता है, उन्हें चुने हुए शैली में विस्तृत छवियों में लगातार फिर से प्रस्तुत करता है, जो फोटो-यथार्थवादी से लेकर एनीमे तक भिन्न हो सकती है।

इस रिलीज़ में 5B और 14B आकार के मॉडल वेट्स, वास्तविक समय इन्फेरेंस के लिए कोड, एक तकनीकी रिपोर्ट और एंड-टू-एंड डेमो शामिल हैं। यह ध्यान रखना महत्वपूर्ण है कि EdenLive स्वयं दुनिया का अनुकरण नहीं करता है; इसके बजाय, एक उच्च-स्तरीय प्रोग्राम, जैसे गेम इंजन या कोडिंग एजेंट द्वारा लिखा गया कोड, नियमों का पालन करने, दुनिया की स्थिति को ट्रैक करने और एक मोटे संदर्भ वीडियो को आउटपुट करने के लिए जिम्मेदार होता है।

इस संदर्भ वीडियो को प्राप्त करने के बाद, EdenLive निर्दिष्ट पहले फ्रेम और टेक्स्ट प्रॉम्प्ट का मार्गदर्शन करते हुए रेंडरिंग करता है। VAST का तर्क है कि इस अलगाव से गेम लॉजिक को स्पष्ट और परीक्षण योग्य बनाए रखने की अनुमति मिलती है, जबकि वास्तविक समय में मॉडल की सीमित क्षमताओं को पूरी तरह से बाहरी रूप पर केंद्रित किया जाता है।

इस दृष्टिकोण को पहली बार जून में प्रोजेक्ट ईडन नामक एक बड़े विश्व अनुसंधान के हिस्से के रूप में प्रस्तुत किया गया था। VAST के बयानों के अनुसार, 5B मॉडल एक Nvidia RTX 5090 पर 720p रिज़ॉल्यूशन पर 24 फ्रेम प्रति सेकंड से अधिक की दर पर काम कर सकता है। GitHub पर README फ़ाइल में, लाइटएक्स2V इन्फेरेंस फ्रेमवर्क से त्वरण का उपयोग करते हुए, 1280x704 पिक्सेल रिज़ॉल्यूशन पर लगभग 24.7 FPS के रूप में यह संख्या बताई गई है।

तकनीकी रिपोर्ट एक ही H100 पर समान रिज़ॉल्यूशन पर 29.8 FPS और आठ H100 पर 14B मॉडल के लिए 832x480 रिज़ॉल्यूशन पर 26.8 FPS का आंकड़ा बताती है। VAST का दावा है कि उपयोगकर्ता इनपुट से संबंधित फ्रेम तक कुल विलंबता कुछ सौ मिलीसेकंड है, और सिस्टम कई मिनटों तक लगातार सामग्री उत्पन्न कर सकता है।

दोनों मॉडल Wan2.2-TI2V-5B और Wan2.1-I2V-14B वीडियो मॉडल पर आधारित हैं। इन्फेरेंस कोड और मुख्य डिफ्यूजन, VAE और डिकोडर वेट Apache 2.0 लाइसेंस के तहत वितरित किए जाते हैं, हालांकि सभी घटक इस लाइसेंस के अंतर्गत नहीं आते हैं। विज़ुअल एन्कोडर DINOv3 लाइसेंस का उपयोग करता है, और अनुरोध से गेम तक कार्यक्षेत्र में उपयोग की जाने वाली छवि मॉडल गैर-व्यावसायिक FLUX लाइसेंस के तहत है, जो इस कार्यक्षेत्र के गैर-व्यावसायिक उद्देश्यों के लिए उपयोग को प्रतिबंधित करता है।

VAST ने Game Prototype Turbo भी पेश किया है - एक कौशल जो टेक्स्ट प्रॉम्प्ट को एक मोटे खेलने योग्य गेम में बदल देता है जिसे EdenLive फिर रेंडर कर सकता है। VAST के प्रदर्शनों में एक प्लेटफॉर्मर शामिल है जहां चरित्र आधार बिंदु बनाने के लिए लावा को जमाता है, एक दो-खिलाड़ी फाइटिंग गेम जिसमें स्वास्थ्य बार और राउंड टाइमर को उच्च-स्तरीय प्रणाली द्वारा ट्रैक किया जाता है, और एक वीडियो रेंडरिंग जो नीली पृष्ठभूमि पर फिल्माए गए व्यक्ति को कार्टून चरित्र में बदल देती है। इसके अलावा, मॉडल एम्बोडेड एआई के लिए अतिरिक्त प्रशिक्षण डेटा बनाने हेतु फुटेज में मानव हाथों को रोबोटिक हाथों से बदलने का प्रदर्शन करता है।

VAST отмечает कि वर्तमान में EdenLive कम आवृत्ति की बातचीत के लिए सबसे उपयुक्त है, जैसे दृश्यों का निरीक्षण करना और बक्से धकेलने वाले पहेलियाँ। तेज़, गहन गेमप्ले, कई पात्रों की स्थिरता बनाए रखना, छोटी वस्तुओं पर सूक्ष्म नियंत्रण और लंबी सत्रों में दृश्य स्थिरता अभी भी सुधार की मांग करती है।

लोकप्रिय