SenseTime ने चक्रीय वास्तुकला के साथ SenseNova-Loop-9B-Preview मॉडल जारी किया
और पढ़ें
Pandaily
pandaily.com

SenseTime ने चक्रीय वास्तुकला के साथ SenseNova-Loop-9B-Preview मॉडल जारी किया

SenseTime कंपनी ने 30 अक्टूबर को SenseNova-Loop-9B-Preview मॉडल जनता के लिए जारी किया। यह मल्टीमॉडल मॉडल लूपेड ट्रांसफार्मर डिज़ाइन पर बनाया गया है और कंपनी के अनुसार, यह केवल 9 बिलियन पैरामीटर का उपयोग करके लगभग 27 बिलियन पैरामीटर वाले मॉडलों के साथ प्रतिस्पर्धा करने में सक्षम है।

मॉडल के वज़न Hugging Face प्लेटफॉर्म पर Apache 2.0 लाइसेंस के तहत उपलब्ध हैं, और स्रोत कोड GitHub पर रखा गया है। मॉडल कार्ड के अनुसार, इसमें 32 अलग-अलग डिकोडर परतें हैं। पहली चार और अंतिम चार परतें एक बार निष्पादित की जाती हैं, जबकि 4 से 27 तक की परतें, जो 24 परतों का ब्लॉक बनाती हैं, सामान्य वज़नों का उपयोग करके क्रमिक रूप से दो बार निष्पादित होती हैं। इसके परिणामस्वरूप एक फॉरवर्ड पास में 56 डिकोडर परतें निष्पादित होती हैं, जबकि केवल 32 सेट वज़न संग्रहीत होते हैं।

डिकोडर रैखिक और पूर्ण ध्यान तंत्रों को बारी-बारी से बदलता है: प्रत्येक चार परतों के समूह में तीन परतें रैखिक ध्यान के साथ होती हैं, जिसके बाद एक पूर्ण ध्यान परत होती है। चक्र की सीमाएं इन समूहों के साथ मेल खाती हैं। मॉडल टेक्स्ट और छवियों को इनपुट के रूप में लेता है और टेक्स्ट उत्पन्न करता है। इसके प्रशिक्षण नुस्खे 262,144 टोकन तक की लंबाई वाली अनुक्रमों का उपयोग करते हैं, जिसमें टेक्स्ट, छवियां, कोड और टूल ट्रेजेक्टरी शामिल हैं।

लूप सेक्शन के भीतर, SenseTime ने दो-स्ट्रीम मैनिफोल्ड-कंस्ट्रेंड हाइपर-कनेक्शन (two-stream manifold-constrained hyper-connections, mHC) को एकीकृत किया। ये कनेक्शन दो अवशिष्ट धाराओं को स्थानांतरित करते हैं और उनके बीच जानकारी को मिलाने के लिए सिंक्रोर्न नॉर्मलाइज़ेशन द्वारा सीमित सीखे गए मैपिंग का उपयोग करते हैं। कंपनी बताती है कि घटक हटाने के परीक्षणों से पता चला है कि mHC ने GPQA डायमंड पर 4.42 अंक और TeamBench पर 13.34 अंक बढ़ाए।

SenseTime का दावा है कि मूल्यांकन की स्थितियों में, इसका मॉडल कोडिंग, कार्यालय और एजेंट कार्यों में अन्य मॉडलों से बेहतर प्रदर्शन करता है, और यह WorkBuddy Bench, RaccoonPPT Bench और AutomationBench बेंचमार्क पर Qwen3.5-27B से आगे निकल जाता है। कार्ड में बेंचमार्क ग्राफ़ में BIRD-Dev, AIDABench, टर्मिनल बेंच 2.1 और T3-बैंकिंग पर भी परिणाम प्रस्तुत किए गए हैं। ये डेटा कंपनी के अपने परिणाम हैं, और तकनीकी रिपोर्ट अभी भी अपेक्षित है।

मॉडल इन्फेरेंस को गति देने के लिए MTP का समर्थन करता है, जबकि दो अन्य त्वरण विधियाँ - Dspark और Dflash2 - अभी भी प्रशिक्षण चरण में हैं। SenseTime भविष्य में दक्षता और कार्यों में प्रदर्शन बढ़ाने के लिए DSA और अनुकूलनीय पुनरावृत्ति संख्या का पता लगाने की योजना बना रहा है।
समान कहानियाँ

रॉक मैट्रिक्स ने एजरॉक-4बी प्रस्तुत किया, जिसमें KV कैश फिक्स्ड है, जिससे Qwen3.5-4B की मेमोरी खपत में काफी कमी आई है
और पढ़ें
pandaily.com

रॉक मैट्रिक्स ने एजरॉक-4बी प्रस्तुत किया, जिसमें KV कैश फिक्स्ड है, जिससे Qwen3.5-4B की मेमोरी खपत में काफी कमी आई है

रॉक मैट्रिक्स ने हांगकांग इंस्टीट्यूट ऑफ साइंस एंड टेक्नोलॉजी और कार्नेगी मेलन विश्वविद्यालय के सहयोग से एजरॉक-4बी मॉडल को ओपन सोर्स कर दिया है। यह छोटा भाषा मॉडल इस विशेषता के लिए जाना जाता है कि इसकी मेमोरी खपत संदर्भ की लंबाई की परवाह किए बिना स्थिर रहती है।

एजरॉक-4बी के लिए आधार मॉडल अलीबाबा का Qwen3.5-4B है, जैसा कि GitHub पर प्रोजेक्ट पेज और arXiv पर संबंधित लेख में QbitAI द्वारा दी गई जानकारी के अनुसार बताया गया है।

एजरॉक मॉडल को शुरू से प्रशिक्षित नहीं किया गया था; टीम ने Qwen3.5-4B का चरणबद्ध रूपांतरण किया। 24 Gated DeltaNet लेयर्स को संरक्षित किया गया, जिनमें पहले से ही निश्चित आकार की स्थिति होती है। इसके अलावा, 8 फुल अटेंशन लेयर्स, जो आमतौर पर प्रत्येक पिछले टोकन के लिए कुंजी और मान संग्रहीत करती हैं, को एक मूविंग विंडो अटेंशन मैकेनिज्म में बदल दिया गया, जो अंतिम 1024 टोकन को कवर करता है।

इस विंडो से बाहर निकलने वाली जानकारी को भूलने से रोकने के लिए, डेवलपर्स ने 'रॉक मेमोरी एंकर' (Rock Memory Anchors) लागू किए। प्रत्येक KV हेड समूह के लिए, मॉडल 256 उम्मीदवार टोकन में से 1024 सबसे उपयोगी टोकन को एक छोटे एंकर बैंक में सहेजता है।

परिणामस्वरूप, 256K संदर्भ पर KV कैश को 72 MB के स्तर पर स्थिर करने में सफलता मिली, जो Qwen3.5-4B द्वारा आवश्यक 8 GB की तुलना में एक विशाल कमी है, यानी 99.1% की गिरावट। अनुक्रम के लिए पूर्ण स्थिति 97.76 MB है।

80 GB क्षमता वाले एक हॉपर ग्राफिक्स प्रोसेसिंग यूनिट पर काम करते समय, एजरॉक ने 12,124 टोकन प्रति सेकंड की गति से 512 समवर्ती थ्रेड्स को सेवा प्रदान की, जो बैच सीमा 64 पर Qwen3.5-4B (1,889 टोकन प्रति सेकंड) के प्रदर्शन से 6.42 गुना अधिक है। अधिकतम मेमोरी खपत 61.26 GB थी। इनपुट में 128K और आउटपुट में 128K टोकन संसाधित करते समय, एजरॉक ने लगातार 233.7 टोकन प्रति सेकंड की गति बनाए रखी, जबकि Qwen लगभग 169 से घटकर 151.3 टोकन प्रति सेकंड हो गया। 4K इनपुट के लिए GPU रनटाइम Qwen के समय का 24.9% और 32K इनपुट के लिए 15.6% तक कम हो गया।

टीम के अनुसार, सटीकता में समझौता न्यूनतम है। एजरॉक Qwen3.5-4B के AIME स्कोर का 96.3% और MATH-500 पर 97.5% बनाए रखता है, 8 बेंचमार्क पर इसे पार करता है और 95.3% विजन मेट्रिक्स बनाए रखता है। 2024 से 2026 की अवधि के दौरान AIME पर इसका औसत pass@1 स्कोर 82.9% है, जो सीमित स्थिति वाले सबसे मजबूत परीक्षण किए गए मॉडल, RWKV-7 G1j 13.3B के 18.8% की तुलना में है। इसके अलावा, यह 29 टेक्स्ट बेंचमार्क में से 24 में सीमित स्थिति वाले मॉडलों में पहला स्थान रखता है। एब्लेशन अध्ययन के दौरान, सूचना पुनर्प्राप्ति कार्य ने मेमोरी एंकरों का उपयोग करके 94.1% और उनके बिना केवल 0.4% दिखाया।

मॉडल वेट टेक्स्ट और इमेज इनपुट दोनों लेते हैं और क्वांटाइज्ड बिल्ड्स में उपलब्ध हैं। इन्हें एजरॉक मॉडल लाइसेंस के तहत जारी किया गया है, जो टीम के अनुसार वाणिज्यिक उपयोग की अनुमति देता है। बड़े संस्करणों को जारी करने की योजना है।

SenseTime ने SenseNova-RoboRSI उपकरण और 27 बिलियन पैरामीटर वाले रोबोट मॉडल को जारी किया
और पढ़ें
pandaily.com

SenseTime ने SenseNova-RoboRSI उपकरण और 27 बिलियन पैरामीटर वाले रोबोट मॉडल को जारी किया

SenseTime कंपनी ने अपने एम्बोडीड एआई मूल्यांकन टूलकिट SenseNova-RoboRSI और 27 बिलियन पैरामीटर वाले मॉडल को सार्वजनिक कर दिया है। यह रिलीज़ एक ऐसे शोध के बाद आया है जिसमें SenseTime ने GPT-6-Astra बड़े मॉडल का परीक्षण बारह सिमुलेटेड बेंचमार्क और आठ वास्तविक रोबोटों पर किया था। प्रस्तुत सभी परिणाम SenseTime के स्वयं के परीक्षणों पर आधारित हैं।

SenseTime ने SenseNova-RoboRSI को एम्बोडीड एआई सिस्टम के मूल्यांकन के लिए एक फ्रेमवर्क के रूप में प्रस्तुत किया, साथ ही SenseNova-RoboRSI-27B-Preview नामक एक एम्बोडीड एआई मॉडल भी पेश किया। इस अध्ययन में GPT-6-Astra बड़े मॉडल का 12 सिमुलेटेड रोबोटिक्स बेंचमार्क और 8 भौतिक रोबोटों पर परीक्षण किया गया था।

GPT-6-Astra के परीक्षण परिणाम

SenseTime के आंकड़ों के अनुसार, जब GPT-6-Astra को प्रशिक्षण प्रदर्शन तक पहुंच मिली और स्टेप लिमिट को आधिकारिक मान का दस गुना बढ़ा दिया गया, तो मॉडल ने LIBERO और SIMPLE बेंचमार्क पर संतृप्ति हासिल की, और RoboDojo पर 81.9% सफलता दर दिखाई। एक मामले में, नौ RoboDojo कार्यों, जो पहले पांच प्रयासों में से किसी में भी कभी सफल नहीं हुए थे, उन्हें मॉडल द्वारा बातचीत जारी रखने की अनुमति दिए जाने के बाद सभी पांच प्रयासों में सफलतापूर्वक पूरा किया गया।

हालांकि, इसकी एक उच्च लागत थी। विस्तारित परीक्षणों में बड़ी बजट के साथ, कटोरे जमा करने में लगभग 131 मिनट लगे और अनुमानित रूप से 19 डॉलर के आउटपुट खर्च का आकलन किया गया, जबकि हैंडल को होल्डर में डालने में 263 मिनट लगे और लगभग 55 डॉलर का खर्च आया। SenseTime ने यह भी पाया कि GPT-6-Astra लंबी अवधि के कार्यों को करने में सबसे अधिक कठिनाई दिखाता है, कार्यों के बीच कौशल स्थानांतरण में समस्याओं का सामना करता है, और वास्तविक रोबोटों पर विकृत वस्तुओं और सूक्ष्म नियंत्रण के साथ संघर्ष करता है।

इसके बाद कंपनी ने धीमी तर्क मॉडल के संयोजन का तेज क्रिया मॉडल के साथ परीक्षण किया। ऐसी संयोजनों में से सर्वश्रेष्ठ ने 42 बंद लूप RoboDojo कार्यों में 54% सफलता प्राप्त की, जो प्रत्येक परिणाम की जांच करता है, हालांकि SenseTime बताता है कि लागत की समस्या बनी हुई है।

ओपन-सोर्स टूलकिट प्रत्येक बेंचमार्क और उसकी निर्भरताओं को एक अलग डॉकर छवि में पैक करता है और वातावरण के साथ इंटरैक्ट करने और मूल मूल्यांकन के लिए एक एकीकृत HTTP एपीआई प्रदान करता है। SenseTime का दावा है कि शोधकर्ता मैन्युअल रूप से प्रत्येक सिम्युलेटर को कॉन्फ़िगर किए बिना कॉन्फ़िगरेशन फ़ाइल का उपयोग करके एंड-टू-एंड मूल्यांकन कर सकते हैं।

27B मॉडल की विशेषताएं

27 बिलियन पैरामीटर वाला मॉडल सत्यापित अनुभव को सीधे मॉडल के भार में शामिल करने के लिए डिज़ाइन किया गया है, जिससे प्रयास और त्रुटि वाली कार्रवाइयों की आवश्यकता कम हो जाती है। SenseTime बताता है कि इस मॉडल ने RoboDojo पर 26.13 अंक प्राप्त किए, जिसमें 20.83% कार्य सफलता दर थी, LIBERO-Pro पर 90 के आंकड़े को पार किया और RoboCasa365 में अपनी सफलता दर को 26.0% से बढ़ाकर 46.5% कर दिया, साथ ही टोकन उपयोग को 73% तक कम कर दिया। कंपनी का दावा है कि यह GPT-6-Astra की तुलना में एक पचासवें हिस्से की लागत पर एम्बोडीड एआई कार्य करता है।

इसके अलावा, SenseTime जोर देता है कि भविष्य के एम्बोडीड एआई बेंचमार्क को वास्तविक मानवीय आवश्यकताओं पर आधारित होना चाहिए, रोबोटों से इंटरैक्शन के माध्यम से सीखने की मांग करनी चाहिए और विचार समय को वैश्विक समय के रूप में ध्यान में रखना चाहिए, क्योंकि मॉडल समाधान पर विचार करते समय केतली गर्म होती रहती है। प्रस्तुत परिणामों में से किसी का भी स्वतंत्र रूप से सत्यापन नहीं किया गया था।

VAST ने सरल गेम फ्रेम को विस्तृत वीडियो में रेंडर करने के लिए EdenLive मॉडल जारी किया
और पढ़ें
pandaily.com

VAST ने सरल गेम फ्रेम को विस्तृत वीडियो में रेंडर करने के लिए EdenLive मॉडल जारी किया

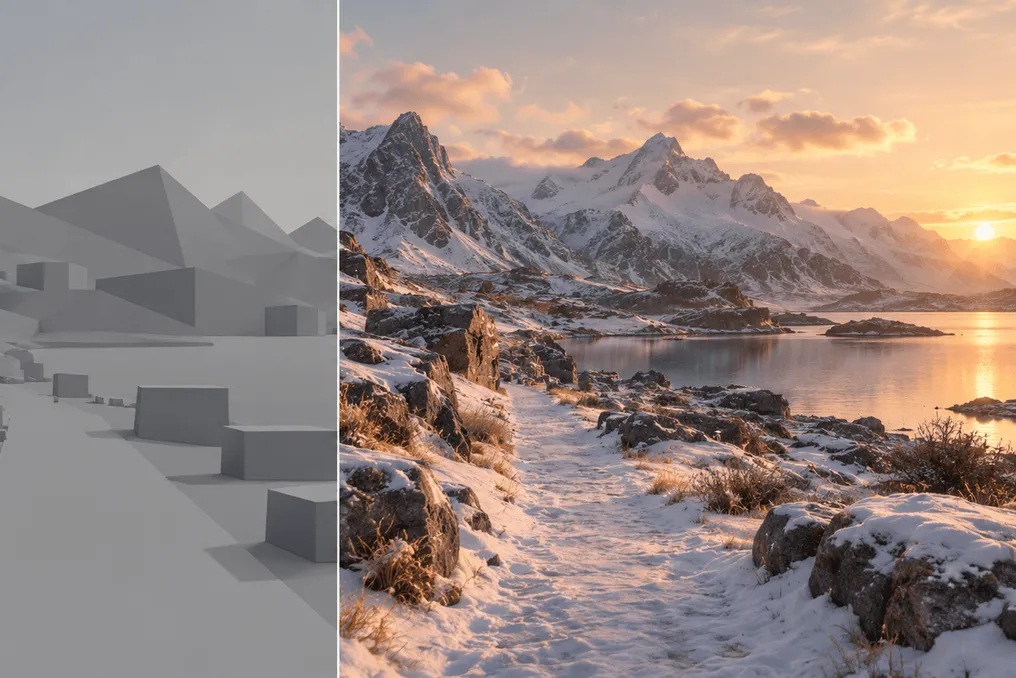
VAST, जो 3डी में जेनरेटिव एआई में विशेषज्ञता रखता है और Tripo प्लेटफॉर्म के पीछे है, ने EdenLive मॉडल को सार्वजनिक कर दिया है। यह मॉडल वास्तविक समय में काम करता है और सरलीकृत गेम फ्रेम या मौजूदा वीडियो को लेता है, उन्हें चुने हुए शैली में विस्तृत छवियों में लगातार फिर से प्रस्तुत करता है, जो फोटो-यथार्थवादी से लेकर एनीमे तक भिन्न हो सकती है।

इस रिलीज़ में 5B और 14B आकार के मॉडल वेट्स, वास्तविक समय इन्फेरेंस के लिए कोड, एक तकनीकी रिपोर्ट और एंड-टू-एंड डेमो शामिल हैं। यह ध्यान रखना महत्वपूर्ण है कि EdenLive स्वयं दुनिया का अनुकरण नहीं करता है; इसके बजाय, एक उच्च-स्तरीय प्रोग्राम, जैसे गेम इंजन या कोडिंग एजेंट द्वारा लिखा गया कोड, नियमों का पालन करने, दुनिया की स्थिति को ट्रैक करने और एक मोटे संदर्भ वीडियो को आउटपुट करने के लिए जिम्मेदार होता है।

इस संदर्भ वीडियो को प्राप्त करने के बाद, EdenLive निर्दिष्ट पहले फ्रेम और टेक्स्ट प्रॉम्प्ट का मार्गदर्शन करते हुए रेंडरिंग करता है। VAST का तर्क है कि इस अलगाव से गेम लॉजिक को स्पष्ट और परीक्षण योग्य बनाए रखने की अनुमति मिलती है, जबकि वास्तविक समय में मॉडल की सीमित क्षमताओं को पूरी तरह से बाहरी रूप पर केंद्रित किया जाता है।

इस दृष्टिकोण को पहली बार जून में प्रोजेक्ट ईडन नामक एक बड़े विश्व अनुसंधान के हिस्से के रूप में प्रस्तुत किया गया था। VAST के बयानों के अनुसार, 5B मॉडल एक Nvidia RTX 5090 पर 720p रिज़ॉल्यूशन पर 24 फ्रेम प्रति सेकंड से अधिक की दर पर काम कर सकता है। GitHub पर README फ़ाइल में, लाइटएक्स2V इन्फेरेंस फ्रेमवर्क से त्वरण का उपयोग करते हुए, 1280x704 पिक्सेल रिज़ॉल्यूशन पर लगभग 24.7 FPS के रूप में यह संख्या बताई गई है।

तकनीकी रिपोर्ट एक ही H100 पर समान रिज़ॉल्यूशन पर 29.8 FPS और आठ H100 पर 14B मॉडल के लिए 832x480 रिज़ॉल्यूशन पर 26.8 FPS का आंकड़ा बताती है। VAST का दावा है कि उपयोगकर्ता इनपुट से संबंधित फ्रेम तक कुल विलंबता कुछ सौ मिलीसेकंड है, और सिस्टम कई मिनटों तक लगातार सामग्री उत्पन्न कर सकता है।

दोनों मॉडल Wan2.2-TI2V-5B और Wan2.1-I2V-14B वीडियो मॉडल पर आधारित हैं। इन्फेरेंस कोड और मुख्य डिफ्यूजन, VAE और डिकोडर वेट Apache 2.0 लाइसेंस के तहत वितरित किए जाते हैं, हालांकि सभी घटक इस लाइसेंस के अंतर्गत नहीं आते हैं। विज़ुअल एन्कोडर DINOv3 लाइसेंस का उपयोग करता है, और अनुरोध से गेम तक कार्यक्षेत्र में उपयोग की जाने वाली छवि मॉडल गैर-व्यावसायिक FLUX लाइसेंस के तहत है, जो इस कार्यक्षेत्र के गैर-व्यावसायिक उद्देश्यों के लिए उपयोग को प्रतिबंधित करता है।

VAST ने Game Prototype Turbo भी पेश किया है - एक कौशल जो टेक्स्ट प्रॉम्प्ट को एक मोटे खेलने योग्य गेम में बदल देता है जिसे EdenLive फिर रेंडर कर सकता है। VAST के प्रदर्शनों में एक प्लेटफॉर्मर शामिल है जहां चरित्र आधार बिंदु बनाने के लिए लावा को जमाता है, एक दो-खिलाड़ी फाइटिंग गेम जिसमें स्वास्थ्य बार और राउंड टाइमर को उच्च-स्तरीय प्रणाली द्वारा ट्रैक किया जाता है, और एक वीडियो रेंडरिंग जो नीली पृष्ठभूमि पर फिल्माए गए व्यक्ति को कार्टून चरित्र में बदल देती है। इसके अलावा, मॉडल एम्बोडेड एआई के लिए अतिरिक्त प्रशिक्षण डेटा बनाने हेतु फुटेज में मानव हाथों को रोबोटिक हाथों से बदलने का प्रदर्शन करता है।

VAST отмечает कि वर्तमान में EdenLive कम आवृत्ति की बातचीत के लिए सबसे उपयुक्त है, जैसे दृश्यों का निरीक्षण करना और बक्से धकेलने वाले पहेलियाँ। तेज़, गहन गेमप्ले, कई पात्रों की स्थिरता बनाए रखना, छोटी वस्तुओं पर सूक्ष्म नियंत्रण और लंबी सत्रों में दृश्य स्थिरता अभी भी सुधार की मांग करती है।

लोकप्रिय