ACE Robotics ने नानयांग टेक्नोलॉजिकल यूनिवर्सिटी के S-Lab के साथ मिलकर Mundo जारी किया है - एक विश्व मॉडल जो वास्तविक स्थान की थोड़ी सी छवियों के आधार पर इंटरैक्टिव और अन्वेषण योग्य वातावरण बना सकता है। इस बारे में चीनी समाचार मंच Robot Pro ने 31 अक्टूबर को जानकारी दी।
टीम का दावा है कि Mundo दृश्य को फिर से बना सकता है, इसे विभिन्न कोणों से प्रदर्शित कर सकता है और समय के साथ इसका अनुकरण कर सकता है, जिससे किसी विशिष्ट स्थान की डिजिटल प्रति में रोबोटों का परीक्षण और प्रशिक्षण संभव हो पाता है।
GitHub पर रिपॉजिटरी के अनुसार, मॉडल का कोड और वज़न नवंबर के अंत तक उपलब्ध होंगे।
Mundo कैसे काम करता है
Mundo एक से बारह संदर्भ छवियों को स्वीकार करता है और कैमरे के निर्दिष्ट पथ के साथ नए दृश्य उत्पन्न करता है। केवल एक छवि का उपयोग करते समय, सिस्टम अदृश्य हिस्सों पर दिखाई देने वाली शैली और संरचना का विस्तार करता है, और छवियों की संख्या बढ़ने पर उन क्षेत्रों में अनिश्चितता कम हो जाती है जिन्हें फोटो नहीं खींचा गया था।
बड़े स्थानों के लिए, मॉडल दर्जनों सेकंड से लेकर कई मिनटों तक चलने वाले कैमरा मूवमेंट बना सकता है, प्रत्येक खंड के लिए सबसे उपयुक्त तस्वीरें चुनता है और निरंतरता सुनिश्चित करने के लिए उन्हें ओवरले करता है।
मॉडल के तकनीकी विवरण
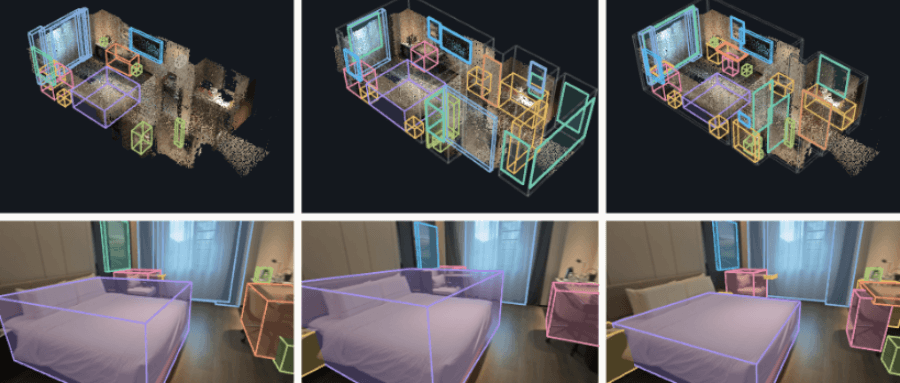
कार्यप्रणाली एक त्रि-आयामी मौलिक मॉडल पर आधारित है, जो कैमरों की पोज़ और सघन ज्यामिति को पुनर्स्थापित करता है। साथ ही, एक त्रि-आयामी डिटेक्टर प्रत्येक बड़े ऑब्जेक्ट के लिए प्रारंभिक बाउंडिंग बॉक्स बनाता है। चूंकि डिटेक्टर वस्तुओं को छोड़ सकते हैं या उनके आकार का गलत अनुमान लगा सकते हैं, इसलिए दृष्टि और भाषा पर आधारित एजेंट दृश्य प्रोग्राम को संपादित करता है, इसे प्रत्येक इनपुट दृष्टिकोण बिंदु से रेंडर करता है, परिणाम की मूल तस्वीरों से तुलना करता है और निर्धारित करता है कि क्या ठीक करने की आवश्यकता है। समानांतर रूप से, संख्यात्मक अनुकूलन बक्सों की स्थिति, आकार और अभिविन्यास को समायोजित करता है।
एक अलग सत्यापन एजेंट निरंतरता की निगरानी करता है, दृश्य संपादन में हस्तक्षेप नहीं करता है। दृश्य प्रोग्राम प्रत्येक वस्तु का नाम, पोज़, आकार, द्रव्यमान और घर्षण गुणांक दर्ज करता है। स्क्रिप्ट बल और क्रियाएं लागू करती हैं, और भौतिक इंजन, जो वर्तमान में MuJoCo है, गति, संपर्क और टकराव की गणना करता है। फिर वीडियो डिफ्यूजन मॉडल सिमुलेशन को मूल तस्वीरों की शैली में विज़ुअलाइज़ करता है।
टीम ने लगभग 40,000 युग्मित 640x480 वीडियो क्लिप का उपयोग करके MiniMax reference-to-video मॉडल को परिष्कृत किया, 124 फ्रेम की अवधि के क्लिप उत्पन्न किए और लंबे वीडियो की निरंतरता बनाए रखने के लिए प्रत्येक क्लिप के अंतिम 34 फ्रेम का पुन: उपयोग किया।
उपयोग के उदाहरण और सीमाएँ
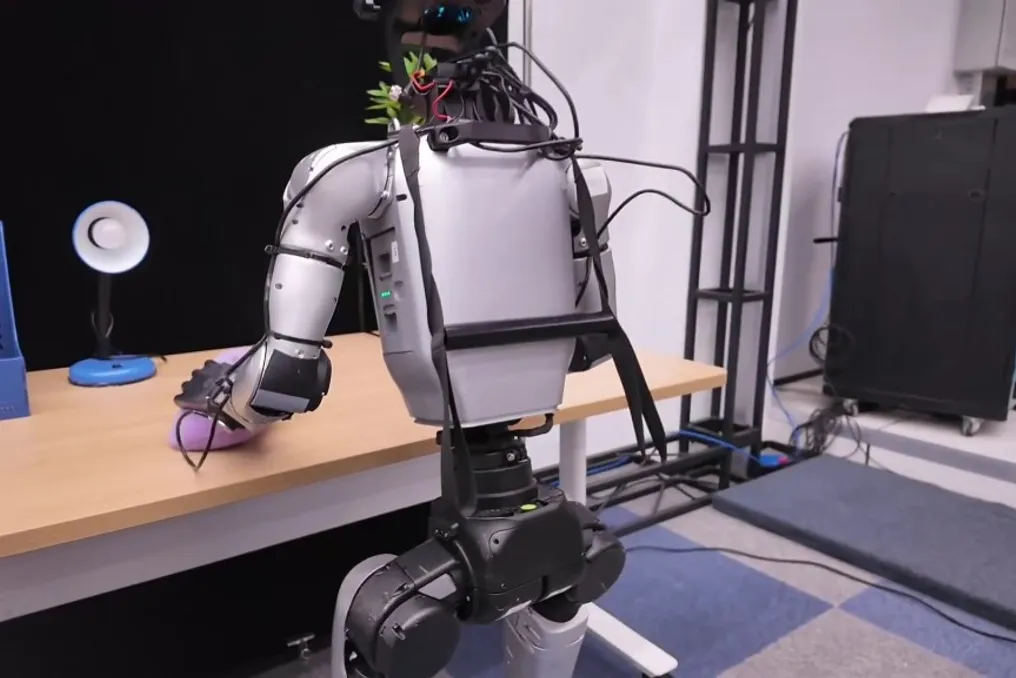
प्रदर्शनों में ऐसे परिदृश्य शामिल हैं जहां रोबोट होटल के पुनर्निर्मित फर्श पर चलते हैं, लॉन्ड्री रूम में वॉशिंग मशीन खोलते हैं, सेब को कटोरे में रखते हैं और क्यूब्स को ढेर करते हैं, जिसमें हेड और कलाई कैमरों से दृश्य और रिकॉर्ड किए गए पथों का उपयोग किया जाता है।
टीम ने सिस्टम की क्षमताओं की सीमाओं को स्पष्ट रूप से बताया है: पुनर्निर्माण प्रक्रिया में 10 से 20 मिनट लगते हैं, रेंडरिंग आठ A800 GPUs पर प्रति सेकंड लगभग 1.5 फ्रेम की दर से 20 इन्फेरेंस चरणों पर किया जाता है। यह भी उल्लेख किया गया है कि छोटे ऑब्जेक्ट तैरते हुए दिख सकते हैं, और लंबे समय तक बदलते दृश्यों के लिए दीर्घकालिक स्मृति अनुपस्थित है।