Tsinghua और Zhipu का HarnessPro विधि एजेंटों को अपनी संरचना स्वतंत्र रूप से बदलने की अनुमति देती है, जिससे कार्यों पर लागत में 26% की कमी आती है
और पढ़ें
Pandaily
pandaily.com

Tsinghua और Zhipu का HarnessPro विधि एजेंटों को अपनी संरचना स्वतंत्र रूप से बदलने की अनुमति देती है, जिससे कार्यों पर लागत में 26% की कमी आती है

सिन्हुआ विश्वविद्यालय, Zhipu, जियाओटून शंघाई विश्वविद्यालय, वरिक विश्वविद्यालय और कुआइसहो के शोधकर्ताओं ने HarnessPro प्रस्तुत किया है - एक विधि जो कृत्रिम बुद्धिमत्ता को उस वातावरण को बेहतर बनाने की अनुमति देती है जिसमें यह काम करता है। यह वातावरण एक ढांचा है जो एजेंट के प्रॉम्प्ट, उपकरणों, बजट और कार्य निष्पादन अनुक्रम को परिभाषित करता है।

arXiv पर 19 अक्टूबर को प्रकाशित वैज्ञानिक पेपर में, Zhipu के मुख्य वैज्ञानिक Tan Ze की भागीदारी के साथ, आत्म-सुधार का दूसरा लक्ष्य जोड़ा गया: परिचालन लागत को कम करते हुए प्रदर्शन बढ़ाना।

यह परियोजना सितंबर से Zhipu के काम को जारी रखती है, जब GLM-5.3 पर आधारित इंफ्रास्ट्रक्चरल एजेंट के बारे में जानकारी प्रस्तुत की गई थी, जिसने GLM-5.3-Flash के लिए इन्फेरेंस बुनियादी ढांचे के निर्माण और कॉन्फ़िगरेशन में मदद की, जिससे दो सप्ताह से भी कम समय में शुरू से अंत तक थ्रूपुट मूल स्तर की तुलना में लगभग तीन गुना बढ़ गया।

HarnessPro कैसे काम करता है

HarnessPro मौजूदा कॉन्फ़िगरेशन के साथ काम करना शुरू करता है, टूल कॉल, पर्यावरण से प्रतिक्रिया और टोकन उपयोग के बारे में डेटा एकत्र करता है। फिर एजेंट ट्रजेक्टरी विश्लेषण एक ही कार्य के कई रन का अध्ययन करता है ताकि विफलताओं के कारणों, साथ ही पुन: खोज, व्यर्थ अन्वेषण और अत्यधिक जांच जैसी हानियों की पहचान की जा सके।

इसके बाद योजना बनाने वाला एजेंट बचत, संतुलन या प्रदर्शन में से किसी एक को प्राथमिकता देते हुए तीन प्रकार के परिवर्तनों को विकसित करता है। फ्रेमवर्क संपादन एजेंट प्रत्येक परिवर्तन को एक अलग कार्यक्षेत्र में लागू करता है, जिसे ऑडिट और रोलबैक की संभावना के लिए Git का उपयोग करके ट्रैक किया जाता है।

बिना संदर्भ उत्तरों या आधिकारिक परीक्षणों का उपयोग किए प्रगति का मूल्यांकन करने के लिए, टेस्ट जनरेशन एजेंट कार्य विवरण और प्रारंभिक रनों के आधार पर परीक्षण बनाता है, जिसके बाद इन परीक्षणों को प्रत्येक उम्मीदवार के लिए लॉक किया जाता है। इस दृष्टिकोण ने शुरुआती प्रयोगों में विफलता का पता लगाने के दर को 41.7 प्रतिशत से बढ़ाकर 83.3 प्रतिशत कर दिया, जो कार्य सफलता निर्धारित करने के लिए लॉग पढ़ने वाले मॉडल से अनुरोध विधि की तुलना में है।

उम्मीदवार जिन्हें मूल ढांचे की तुलना में खराब परिणाम मिलते हैं, या जो लागत और सफलता दोनों में दूसरे संस्करण से पीछे हैं, उन्हें बाहर कर दिया जाता है। लाइट, मीडियम और हेवी विकल्प अगले चरण के परीक्षण से गुजरते हैं।

परीक्षण परिणाम

टीम ने GPT-5.5 के साथ Codex का उपयोग करके Terminal-Bench 2, SWE-Bench Pro और ProgramBench पर परीक्षण किया। पिछले RHO विधि की तुलना में, हेवी संस्करण ने औसत पास प्रतिशत में 2.0 प्रतिशत अंक की वृद्धि की और कार्य की औसत लागत में 26.1% की कमी की।

Terminal-Bench 2 पर, पास प्रतिशत 76.3 प्रतिशत से बढ़कर 80.8 प्रतिशत हो गया, और कार्य की लागत $1.09 से घटकर $0.72 हो गई। SWE-Bench Pro पर, मीडियम संस्करण ने RHO के 80.0 प्रतिशत की तुलना में 79.0 प्रतिशत पास किया, जबकि लागत प्रति कार्य $2.68 के बजाय $1.26 थी।

दक्षता में मुख्य वृद्धि तर्क और टूल बजट के प्रयासों को प्रत्येक कार्य के साथ संरेखित करने के कारण प्राप्त हुई, जिसने एजेंट को अन्वेषण बंद करने के लिए प्रेरित किया, साथ ही दोहराए जाने वाले लॉग और निर्देशों को संपीड़ित करने के कारण भी। प्रस्तुत वित्तीय आंकड़े केवल कार्यों के निष्पादन को ध्यान में रखते हैं, जिनमें उनसे पहले की खोज और मूल्यांकन प्रक्रियाएं शामिल नहीं हैं।
समान कहानियाँ

AgiBot ने वर्ष के अंत तक इंजीनियरों और रोबोटों के अनुपात को 1:10 तक कम करने के उद्देश्य से रोबोट के काम को मापने के लिए वर्कन मीट्रिक पेश किया
और पढ़ें
pandaily.com

AgiBot ने वर्ष के अंत तक इंजीनियरों और रोबोटों के अनुपात को 1:10 तक कम करने के उद्देश्य से रोबोट के काम को मापने के लिए वर्कन मीट्रिक पेश किया

शंघाई में 29 अक्टूबर को आयोजित इनोवेशन डे 2026 कार्यक्रम में, AgiBot कंपनी ने कार्यप्रवाहों में रोबोट के वास्तविक योगदान का आकलन करने के लिए एक नई माप इकाई प्रस्तुत की। सह-संस्थापक, अध्यक्ष और तकनीकी निदेशक पेंग झिहुई ने इस इकाई को वर्कन नाम दिया, जिसका अर्थ है कुशल बौद्धिक कार्य घंटे। उन्होंने वर्कन को सक्रिय रोबोटों की संख्या को स्वायत्त कार्य घंटों और आउटपुट दक्षता गुणांक के गुणनफल के रूप में परिभाषित किया।

पेंग ने इस बात पर जोर दिया कि केवल रोबोट के चलने का समय ही मूल्य के बराबर नहीं होता है। उनके अनुसार, यह गारंटी नहीं देता है कि यदि कोई रोबोट आठ घंटे चालू रहता है तो आठ घंटे का मूल्य उत्पन्न होगा, और एक कार्य को सफलतापूर्वक पूरा करने की उच्च सफलता दर का मतलब यह नहीं है कि वह महीने भर मनुष्य की तरह स्थिर रूप से काम कर पाएगा। वर्कन का उद्देश्य वास्तविक परिस्थितियों में रोबोट द्वारा प्रदान किए गए टिकाऊ और उपयोगी श्रम के बारे में सवाल का जवाब देना है, न कि प्रदर्शन विनिर्देशों के बारे में।

AgiBot ने तीन कार्यान्वयनों से डेटा साझा किया। चेंगदू में कुआनचाई गली में ग्राहकों की सेवा करने वाले चार रोबोटों ने 310 घंटे काम किया और 744 वर्कन उत्पन्न किए। लॉन्गचीर फैक्ट्री की उत्पादन लाइन पर लोडिंग और अनलोडिंग करने वाले आठ रोबोटों ने 528 घंटे काम किया और 2956.8 वर्कन दिए। गुआंगझोउ मेट्रो में सुरक्षा क्षेत्र के माध्यम से यात्रियों का मार्गदर्शन करने वाले 120 रोबोटों ने 240 घंटे काम किया और 14,400 वर्कन प्रदान किए। हालांकि, कंपनी ने अभी तक दक्षता गुणांक को परिभाषित करने के लिए कोई सर्वमान्य मानक स्थापित नहीं किया है, जैसे मानव हस्तक्षेप, रखरखाव या डाउनटाइम को कैसे ध्यान में रखा जाए।

एक महत्वपूर्ण पहलू लोगों को कार्य चक्र से हटाना था। सितंबर में, AgiBot ने हेनचिन में चिमेलोंग स्पेसशिप पार्क के 100 से अधिक स्थानों पर 300 से अधिक रोबोट तैनात किए ताकि आगंतुकों के लिए पर्यटन, शतरंज और टेबल टेनिस जैसे खेल और अन्य कार्यक्रम आयोजित किए जा सकें। वर्तमान में वहां लगभग 500 रोबोट नियमित रूप से काम कर रहे हैं, और कंपनी वर्ष के अंत तक इस संख्या को 1000 तक बढ़ाने की योजना बना रही है।

साझेदार वांग चुआंग ने उल्लेख किया कि शुरू में लगभग हर रोबोट के लिए एक समर्पित इंजीनियर की आवश्यकता थी। चूंकि बच्चे रोबोटों के साथ बातचीत कर रहे थे और खेल के नियमों का उल्लंघन कर रहे थे, इसलिए रोबोटों और इंजीनियरों का अनुपात 1:1 से बढ़कर 3:1 हो गया। कंपनी का लक्ष्य इस वर्ष के अंत तक 10:1 का अनुपात प्राप्त करना है, और अगले वर्ष 20:1 का। उनके अनुसार, इस अनुपात पर, ग्राहक को इस कार्य के लिए कर्मियों पर केवल लगभग 5 प्रतिशत अधिक बजट की आवश्यकता होगी।

नेतृत्व ने मौजूदा सीमाओं को स्वीकार किया। वांग ने बताया कि नई WITA-OMNI इंटरैक्शन मॉडल को बड़े रोबोट पार्कों के साथ काम करते समय स्थिरता और संगति के मामले में अभी भी सुधार की आवश्यकता है। सह-संस्थापक याओ माओकिंग ने कहा कि चीनी कारखानों में 10,000 से अधिक रोबोटों का दीर्घकालिक स्थिर संचालन एक प्रमुख उद्योग उपलब्धि होगी। पेंग ने जोड़ा कि अंतिम उपभोक्ता रोबोट बनाने की क्षमता में उतनी दिलचस्पी नहीं रखते हैं, जितनी वे उसकी эксплуатации का खर्च उठा सकते हैं। उनके विचार में, मापने योग्य परिणाम और परिचालन लागत में कमी के बिना, प्रत्येक बेचे गए रोबोट को अभी भी अपने पर्यवेक्षक की आवश्यकता होगी।

टिंगहुआ, इनफिनिजेंस एआई और एजीआईबॉट के शोधकर्ताओं ने 96 रोबोट्स को सामूहिक अनुभव सिखाया
और पढ़ें
pandaily.com

टिंगहुआ, इनफिनिजेंस एआई और एजीआईबॉट के शोधकर्ताओं ने 96 रोबोट्स को सामूहिक अनुभव सिखाया

टिंगहुआ विश्वविद्यालय, इनफिनिजेंस एआई और एजीआईबॉट के शोधकर्ताओं ने 'सामूहिक अनुभव शिक्षण' (Collective Experience Learning, या CEL) नामक एक प्रशिक्षण दृष्टिकोण प्रस्तुत किया है। यह विधि रोबोटों को मुख्य रूप से मानव प्रदर्शन पर निर्भर रहने के बजाय अन्य रोबोटों की सफलताओं से सीखने की अनुमति देती है।

QbitAI द्वारा 30 अक्टूबर को प्रकाशित एक रिपोर्ट के अनुसार, टीम ने इस पद्धति का परीक्षण 96 वास्तविक रोबोटों के क्लस्टर पर किया। संबंधित वैज्ञानिक लेख arXiv पर संख्या 2610.25736 के तहत उपलब्ध है।

शोधकर्ता जिस मूल समस्या का समाधान कर रहे हैं, वह श्रम संसाधनों से संबंधित है। रोबोट व्यावहारिक अनुभव जमा करके बेहतर होते हैं, लेकिन आज यह अक्सर मनुष्य द्वारा गतिविधियों को बार-बार दोहराने या त्रुटियों को ठीक करने के लिए ऑपरेटर के हस्तक्षेप के माध्यम से प्राप्त किया जाता है। हालांकि सैकड़ों रोबोट तैनात किए जा सकते हैं, योग्य ऑपरेटरों को उसी गति से बढ़ाया नहीं जा सकता है।

CEL का उपयोग करते समय, एक रोबोट द्वारा प्राप्त सफल अनुभव सहेजा और साझा किया जाता है, जिससे किसी कार्य का सामना करने वाले रोबोट को यह सीखने का अवसर मिलता है कि उसके सहकर्मी समान स्थितियों को कैसे हल करते हैं।

कार्य परीक्षण और परिणाम

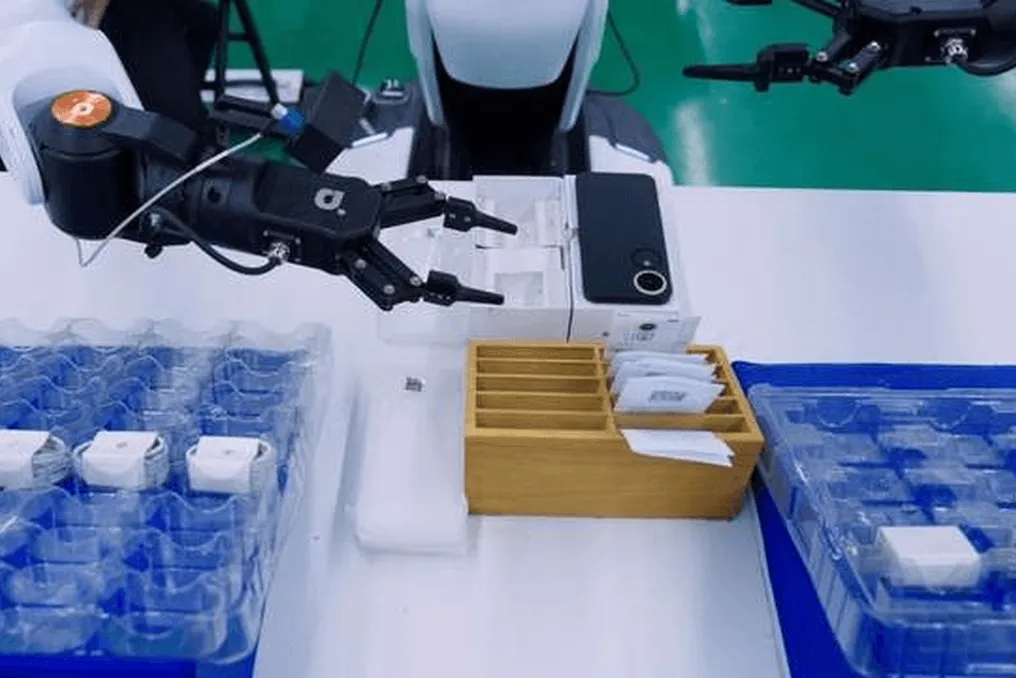
टीम ने पांच विभिन्न कार्यों का परीक्षण किया, जिनमें घरेलू और विनिर्माण दोनों तरह के कार्य शामिल थे: रंगों को छांटना, कपड़े मोड़ना, फोन चार्ज करना, स्टूल असेंबल करना और फोन पैक करना। दो रोबोटों ने जो प्रशिक्षण में भाग नहीं लिया था, उन्होंने 600 परीक्षण किए, जिसमें 15 विफलताएं हुईं, जिससे कुल सफलता दर 97.5 प्रतिशत रही। सभी पांच कार्यों में सफलता दर छह मानव ऑपरेटरों के औसत से अधिक थी।

विशेष रूप से, फोन पैकेजिंग, जो एक बहु-चरणीय औद्योगिक कार्य है, में सामूहिक शिक्षण लागू करने के बाद सफलता दर 79.2 प्रतिशत से बढ़कर 98.3 प्रतिशत हो गई, और 120 लगातार प्रयासों में केवल दो विफलताएं दर्ज की गईं।

स्केलिंग की प्रवृत्ति पर भी ध्यान दिया गया: वास्तविक प्रशिक्षण समय की मात्रा को बनाए रखते हुए, भाग लेने वाले रोबोटों की संख्या को 16 से बढ़ाकर 96 करने से सफलता दर 86.7 प्रतिशत से बढ़कर 98.3 प्रतिशत हो गई।

सिस्टम के तकनीकी घटक

इस प्रणाली का संचालन दो प्रमुख तत्वों द्वारा किया जाता है। पहला — FATS नामक एक दोष-सहिष्णु अतुल्यकालिक शिक्षण प्रणाली। यह प्रणाली बड़े पैमाने पर सुदृढीकरण शिक्षण RLinf के ओपन प्लेटफॉर्म पर बनाई गई है। रोबोट बाकी का इंतजार किए बिना कार्य पूरा होने के तुरंत बाद अपना अनुभव अपलोड करते हैं, और क्लस्टर तब भी काम करना जारी रखता है, भले ही डिवाइस बंद हो जाएं।

96 रोबोटों के साथ परीक्षण के दौरान, क्लस्टर ने 9,834 एपिसोड एकत्र किए। कुल मिलाकर 30 विफलताओं वाले बाईस रोबोटों का समय नुकसान केवल कुल परिचालन समय का 1.3 प्रतिशत था।

दूसरा घटक — त्रुटि-निर्देशित अनुभव पुनर्प्राप्ति फाइन-ट्यूनिंग (failure-guided experience retrieval fine-tuning, या FERT) नामक एल्गोरिथम। एक मैनिपुलेशन मिनटों तक चल सकता है और इसमें हजारों क्रिया चरण शामिल हो सकते हैं, लेकिन प्रतिक्रिया अक्सर केवल अंतिम सफलता या विफलता तक सीमित होती है। FERT इन दोनों पहलुओं का उपयोग करता है: जब कोई रोबोट कठिनाइयों का सामना करता है, तो वह समान स्थितियों से सफल अनुभव प्राप्त करता है और विशेष रूप से उन उदाहरणों पर शिक्षण केंद्रित करता है।

यह जानकारी इनफिनिजेंस एआई द्वारा प्रदान की गई थी। परिणाम शोध समूह द्वारा प्रस्तुत किए गए हैं और अभी तक स्वतंत्र रूप से सत्यापित नहीं किए गए हैं।

DeepSeek Harness v0.2.2-alpha.2 मुख्य एजेंट को स्थानीय उपकरणों Codex और Claude Code को कार्य सौंपने की अनुमति देता है
और पढ़ें
pandaily.com

DeepSeek Harness v0.2.2-alpha.2 मुख्य एजेंट को स्थानीय उपकरणों Codex और Claude Code को कार्य सौंपने की अनुमति देता है

DeepSeek ने अपने ओपन-सोर्स एजेंट सॉफ्टवेयर, DeepSeek Harness का एक प्रीव्यू संस्करण, संस्करण v0.2.2-alpha.2 जारी किया है, जिसे 28 अक्टूबर को GitHub पर पोस्ट किया गया था। मुख्य नवाचार 'subagent_oar' नामक एक प्रायोगिक प्लगइन है, जो मुख्य एजेंट को उसी मशीन पर Codex CLI या Claude Code स्थापित करने का स्वायत्त कार्य सौंपने की क्षमता देता है।

पहले Harness Claude Code और Codex का समर्थन करता था; अगस्त में v0.1.0-rc.8 अपडेट उपयोगकर्ताओं को अपनी सबएजेंट प्रणाली के भीतर प्रोफाइल पैकेज के रूप में उन्हें स्थापित करने की अनुमति देता था। हालांकि, नया टूल अलग तरह से काम करता है। यह मुख्य एजेंट को कार्य वितरण के लिए एक एकल प्रवेश बिंदु प्रदान करता है: जब subagent_oar को कॉल किया जाता है, तो एजेंट codex या claude में से किसी एक का चयन करता है, जिसके बाद वह कार्य विवरण, पूर्ण अनुरोध और वैकल्पिक कार्यशील निर्देशिका भेजता है। टूल तुरंत कार्य आईडी लौटाता है, और कार्य पूरा होने पर, समापन अधिसूचना अंतिम उत्तर या त्रुटि संदेश को मुख्य सत्र में वापस लाती है।

बाहरी उपकरण स्वतंत्र रूप से काम करते हैं। Codex CLI और Claude Code अपनी सेटिंग्स, मॉडल, टूल और लॉगिन प्रक्रिया को स्वयं सहेजते हैं, इसलिए उपयोगकर्ताओं को उनमें से प्रत्येक को स्थापित और अधिकृत करना होगा, और यह सुनिश्चित करना होगा कि Harness होस्ट उन्हें ढूंढ सकता है। प्रदाता पैरामीटर मॉडल, तर्क स्तर, लॉन्च तर्क, पर्यावरण चर और टाइमआउट को पास कर सकते हैं, जो प्रत्येक रनटाइम के समर्थन पर निर्भर करता है।

दस्तावेज़ीकरण स्पष्ट सीमाएँ निर्धारित करता है: मुख्य बातचीत को पुनर्निर्देशित नहीं किया जाता है, इसलिए अनुरोध में स्पष्ट रूप से उल्लेख करना आवश्यक है कि कौन सी फ़ाइलें महत्वपूर्ण हैं और क्या वापस किया जाना चाहिए। कार्य एक बार के होते हैं, जिनमें बाद के प्रश्नों, सत्र पुनरारंभ या वास्तविक समय में प्रगति स्ट्रीमिंग की कोई संभावना नहीं होती है। केवल अंतिम उत्तर या विफलता लौटाई जाती है, न कि बाहरी एजेंट के आंतरिक तर्क या उसके उपकरणों का इतिहास। आधिकारिक उदाहरण रिकॉर्ड किए गए कार्यक्षेत्र का उपयोग करने और अनुमतियों के अनुरोधों को अक्षम करने की अनुमति देते हैं, और कार्य रद्द करने से उन फ़ाइलों में किए गए परिवर्तनों को रद्द नहीं किया जाता है जिन्हें बाहरी एजेंट पहले ही संशोधित कर चुका है।

अन्य ऐड-ऑन उपयोगकर्ताओं को सौंपे गए कार्य को ट्रैक करने में मदद करते हैं। परिवर्तन अनुरोध की प्रायोगिक सुविधा Git वर्कडायरेक्टरी में चलने वाले सत्र के लिए स्थिति और संबंधित मर्ज अनुरोध के अंतर प्रदर्शित कर सकती है। डेवलपर सांख्यिकी प्लगइन प्रत्येक चरण और चाल के लिए संदर्भ, कैश के उपयोग, साथ ही मॉडल और उपकरणों पर खर्च किए गए समय का विवरण देता है। छोटे पृष्ठभूमि कार्यों का आउटपुट अब समाप्ति अधिसूचना में आता है, और subagent प्रतीक्षा गाइड बार-बार पूछताछ की आवश्यकता को कम करता है।

रिलीज़ उपयोगकर्ताओं को तृतीय-पक्ष प्लगइन्स के पैकेजों को अपडेट करने की भी अनुमति देती है, जिसमें हॉट अपडेट विफल होने पर रोलबैक की क्षमता शामिल है, और जापानी, स्पेनिश, फ्रेंच, जर्मन, रूसी और ब्राजीलियाई पुर्तगाली भाषाओं में इंटरफ़ेस टेक्स्ट जोड़ती है। समुदाय की पिछली सामग्री, जिसमें Bilibili डेवलपर्स द्वारा मल्टी-एजेंट सेटअप परीक्षण शामिल हैं, उपयोगकर्ताओं द्वारा बनाई गई थी और DeepSeek के उत्पाद नहीं हैं।

लोकप्रिय