MemTensor ने लंबी कहानियों को सहेजने के लिए मेमोरी के साथ MemT 1.0 का ओपन मॉडल जारी किया
और पढ़ें
Pandaily
pandaily.com

MemTensor ने लंबी कहानियों को सहेजने के लिए मेमोरी के साथ MemT 1.0 का ओपन मॉडल जारी किया

चीनी कंपनी MemTensor ने मेमोरी-आधारित मौलिक मॉडलों की एक श्रृंखला प्रस्तुत की और उसे सार्वजनिक रूप से उपलब्ध कराया, जिसे उन्होंने MemT 1.0 नाम दिया। इस श्रृंखला में दो मॉडल शामिल हैं: MemT-1.0-Flash, जिसमें कुल 288 अरब पैरामीटर हैं जिनमें से सक्रिय रूप से 17 अरब का उपयोग किया जाता है, और MemT-1.0-Nano, जिसमें 36 अरब कुल पैरामीटर और 3 अरब सक्रिय पैरामीटर हैं।

इन मॉडलों के वज़न Hugging Face प्लेटफॉर्म पर उपलब्ध हैं, और संबंधित कोड तकनीकी रिपोर्ट के साथ GitHub पर रखा गया है।

ये मॉडल लंबे संवादों से जुड़ी एक सामान्य समस्या को हल करने के लिए विकसित किए गए हैं। अधिकांश मौजूदा सिस्टम पूरी कहानी को संदर्भ विंडो में संग्रहीत करते हैं, जिससे हर नई चाल के साथ धीमापन और इन्फेरेंस की लागत बढ़ जाती है। इसके बजाय, MemT मॉडल के भीतर एक प्रशिक्षित मेमोरी मॉड्यूल को एकीकृत करता है।

प्रत्येक इंटरैक्शन के बाद, मॉडल नई जानकारी को एक निश्चित मेमोरी स्थिति में लिखता है और आवश्यकता पड़ने पर उसे पुनर्प्राप्त करता है, बजाय इसके कि वह हर बार पूरे पिछले रिकॉर्ड को फिर से पढ़े।

MemTensor बताता है कि मॉडलों को 34 अरब टोकन के आधार पर दो चरणों में प्रशिक्षित किया गया था: पहले मॉडल को मेमोरी में जानकारी लिखना सिखाया गया, और फिर उसे इस संग्रहीत जानकारी का उपयोग करके सवालों का जवाब देना सिखाया गया।

प्रदर्शन परिणाम और तुलना

सभी प्रस्तुत प्रदर्शन मेट्रिक्स कंपनी के स्वयं के मूल्यांकन पर आधारित हैं। MemTensor का दावा है कि 128 हजार टोकन की कहानी के साथ एंड-टू-एंड इन्फेरेंस पूर्ण संदर्भ दृष्टिकोण की तुलना में लगभग 1.86 गुना तेज काम करता है, और 256 हजार टोकन के साथ लगभग 3.99 गुना तेज काम करता है।

पहले टोकन के प्रतिक्रिया समय का अनुमान मेमोरी मॉडल के लिए लगभग 104-112 मिलीसेकंड है, जबकि 256K के लिए पूर्ण संदर्भ के लिए यह लगभग 445 मिलीसेकंड है। इसके अलावा, कंपनी बताती है कि 256K की कहानी के साथ प्रति सत्र मेमोरी स्थिति का आकार लगभग 40 एमबी है, जो पूर्ण संदर्भ कैश के लिए आवश्यक 5.06 जीबी से काफी कम है, जो लगभग 130 गुना कमी दर्शाता है।

मेमोरी पर 11 बेंचमार्क पर, MemTensor फ्लैश के लिए 50.6 और नैनो के लिए 47.0 का औसत स्कोर बताता है। ये परिणाम मॉडलों को तुलनात्मक पैरामीट्रिक मेमोरी तरीकों में पहले और दूसरे स्थान पर रखते हैं और औसतन खोज-वर्धित दृष्टिकोणों (retrieval-augmented approaches) के परिणामों के अनुरूप हैं, भले ही क्वेरी के दौरान इतिहास को पुनर्प्राप्त न किया जाए।

कंपनी इस बात पर भी जोर देती है कि मेमोरी जोड़ने से बड़े व्यवधान वाले परीक्षणों में फ्लैश मॉडल की समग्र क्षमताओं में कोई गिरावट नहीं आई है।

डेवलपर्स को लाइसेंसिंग शर्तों पर ध्यान देना चाहिए: रिपॉजिटरी कोड गैर-व्यावसायिक PolyForm लाइसेंस के तहत प्रकाशित किया गया है, जबकि मॉडल वज़न क्रमशः Apache और MIT लाइसेंस के तहत हैं।

टीम दीर्घकालिक स्मृति में सुधार, मेमोरी क्षमता बढ़ाने और मेमोरी अपडेट की लागत कम करने की दिशा में आगे विकास की योजना बना रही है, जिसका दीर्घकालिक लक्ष्य ऐसे एजेंट बनाना है जो अपनी बातचीत के आधार पर सीखते रहें।
समान कहानियाँ

Tencent ने AI एजेंटों के लिए वर्कफ़्लो और कोड मेमोरी के साथ Hy Memory 2.0 का ओपन-सोर्स संस्करण जारी किया
और पढ़ें
pandaily.com

Tencent ने AI एजेंटों के लिए वर्कफ़्लो और कोड मेमोरी के साथ Hy Memory 2.0 का ओपन-सोर्स संस्करण जारी किया

Tencent Hunyuan ने AI एजेंटों के लिए अपनी मेमोरी फ्रेमवर्क का दूसरा संस्करण, Hy Memory 2.0, पेश किया है और इसके तीनों स्तरों को ओपन-सोर्स बना दिया है। इन स्तरों में एक विशेष मेमोरी मॉडल, स्वयं फ्रेमवर्क और MemHub नामक एक स्थानीय मेमोरी एप्लिकेशन शामिल है। उपयोगकर्ता इन घटकों को अलग-अलग या संयोजन में लागू कर सकते हैं।

Tencent कंपनी ने बताया कि Hy Memory का उपयोग पहले से ही वित्त, समाचार एजेंसियों, ज्ञान प्रबंधन, कार्यालय एजेंटों, सोशल मनोरंजन और गेमिंग जैसे क्षेत्रों में आंतरिक टीमों द्वारा किया जा रहा है।

यह फ्रेमवर्क चैट, वर्कफ़्लो और कोड के तीन प्रकार की मेमोरी को संग्रहीत करने, अद्यतन करने और विकसित करने के लिए जिम्मेदार है। डेवलपर्स इसे अपने एजेंटों में एक SDK के माध्यम से एकीकृत करते हैं, जो PyPI पर hy-memory 2.0.2 नाम से उपलब्ध है। संस्करण 2.0 की नई सुविधाएँ - वर्कफ़्लो और कोड मेमोरी। वे कार्य के लक्ष्य, लिए गए निर्णयों, मध्यवर्ती परिणामों और उपयोगी सीखों के साथ-साथ इन सीखों पर लागू होने वाली शर्तों को रिकॉर्ड करते हैं। किसी लंबी अवधि के कार्य को फिर से शुरू करने से पहले, सिस्टम पहले वर्तमान कार्य की पहचान करता है, फिर प्रासंगिक समाधानों, मौजूदा अनुभव और पिछली कार्य इतिहास को निकालता है।

चैट मेमोरी अब बिखरे हुए तथ्यों को घटनाओं में समूहित करती है, जिसमें समय, स्थान और प्रतिभागियों का उल्लेख होता है, डुप्लिकेट को जोड़ती है और संदर्भ को मॉडल में भेजने से पहले विरोधाभासों को हल करती है।

फ्रेमवर्क के परीक्षण परिणाम

Tencent ने चार विभिन्न परीक्षणों में Mem0, MemOS और EverOS सहित ओपन-सोर्स फ्रेमवर्क में पहले स्थान पर रहने का दावा किया है। कंपनी के आंकड़ों के अनुसार, MemoryArena प्लेटफॉर्म पर यात्रा और खरीदारी की योजना बनाने वाले कार्यों में वर्कफ़्लो मेमोरी ने औसतन 55.31% का परिणाम दिखाया। CodeMemoryBench पर प्रश्नों के उत्तर देने में कोड मेमोरी ने 64.2% सटीकता और SWE-ContextBench पर 35.6% कार्य समाधान हासिल किया, साथ ही 28.3% कार्य समाधान भी किया। चैट मेमोरी ने LoCoMo पर 72.6% सटीकता प्रदर्शित की, जबकि प्रति प्रश्न टोकन की संख्या को 1159 से घटाकर 703 कर दिया, जो 39.3% की कमी है।

Hy-Memory-30B-A3B नामक लेयर मॉडल एक 'एक्सपर्ट मिक्स' प्रकार का मॉडल है जिसमें लगभग 3 बिलियन सक्रिय पैरामीटर हैं, जिसे मेमोरी निकालने और संघर्षों को संसाधित करने के लिए प्रशिक्षित किया गया है। इस मॉडल का मूल्यांकन सभी चार मेमोरी सिस्टम पर 20% बेंचमार्क के एक निश्चित नमूने पर तकनीकी रिपोर्ट में किया गया है। इस नमूने पर इसने 55.49 का मैक्रो औसत स्कोर दिखाया, जो Claude Opus 5 (54.62) और DeepSeek V4.1 Flash (53.64) के प्रदर्शन से थोड़ा अधिक है। मॉडल वेट Hugging Face पर उपलब्ध हैं।

MemHub एप्लिकेशन एक स्थानीय रूप से केंद्रित उपकरण है, जिसमें कमांड लाइन और मैक के लिए क्लाइंट शामिल है। कनेक्टेड उपकरणों को अधिकृत करने के बाद, उपयोगकर्ता पिछले सत्रों को एक एकीकृत स्थानीय मेमोरी स्टोरेज में आयात करता है और नए डेटा के सिंक्रनाइज़ेशन का समर्थन करता है। Tencent отмечает कि MemHub वर्तमान में 10 AI उपकरणों के साथ एकीकृत हो रहा है, जिनमें WorkBuddy, Cursor, Codex, Qwen Code, OpenCode और DeepSeek Harness शामिल हैं।

GitHub पर रिपॉजिटरी की लाइसेंस फ़ाइल में उल्लेख किया गया है कि Hy-Memory Apache 2.0 लाइसेंस के तहत जारी किया गया है।

MemSilicon ने 1T4R आर्किटेक्चर पर आधारित RRAM चिप माउंटटाई 2026 प्रस्तुत किया
और पढ़ें
pandaily.com

MemSilicon ने 1T4R आर्किटेक्चर पर आधारित RRAM चिप माउंटटाई 2026 प्रस्तुत किया

मेमोरी क्षेत्र की चीनी स्टार्टअप MemSilicon ने अपने पहले उच्च घनत्व और बड़ी क्षमता वाले RRAM चिप, जिसका नाम माउंटटाई 2026 है, के टेप-आउट प्रक्रिया को पूरा करने की घोषणा की, जो 12 अक्टूबर को किया गया था। कंपनी का दावा है कि यह इस प्रकार का पहला RRAM चिप है जिसमें उच्च घनत्व और बड़ी क्षमता है, हालांकि इस दावे का अभी तक स्वतंत्र रूप से सत्यापन नहीं किया गया है। वर्तमान में, चिप टेप-आउट पूरा होने के बाद सत्यापन चरण से गुजर रहा है।

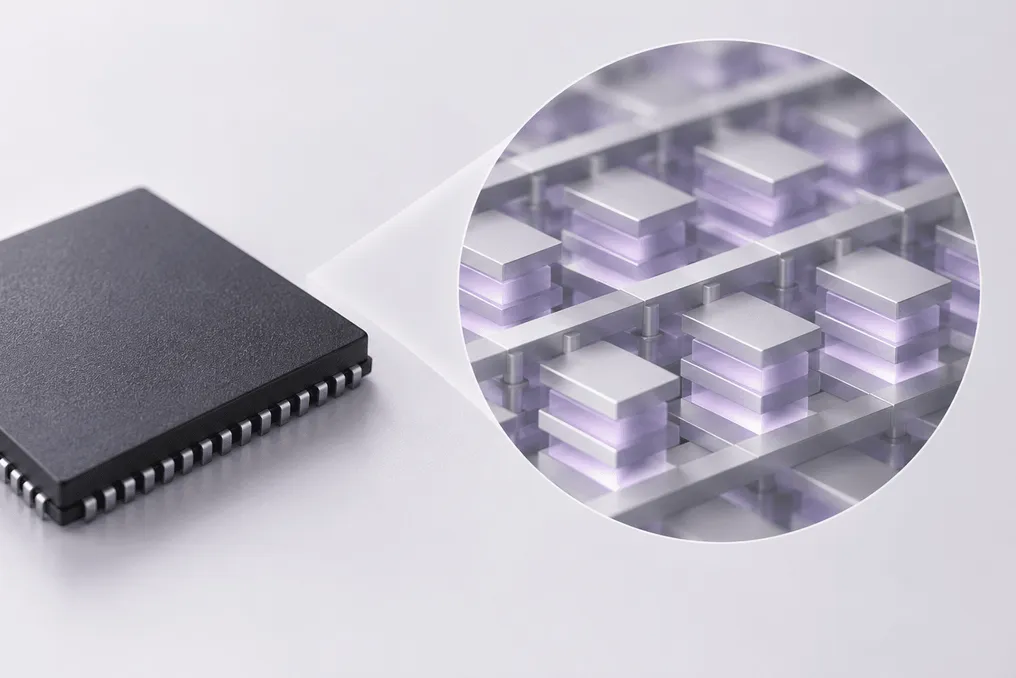
माउंटटाई 2026 चिप को 28nm CMOS प्रक्रिया का उपयोग करके विकसित किया गया है और इसमें 1T4R सेल संरचना है। यह प्रति चिप 1 Gbit की क्षमता प्रदान करता है, 30 Mbit प्रति वर्ग मिलीमीटर का घनत्व प्राप्त करता है, और एक्सेस विलंब 20 नैनोसेकंड से कम है। इसके अलावा, चिप में सीधे क्रिस्टल पर हार्डवेयर त्रुटि सुधार शामिल है।

RRAM, या रेजिस्टर्सिव रैम, प्रतिरोध अवस्थाओं के बीच सामग्री को बदलकर डेटा संग्रहीत करता है और बिजली बंद होने पर भी उसे बनाए रखता है। मानक 1T1R डिज़ाइन में, प्रत्येक रेसिस्टिव सेल एक चयन ट्रांजिस्टर से सुसज्जित होता है। हालांकि, जैसे-जैसे सेल का आकार छोटा होता जाता है, इन ट्रांजिस्टरों और उनके वायरिंग द्वारा घेरा गया क्षेत्र घनत्व के लिए एक सीमित कारक बन जाता है। 1TnR दृष्टिकोण एक ट्रांजिस्टर को कई सेल को सेवा देने की अनुमति देता है, जिससे प्रति बिट ट्रांजिस्टर का क्षेत्रफल कम हो जाता है; माउंटटाई 2026 चार सेल के लिए एक ट्रांजिस्टर का उपयोग करता है।

एक सामान्य ट्रांजिस्टर का उपयोग कई समस्याओं को जन्म देता है, जिनमें सेल के बीच करंट लीक पथ, पढ़ने और लिखने के दौरान गड़बड़ी, और विभिन्न परिचालन स्थितियों में विश्वसनीयता की समस्याएं शामिल हैं। MemSilicon का दावा है कि उसने नकारात्मक वोल्टेज कॉन्फ़िगरेशन और ऐरे लीकेज को दबाने के लिए मानकीकृत रीसेट स्कीम को लागू करके, उच्च और निम्न वोल्टेज के साथ पढ़ने और लिखने के रास्तों को अलग करने वाले मल्टी-वोल्टेज वर्डलाइन ड्राइवर्स, गलत लेखन को कम करने के लिए अनुकूली सुरक्षा ध्रुवीकरण, और त्रुटि सुधार के साथ मिलकर पढ़ने की उपज बढ़ाने के लिए काम करने वाली एक अनुकूली ट्रैकिंग रीड सर्किट को लागू करके इन समस्याओं का समाधान किया है।

कंपनी की तकनीक डॉ. ल्यू मिन की टीम के काम पर आधारित है, जो चाइनीज एकेडमी ऑफ साइंसेज के अकादमिक हैं और जिन्होंने 2020 में 28nm 1T2R RRAM डिजाइन पर शोध प्रकाशित किया था। चूंकि सेल पीछे की परतों में बनाए जाते हैं जो मानक CMOS के साथ संगत होते हैं, इसलिए यह विधि गैर-वाष्पशील मेमोरी को लॉजिक चिप्स में एम्बेड करने के लिए डिज़ाइन की गई है।

MemSilicon ऑन-चिप AI उपकरणों और AI पीसी के लिए SoC में मॉडल भार, KV-कैश और मापदंडों के लिए ऑनबोर्ड स्टोरेज पर ध्यान केंद्रित कर रही है, जहां SRAM तेज है लेकिन प्रति बिट अधिक जगह लेता है, और लॉजिक प्रक्रियाओं के आकार में घटने के साथ एकीकृत फ्लैश मेमोरी को शामिल करना अधिक जटिल होता जा रहा है।

कंप्यूटर अपग्रेड के लिए अमेज़ॅन पर डीडीआर5 रैम मेमोरी बिक्री पर
और पढ़ें
olhardigital.com.br

कंप्यूटर अपग्रेड के लिए अमेज़ॅन पर डीडीआर5 रैम मेमोरी बिक्री पर

यदि आपके कंप्यूटर या लैपटॉप में अधिक मांग वाले सॉफ़्टवेयर चलाते समय धीमापन आता है, तो रैम मेमोरी बढ़ाने का समय हो सकता है। अमेज़ॅन पर छूट पर तीन डीडीआर5 रैम मेमोरी विकल्पों का चयन किया गया है, जो सभी बिना किसी कठिनाई के अपग्रेड करना चाहने वालों के लिए अच्छी गति और संगतता प्रदान करते हैं।

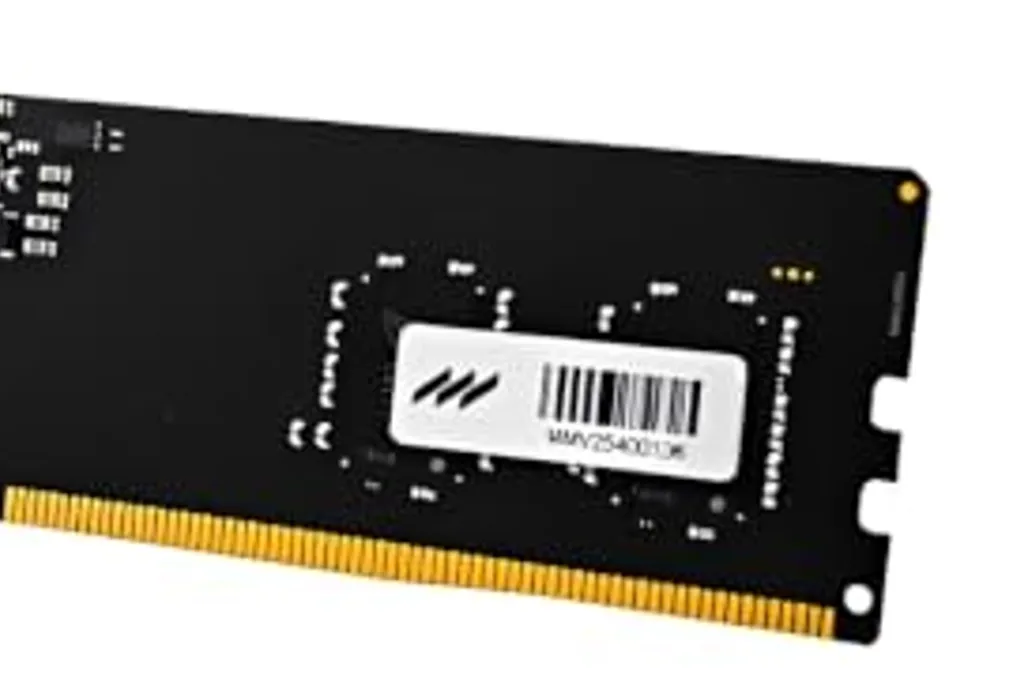
डेस्कटॉप के लिए विकल्प: MACROVIP की DDR5 रैम 8GB 5600MHz

यह विकल्प उन लोगों के लिए आदर्श है जो उच्च स्तर के प्रदर्शन को बनाए रखते हुए डेस्कटॉप की मेमोरी का विस्तार करना चाहते हैं। यह मॉड्यूल, जो DDR5 मानक का पालन करता है और 5600MHz पर संचालित होता है, पिछली पीढ़ियों की तुलना में बेहतर डेटा ट्रांसफर दर प्रदान करता है, जिससे यह दैनिक कार्यों और मल्टीटास्किंग दोनों के लिए एक मजबूत विकल्प बन जाता है।

लैपटॉप के लिए, Adata XPG की एक SODIMM प्रारूप वाली मेमोरी उपलब्ध है, जो केवल 1.1V के कम वोल्टेज पर काम करती है। इसके परिणामस्वरूप ऊर्जा की खपत अधिक कुशल होती है, जो उन लोगों के लिए फायदेमंद है जो बैटरी लाइफ से समझौता किए बिना प्रदर्शन को प्राथमिकता देते हैं। CL46 विलंबता और 5600MHz आवृत्ति के साथ, यह जटिल अनुप्रयोगों में त्वरित प्रतिक्रिया सुनिश्चित करती है।

Adata की DDR5 लाइन का डेस्कटॉप संस्करण उच्च परिचालन आवृत्ति को ऊर्जा दक्षता के साथ जोड़ता है। CL46 और नवीनतम प्लेटफार्मों के साथ संगतता होने के कारण, यह उन लोगों के लिए एक सुरक्षित विकल्प प्रस्तुत करता है जो आधुनिक और उच्च गुणवत्ता वाले घटकों के साथ पीसी बना रहे हैं या अपडेट कर रहे हैं।

यह ध्यान रखना महत्वपूर्ण है कि ये ऑफ़र किसी भी समय समाप्त हो सकते हैं, इसलिए सलाह दी जाती है कि जब तक वे उपलब्ध हों तब तक प्रत्येक उत्पाद की जाँच करें। उपयोगकर्ताओं को लिंक पर जाना चाहिए, विकल्पों की तुलना करनी चाहिए और उस विकल्प का चयन करना चाहिए जो उनकी वर्तमान कॉन्फ़िगरेशन के लिए सबसे उपयुक्त हो, क्योंकि सिस्टम इस अपग्रेड से लाभान्वित होगा।

लोकप्रिय